Column
コラム
AI・生成AI・LLMに関する技術解説、業界動向、実践的な活用ノウハウをお届けします。
Moji が発信するAIの情報を、すべて新着順で読めます。
Grok 4.7とは?Amazon Bedrockでの利用条件・機能・企業向けPoCの始め方
Grok 4.7は、コーディング、エージェントタスク、ナレッジワーク向けに位置付けられているモデルです。Amazon Bedrockのモデルカードでは、 500Kトークンのコンテキスト、テキスト・画像入力、テキスト出力、low/medium/high/xhighのreasoning effort…
Clefとは?Cloudflareの判断モデル・料金とJevとの違い
Clef は、Cloudflareが提供する、分類・選択・採点のための判断モデルです。テキストやJSONと、判断したい質問・候補を渡すと、選択結果や候補ごとの確率を返します。Jevと同系統の判断モデルです。Clefは画像入力、公開重み、Workers AIでの利用にも対応しています。
ループエンジニアリングとは?AIエージェントの反復と終了条件を設計する
ループエンジニアリング とは、AIエージェントが一つの作業の中で行う「観測→判断→実行→検証」の反復について、いつ継続し、いつ保留・失敗・完了させるかを設計することです。本記事では、 エージェントの反復制御を設計する実務上の呼び方 として扱います。
グラフエンジニアリングとは?AI処理の分岐・状態・実行経路を設計する
本記事では、AIアプリケーションの実行経路をノード(処理単位)・エッジ(遷移規則)・状態(共有データ)として設計する活動を、 グラフエンジニアリング と呼びます。分岐、反復、並列処理、再開の経路を整理するための、実務上の呼び方です。
ハーネスエンジニアリングとは?AIエージェントの実行環境を設計する
ハーネスエンジニアリング とは、AIエージェントがタスクを反復して実行し、結果を検証し、途中で停止しても再開できるように、プロンプトの外側にある実行環境を設計する実務です。
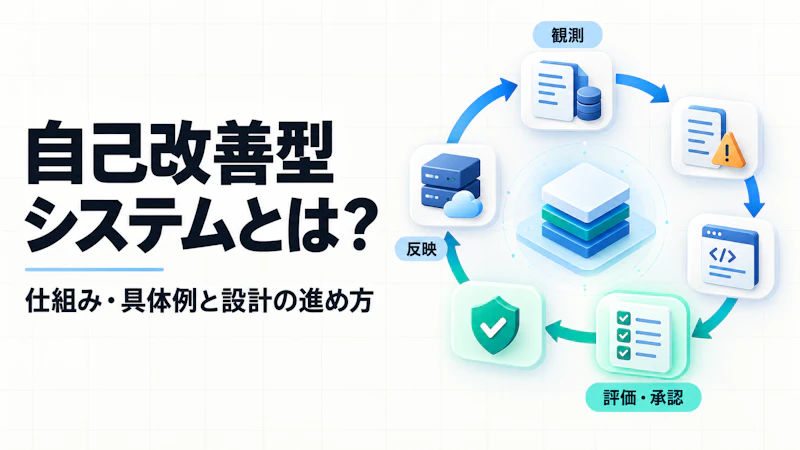
自己改善型システムとは?仕組み・具体例と設計の進め方
自己改善型システム とは、運用中または運用に近い段階で得た失敗ログ、利用者フィードバック、評価結果をもとに改善候補を作り、評価・承認を経て採用した変更だけを本番へ反映し、その結果を次の改善へ残す仕組みです。
OpenAIの「Dots」とは?機能・使い方・注意点を実際に触って検証
OpenAIの「Dots」は、会話を通じて仕事を依頼し、途中で条件を変えながら進められるAIエージェントです。専用のクラウド環境を持ち、調査や資料作成などを行う仕組みとして案内されています。 OpenAI公式概要 では、実際にどこまで任せられるのでしょうか。
 上杉 洸平
Codex Cloudとは?できること・利用条件・企業での安全な試し方を解説
Codex Cloudは、OpenAIが管理するコンピューター上でCodexのコーディングタスクを実行する機能です。リポジトリ、依存関係、ツール、アクセス設定をまとめた「環境」を準備しておくことで、Web・デスクトップ・モバイルからタスクを開始・継続できます。
AIでホワイトカラーの価値はどこに置かれるのか
生成AIの急速な普及を受けて、これまで人間が担ってきたホワイトカラーの仕事が奪われるのではないかという懸念が広がっている。文章作成や情報整理、顧客対応といった知的業務まで、AIが短時間で処理できるようになったためだ。
上杉 洸平
AEOとは?SEOとの違いとAI回答に選ばれる対策
AEOは、検索結果や生成AI、音声検索の回答で、ユーザーの質問への答えとして自社情報が引用・提示されやすくなるよう整える考え方です。SEOは検索結果での上位表示を主な目的とし、AEOは回答の明確さや引用されやすさを重視します。両者の関係と、SEOを土台に進める具体的な対策を解説します。
上杉 洸平
Gemini 4 Argonとは?使い方・料金と導入判断の要点
Gemini 4 Argonは、Googleが正式公開したフロンティアモデルで、企業・開発者は有料APIやGemini platform、個人はPro/UltraのGeminiアプリで利用できます。
上杉 洸平
Tavusとは?GriffinとCVIの仕組み・企業活用
Tavus(タバス)は、リアルタイムの映像・音声対話をアプリケーションへ組み込むためのプラットフォームです。 2026年10月1日に発表されたGriffin(グリフィン) は、相手を見て聞きながら、音声・映像での応答や動きを同時に生成する Human Interaction Model(HIM)…
AIとSIの違いとは?米大統領令で変わること・変わらないこと
SIは、米国政府がAIに代えて使い始めた呼び名であり、大統領令上の定義は従来のAIと同じです。AIからSIへの変更で何が変わるのか、本来のスーパーインテリジェンス、すなわち超知能との違い、日本企業への影響を原文に基づいて整理します。
上杉 洸平
Grok Botの料金はいくら?対象プラン・週次利用枠・追加課金を実機検証とともに解説
Grok Botに単体の月額料金はありません。 2026年10月9日時点で、個人では SuperGrok(月30米ドル) 、または Cursor Pro(月20米ドル) などの対象契約を通じて利用できます。
上杉 洸平
生成AIの社内ルール設計|禁止事項だけにしない許可範囲・権限・承認・人間確認の決め方
生成AIの社内ルールは、「何を禁止するか」だけを決めても、利用者が日々の業務で判断する基準にはなりません。どの業務で、どの情報を入力し、出力をどこまで使え、どの操作で承認を受けるかを、実際の仕事に沿って明確にすることが重要です。
上杉 洸平
【発表1週間で整理】Claude Opus 5.5とGPT-6 Sol・Lunaはどっちを使う?料金・ベンチマーク・用途別の選び方
この記事の結論 (30秒版) 2026年9月22日(米国時間)、AnthropicがClaude Opus 5.5を、OpenAIがGPT-6 SolとGPT-6 Lunaを 同じ日に 発表した。 両社に共通するのは、「前世代より賢い」ではなく 「前世代より安い」 が発表の主語になっていること。
上杉 洸平
OpenAI DevDay 2026まとめ|20超の重要発表と、企業・開発者が今やるべきこと
OpenAI DevDay 2026の要点は、「AIに回答を作らせる」段階から、「権限・承認・実行環境を設計したうえで、継続的な仕事を任せる」段階へ進んだことです。
上杉 洸平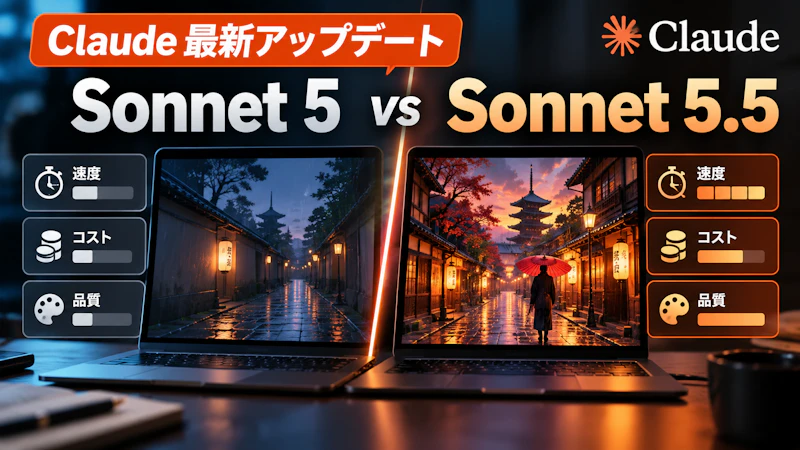
【Claude Sonnet最新アップデート】Claude Sonnet 5.5とSonnet 5を比較(2026年9月版)
Claude Sonnet 5.5とSonnet 5をAPIで実測比較しました(2026年9月29日)。小さいタスクでは 費用−30% ・ 待ち時間−40% 、大きな生成では 費用が1.6倍 でした。
上杉 洸平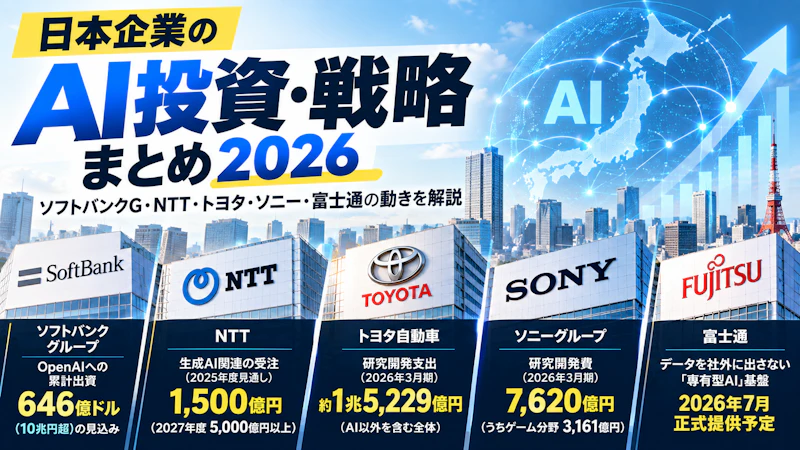
日本企業のAI投資・戦略まとめ2026|ソフトバンクG・NTT・トヨタ・ソニー・富士通の動きを解説
日本企業のAI投資が2026年の重要な経営テーマ になりました。 具体的な数字 :ソフトバンクグループはOpenAIへの出資を重ね、2026年に予定する払い込みを終えると累計出資額は646億ドル(10兆円超)に達する見込みです。
上杉 洸平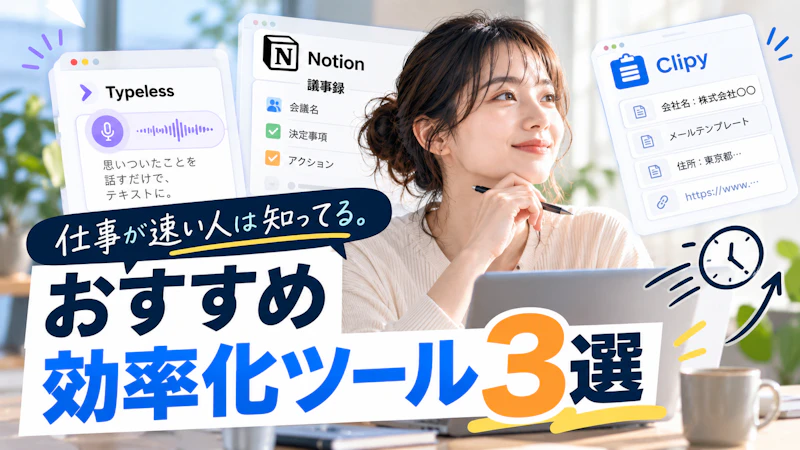
仕事が速い人は知ってる。おすすめ効率化ツール3選【実体験から紹介】
仕事が山積みになって、「もっと時間があればいいのに」と感じたことはありませんか? メールの返信、会議の議事録作成、同じ情報の何度もコピペ——こうした日々の業務は、意外と時間を食います。でも、適切なツールを使えば、これらの作業を劇的に短縮できます。
上杉 洸平
AIで新卒エンジニアの給料・求人倍率は変わった?最新データで見る「狭まる未経験者の入口」
生成AIが指示ひとつでコードを書く時代になりました。これまで若手エンジニアが担ってきたコーディングやテストの一部も、AIで効率化できるようになっています。 「AIがコードを書くなら、企業はもう新卒エンジニアを育てなくていいのでは?
上杉 洸平
「任せる」と「丸投げ」は何が違う?藤田晋氏の会話術を、AIスタートアップのインターン生が読み解く
「自由にやってみて」と言われて、逆に手が止まった経験はないでしょうか。 先に結論を書くと、「任せる」と「丸投げ」の違いは、 ゴールと支援を渡しているかどうか です。
上杉 洸平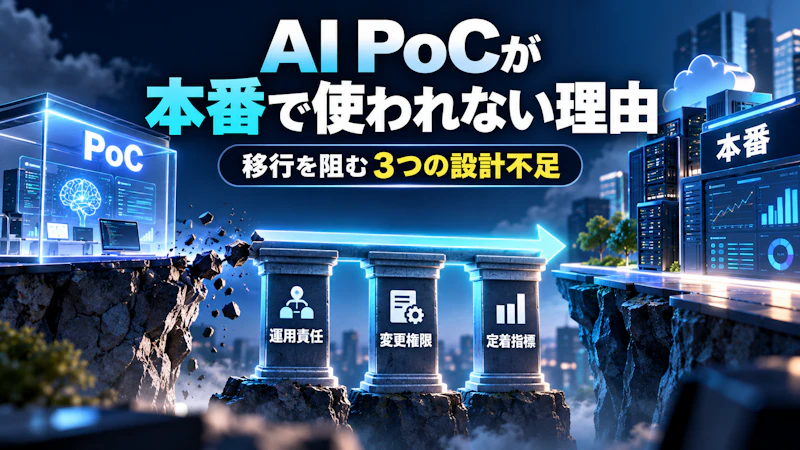
AI PoCを本番化する進め方|開始前の合否基準・KPI・移行ゲート・定着指標
AI PoC(概念実証)で「回答精度は十分」「デモでは動く」という結果が出ても、それだけで本番化できるとは限らず、本番へ移した後も継続して使われるとは限りません。
GPT-6 SolとGPT-5.6 Solの違い|料金・速度・実測比較
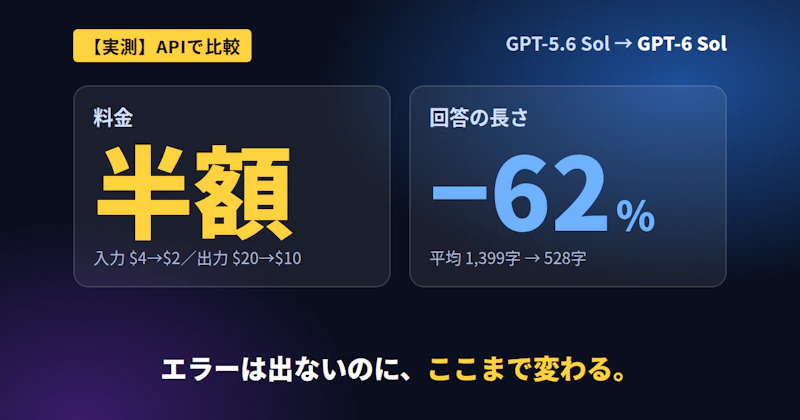
GPT-6 SolとGPT-5.6 Solを、費用・速度・回答の長さ・API互換性で比較します。2026年9月24日にMojiが行った実測と公式資料をもとに、同じリクエストが通るか、出力や設定がどう変わるか、移行前に自社のタスクで何を確かめるかを整理しました。
上杉 洸平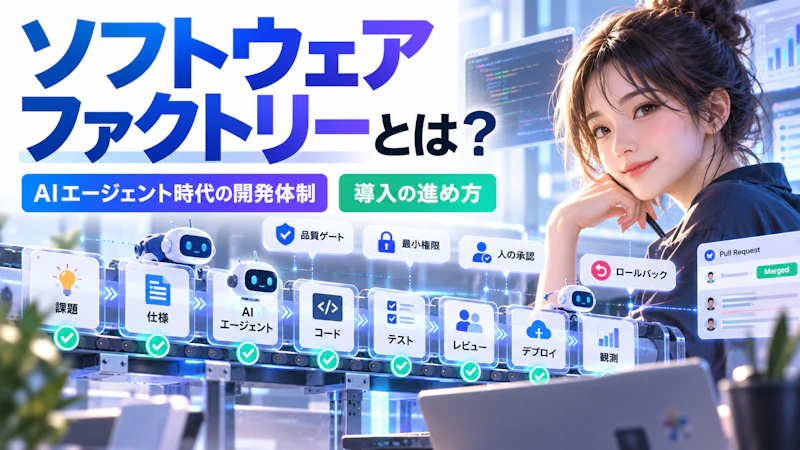
ソフトウェアファクトリーとは?意味・AIエージェント時代の開発体制・導入の進め方
AIコーディングエージェントが、課題の読解、コード変更、テスト実行、プルリクエスト(PR)作成までを支援するようになり、「ソフトウェアファクトリー」という言葉を見聞きする機会が増えています。 ただし、この言葉は文脈によって指すものが異なります。
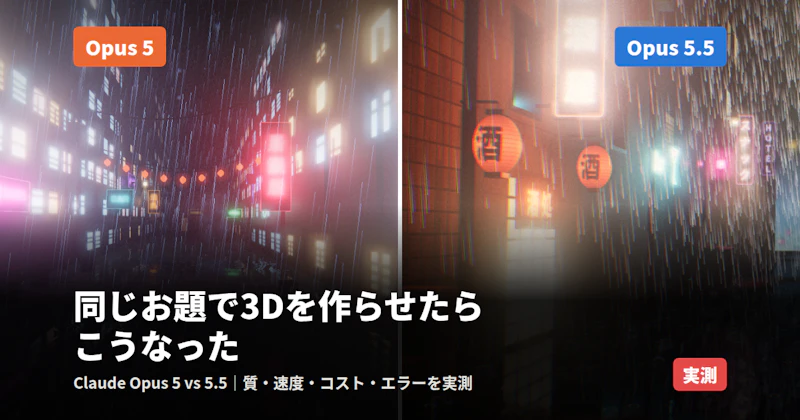
【Claude Opus最新アップデート】Claude Opus 5.5とOpus 5を比較(2026年9月版)
この記事の結論 (30秒版) 比較軸 Opus 5 → Opus 5.5(実測) 質 易しいコード・文章タスクでは差なし(どちらもほぼ全問正解)。3Dシーン生成では お題によって勝ち負けが分かれた 速度 既定設定で約15〜20%速い(6タスク合計 50秒→39秒、3Dシーン3本合計…
上杉 洸平
MetaのMuseとは?Wonder・Wonder Fullとの違いと使い方
MetaのMuseは、ブラウザや接続サービスを使い、調査やフォーム入力、予約、文書作成などを進める個人向けAIエージェントです。Muse Sparkは作業を支えるモデル群で、WonderとWonder Fullはエージェント向けの新モデル系列として発表されています。使い方や安全な権限設定も整理します。
Claude CodeとCodexを「交代勤務」させたら、ひとり開発がチーム開発になった|設計→実装→レビューを2つのAIで回す全手順(初心者向け)
この記事の結論 Claude CodeとCodexは「どちらか」を選ぶものではなく、 同じフォルダで交代勤務 させると一番効く。設計はClaude Code、実装とテストはCodex、レビューは再びClaude Code。
上杉 洸平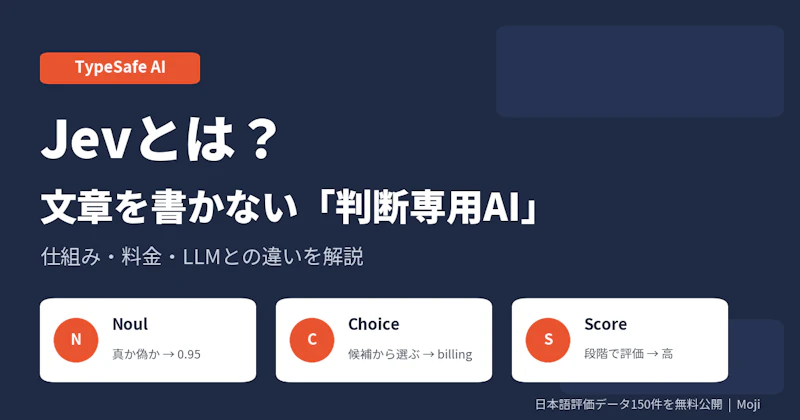
Jev(TypeSafe AI)とは?料金・仕組み・LLMとの違い
Jevは、TypeSafe AIが提供する、文章を生成せず状況に応じた判断を確率つきで返すAIモデルです。分類・振り分け・ガードレールに使われる仕組み、LLMとの違い、料金、公式の性能値と第三者実測の見方、日本語業務で導入前に確かめたい点を解説します。
上杉 洸平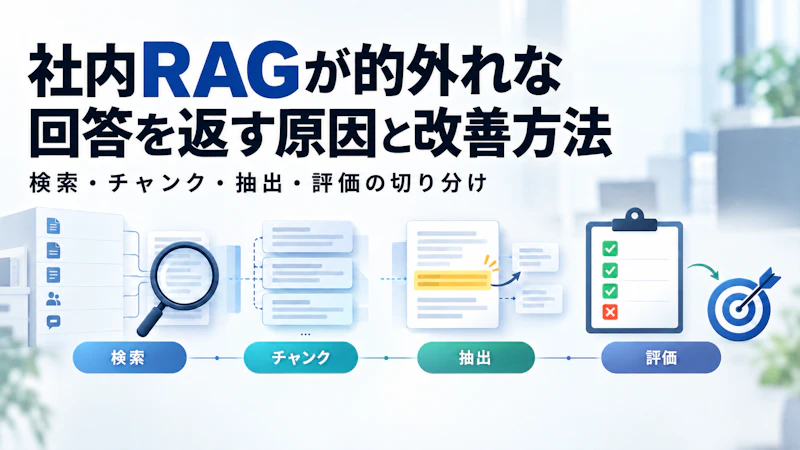
RAGの精度向上はどこから?検索・チャンク・再ランキング・回答生成を切り分ける診断手順
社内RAGの回答精度を上げたいとき、「検索精度が悪い」「LLMが弱い」と一括りにすると、改善が遠回りになりがちです。実際には、元PDFから数値や表ヘッダーを正しく抽出できていない、チャンク化で適用条件が切れている、正解根拠が検索候補にない、候補にはあるが再ランキング後に落ちる…