ループエンジニアリングとは?AIエージェントの反復と終了条件を設計する
Contact
AI活用の相談、まずは無料で承っています
コラムで取り上げたテーマについて、貴社への適用可能性をお気軽にご相談ください。
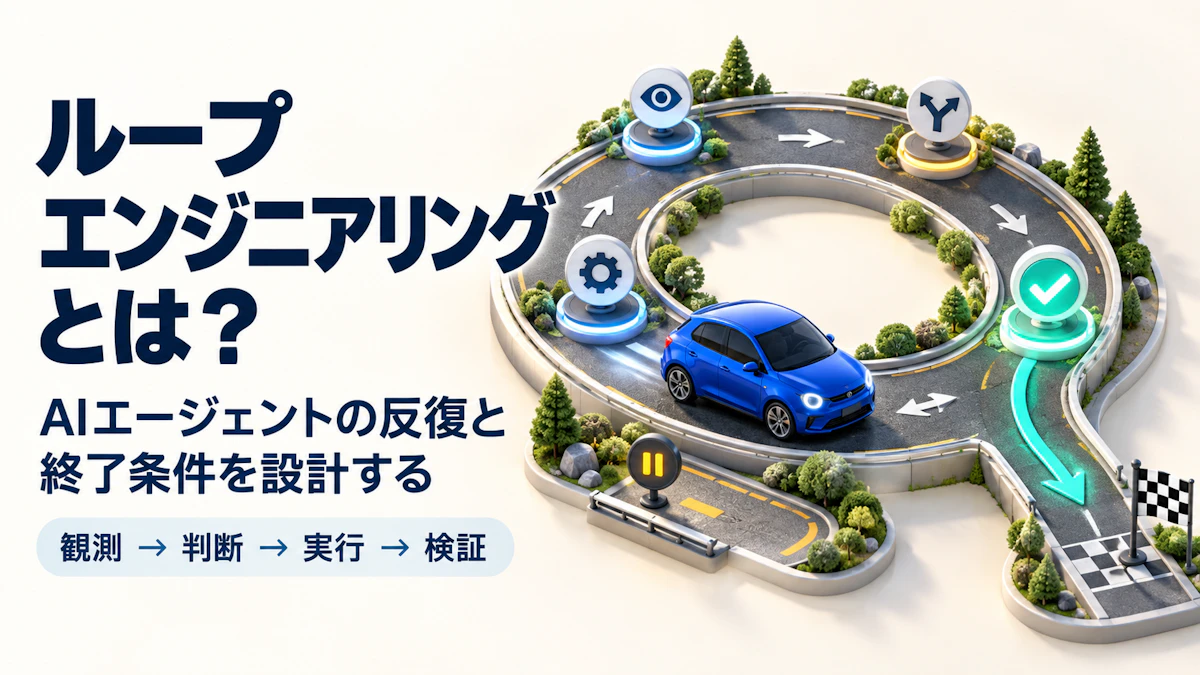
ループエンジニアリングとは、AIエージェントが一つの作業の中で行う「観測→判断→実行→検証」の反復について、いつ継続し、いつ保留・失敗・完了させるかを設計することです。本記事では、エージェントの反復制御を設計する実務上の呼び方として扱います。
重要なのは、モデルが「完了しました」と出力したことを、そのまま業務上の完了とみなさないことです。必要な根拠がそろったか、テストに通ったか、外部システムへの書き込みが反映されたか、人の承認が必要かを、アプリケーション側でも確認します。ここで紹介する分類、手順、設計シートは、特記のない限りMojiによる設計提案です。
ループエンジニアリングとは
エージェントは、必要な手順数をあらかじめ固定しにくい調査、コード修正、例外を含む業務処理などで有用です。一方、手順が決まっている処理は、LLMとツールを事前定義のコード経路で動かすワークフローとして設計した方が、予測しやすい場合があります。Anthropicも、固定経路のワークフローと、LLMがプロセス・ツール利用を動的に方向付けるエージェントを区別しています。Anthropicの解説
本記事の対象は、複数エージェント間のルーティングや、永続ワークフロー全体のグラフ最適化ではありません。対象を「一つの依頼を終えるまでの反復」に限定します。たとえば「競合調査を行い、根拠付きの比較表を作る」「障害報告を確認し、修正案を実装してテストする」といった単位です。
また、モデルへ渡す情報を選び、更新する設計は反復の成否に直結します。検索結果、過去のツール出力、権限、作業中の仮説を無制限に渡すのではなく、各ターンで必要な情報を選ぶ考え方は、コンテキストエンジニアリングで詳しく解説しています。
観測・判断・実行・検証の反復構造
ループを設計するときは、「モデル呼び出しを何回行うか」だけでは不十分です。各ターンで何を受け取り、何を判定し、どの結果なら次へ進むのかを分けます。
- 観測:ツール結果、テスト結果、検索結果、外部APIの応答、承認結果、現在の予算・残り時間を取得する。
- 判断:完了条件を満たしたか、失敗が回復可能か、同じ方針を続ける価値があるかを判定する。
- 実行:検索、ファイル編集、データ取得、下書き作成など、次の操作を行う。
- 検証:実行結果が期待条件を満たしたかを、外部の根拠または明示的な評価規則で確かめる。
OpenAI Agents SDKのPython版では、Runnerがモデルを呼び出し、ツール呼び出しがあればその結果を追加して次のループを実行します。また、テキスト出力がありツール呼び出しがないことを、SDK上の最終出力判定として扱います。これはSDKの実行制御上の規則であり、「必要なソース数を満たした」「更新が反映された」といった業務完了を保証する規則ではありません。OpenAI Agents SDK: Running agents
したがって、本記事では次のように二段階で終えることを提案します。
- ランタイム終了:SDKまたは自作ランタイムが、そのターンの実行を終了する。
- 業務完了:アプリケーションの完了述語が、成果物・根拠・検証・承認の条件を満たしたと判定する。
完了・保留・失敗・上限を分ける終了条件
「終了」を一種類にすると、未完了なのに成功扱いになる、承認待ちを失敗として捨てる、予算切れの原因が追えない、といった問題が起こります。本記事では、終了理由を少なくとも4状態に分けることを提案します。
状態 | 判定の例 | 次の扱い |
|---|---|---|
完了 | 必須項目がそろい、外部検証に通り、必要な承認も済んだ | 成果物と検証記録を保存して終了 |
保留 | 人の承認、追加資料、外部システムの復旧待ちが必要 | 再開に必要な状態を保存し、入力または承認を待つ |
失敗 | 権限不足、必須データ欠落、検証不能、回復不能なツール障害 | 失敗理由・未実行操作・人への引継ぎ内容を出す |
上限到達 | ターン、時間、費用、同一方針の反復回数のいずれかを超過 | 途中成果と打ち切り理由を残し、再計画または人へ引き継ぐ |
最大反復回数のような停止条件を置き、環境から得た結果で進捗を確かめることは、エージェントを制御する基本的な考え方です。Anthropicのエージェント設計ガイドでも、ツール結果やコード実行結果を根拠として進捗を評価し、最大反復回数のような停止条件を置くことが説明されています。
OpenAI Agents SDKのPython版でも、max_turns を超えると例外になり、None を渡すとターン制限を無効化できます。無制限を既定にするのではなく、上限到達を正常な観測可能状態として扱い、保留・失敗・再計画のどれにするかを決めてください。適切な上限値は、モデル、入力品質、評価指標、許容できる遅延・費用によって変わります。OpenAI Agents SDK: Running agents
再試行と方針変更を区別する
反復を管理するため、「一時的な失敗からの回復」と「作業方針が誤っていたことへの対応」を分けます。本記事では、この二つを別カウンターで扱うことを提案します。
- ツール再試行:タイムアウト、一時的な通信失敗、レート制限などに対し、同じ操作を短時間で再実行すること。
- 方針変更:同じ検索語で根拠が得られない、同じテストが改善しない、前提条件が崩れた場合に、検索語・情報源・ツール・分解方法を変える次のエージェントターン。
例えば、HTTP 503への再試行と、「公式資料が見つからないので対象範囲を確認質問へ切り替える」という判断は別です。前者を何度もエージェントに考え直させる必要はありません。後者を同じAPIリクエストとして黙って繰り返しても、進捗は増えません。
さらに、1ターンの中で許す複数ツール呼び出し、SDKがローカル関数ツールを何件同時に動かすか、エージェントの総ターン数も別の制御面です。OpenAI Agents SDKでは、モデルが一つの応答で複数ツールを出せるかを決める設定と、出されたローカル関数ツールの同時実行数を制限する設定が分けられています。OpenAI Agents SDK: Running agents
架空の例:情報収集エージェントの反復を制御する
以下は架空の例です。「ある製品カテゴリについて、独立した一次情報を確認して比較メモを作る」情報収集エージェントを考えます。数値は特定SDKの推奨値ではなく、この例のための提案値です。
完了条件:
- 必須の比較項目がすべて埋まっている
- 各重要項目に一次情報のURLがある
- 引用元の取得日時と確認結果を保存した

上限:
- エージェントターン: 6回まで(架空の例)
- 同一URLの取得再試行: 2回まで(架空の例)
- 同じ検索語での追加検索: 1回まで(架空の例)

進捗なしの判定:
- 新しい一次情報が増えない
- 未充足の比較項目が減らない
- 検証スコアが改善しない

終了:
- 完了条件を満たす → 完了
- 利用者からの追加資料が必要 → 保留
- 重要項目の一次情報が取得不能 → 失敗
- 6ターンでも未充足項目が残る → 上限到達この例で大切なのは、「6ターン使ったから失敗」ではなく、各ターンで未充足項目が減ったかを見ている点です。評価基準が明確で、反復による改善を測れる場合、生成役と評価役を往復させる evaluator-optimizer 型の反復が適します。逆に、何をもって改善とするか決められない作業では、反復数だけ増やしても停止を合理化しにくくなります。Anthropicの evaluator-optimizer の解説
無限ループと二重実行を避ける設計
総ターン上限に加え、進捗のない反復を早めに検出して打ち切る仕組みを用意すると、無駄な実行を減らせます。次の3つを組み合わせるのが本記事の提案です。
- 同一性の検出:同じツール、同じ引数、同じ失敗理由、同じ未充足項目が続くかを記録する。
- 進捗の検出:新しい根拠、テスト成功数、未処理件数、検証スコアなど、タスクに合った進捗指標を置く。
- 方針変更または終了:進捗なしが続いたら、検索語・ツール・分解方法を変える。それでも条件を満たせなければ、理由付きで保留または失敗にする。
外部へ影響する操作では、特に二重実行を避ける必要があります。本記事では、ツール呼び出しID、業務上の冪等性キー、実行済み結果、外部システムでの照合結果を永続化し、再開時に完了済み操作を無条件で実行しないことを提案します。実際に冪等化できるかは、呼び出し先APIが冪等性キーや照合API、トランザクションを提供するかに依存します。
OpenAI Agents SDKの特定のセッション復旧シナリオでは、セッション履歴との照合に成功した場合、完了済みのツール、ガードレール、フック、handoffを再実行しない仕組みが説明されています。ただし、このSDKの挙動だけで、任意の外部APIへの書き込みが安全になるわけではありません。外部操作ごとに副作用の設計を確認してください。OpenAI Agents SDK: Results
メール送信、顧客データ更新、発注、削除などでは、外部操作の権限、必要に応じた人の承認、停止条件を反復制御と合わせて設計します。委任範囲と承認の置き方は、AIエージェントはどこまで任せるべきかも参照してください。
反復制御の設計シート
次の項目を、タスクごとに一枚で埋めることから始めます。これはMojiによる提案テンプレートです。モデルやフレームワークを変えても使えます。
項目 | 記入する内容 |
|---|---|
作業単位 | 何を一回の実行として終えるか。例:指定文書から根拠付き回答を作る。 |
完了述語 | 成果物、外部検証、人の承認のうち、何がそろえば完了か。 |
観測値 | ツール結果、テスト、検索根拠、残り予算、承認状態。 |
進捗指標 | 未充足項目数、テスト通過数、根拠数、評価スコアなど。 |
ツール再試行 | 対象エラー、最大回数、待機、再試行しない条件。 |
方針変更 | 何が起きたら検索語・ツール・分解方法を変更するか。 |
上限 | ターン、時間、費用、同一方針の継続回数。数値はタスク別に検証して決める。 |
副作用対策 | 呼び出しID、冪等性キー、照合方法、承認の有無、ロールバック可否。 |
終了理由コード | 完了、承認待ち、入力待ち、回復不能、上限到達、利用者中止など。 |
実行ログには、少なくとも「ターン番号」「状態遷移」「ツール呼び出しID」「入力の要約」「検証結果」「進捗の有無」「終了理由コード」を残します。OpenAI Agents SDKの結果オブジェクトでも、ツール、handoff、承認に関するメタデータを含む new_items が、ログ、監査、デバッグに適した情報として案内されています。OpenAI Agents SDK: Results
ハーネス・グラフ・自己改善との関係とまとめ
ループエンジニアリングは、反復をいつ終えるかに焦点を当てます。対して、実行環境、ツール契約、状態保存、復旧、観測を含めてエージェントを支える仕組みはハーネスの論点です。複数のノードや条件分岐をどの経路でつなぐかはグラフ設計の論点です。また、評価結果を次回のプロンプト、ツール、モデル、知識、コードの改善へ反映する運用は、自己改善型システムの論点になります。
まずは、1タスクについて「完了の証拠は何か」「進捗なしを何で判定するか」「人を待つときに何を保存するか」「上限到達時に誰へ何を渡すか」を決めてください。反復の出口を設計すると、無駄なターン、説明できない打ち切り、外部操作の重複を減らしやすくなります。
Contact
AI活用の相談、まずは無料で
コラムで取り上げたテーマについて、貴社への適用可能性をお気軽にご相談ください。