自己改善型システムとは?仕組み・具体例と設計の進め方
Contact
AI活用の相談、まずは無料で承っています
コラムで取り上げたテーマについて、貴社への適用可能性をお気軽にご相談ください。
自己改善型システムとは、運用中または運用に近い段階で得た失敗ログ、利用者フィードバック、評価結果をもとに改善候補を作り、評価・承認を経て採用した変更だけを本番へ反映し、その結果を次の改善へ残す仕組みです。
本記事では、自己改善型システムを、評価ケース、プロンプト、知識、実行コードなどのシステム資産を継続的に更新するライフサイクルに範囲を限定します。
要点は「AIが自分で改善案を出せるか」ではなく、何を良い結果とみなすかを先に定義し、悪化を検出して、本番反映を制御できるかです。評価は、指定した内容・形式の基準をモデル出力が満たすかを検証するものとして整理されています。OpenAIの評価ガイド
自己改善型システムとは
自己改善は、モデルが自律的に再学習して重みを更新することだけを意味しません。たとえばReflexionは、モデルの重みを更新せず、言語によるフィードバックをエピソード記憶に残して次の試行へ生かす方式を提案しています。したがって、改善対象はモデルそのものだけではありません。Reflexion原論文
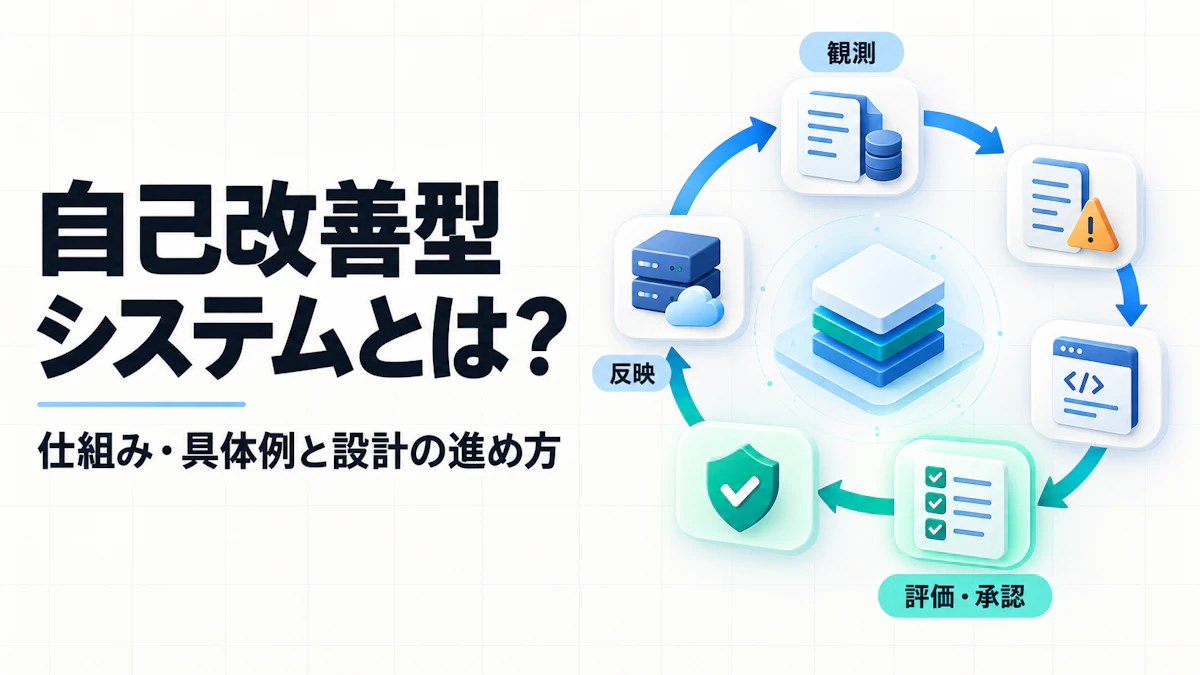
本記事で扱う改善ループは、次の6段階です。
- 観測する:失敗ログ、評価結果、問い合わせ、実行記録を集める
- 失敗を分類する:入力不足、検索漏れ、誤った判断、ツール実行失敗、評価器の誤判定などを分ける
- 改善候補を作る:プロンプト、知識、コード、モデル設定などの変更案を作る
- 隔離環境で評価する:改善したい問題と、既存機能の回帰を両方測る
- 採否を決める:評価値、実行記録、影響範囲、ロールバック方法を確認し、採用条件を満たす変更を選ぶ
- 反映・監視・記録する:本番反映後も観測し、変更理由と結果を残す
この6段階のうち、候補の作成、評価、履歴の記録などは自動化できます。採否を人が確認する半自動の構成もあれば、事前に決めた評価条件を満たす変更を自動反映する構成もあります。後者では、採用条件と停止条件、旧版へ戻す方法を仕組みに組み込む、というのが本記事の設計提案です。
「回答を生成→自己批評→再生成」する手法は、1タスク内の出力を改善する方式です。Self-Refineは、同じLLMが初期出力にフィードバックを与え、反復的に洗練する手法を示していますが、評価データや本番設定を継続更新する運用設計とは分けて考えると混乱を避けられます。Self-Refine原論文
改善する対象はモデル・プロンプト・知識・実行コードで異なる
改善対象によって、検証方法、影響範囲、戻しやすさは変わります。下表は一般的な設計上の目安です。実際の採否は、対象業務、入力品質、モデル、評価指標、許容できる誤差で変わります。
更新対象 | 主な変更例 | 確認したい評価 | 本番反映時の注意 |
|---|---|---|---|
モデル・推論設定 | モデルの切替、温度、出力形式 | 正確性、形式遵守、遅延、コスト | 同じ入力でも振る舞いが変わるため、回帰評価を広く取る |
プロンプト | 指示、例示、出力制約 | 失敗類型ごとの合格率、禁止事項違反 | 一部の入力で旧版より悪化し得るため、差分評価と目視確認を行う |
知識・検索設定 | 文書追加、更新、分割、検索条件 | 根拠の取得率、引用の妥当性、回答不能時の挙動 | 古い文書や権限外の文書を参照していないか確認する |
実行コード・ツール | 分岐、API呼び出し、再試行、権限 | テスト通過、二重実行、外部操作の安全性 | 可逆性、承認、停止条件、ロールバックを先に決める |
LLMへ渡す情報の選択・構成・更新は、プロンプト本文だけでは完結しません。検索結果、会話履歴、ツール実行結果、権限情報を含むコンテキスト全体を設計対象として扱う考え方は、コンテキストエンジニアリングの記事で解説しています。
評価から改善候補を採用するまでの仕組み
本記事の提案は、改善候補の生成と本番反映を別の制御点にすることです。候補作成を自動化しても、評価を通さずに本番設定・知識・コードを自動変更する必要はありません。
- 期待する振る舞いを書く
入力、期待出力、失格条件、確認可能な根拠を定義します。「丁寧に答える」のような曖昧な表現だけでは、評価の一致が難しくなります。 - 能力評価と回帰評価を分ける
能力評価は「今回直したい失敗が改善したか」、回帰評価は「以前できたことを壊していないか」を測ります。Anthropicは、この二つを分け、改善と後退防止を並行して確認する考え方を示しています。Anthropicの評価設計ガイド - 失敗類型に対応した評価器を置く
ラベル一致やJSON形式のように機械判定できるものは決定的な評価器を優先します。自由記述の妥当性などはLLM評価器を補助的に使えますが、人手評価との較正が必要です。評価器が不当に正解を落としていないか、実行記録も確認します。Anthropicの評価器選定・較正の説明 - 候補ごとに旧版と新版を比較する
全体平均だけで採否を決めず、失敗類型、重要度、未評価ケース、処理時間、外部操作の有無を並べます。 - 採用した変更を段階的に反映する
影響が小さく戻しやすい変更から限定反映し、異常時には旧版へ戻せる状態を保ちます。
プロンプトの最適化についても、OpenAIは本番利用前に評価と手動レビューを行うよう案内しています。最適化後のプロンプトが特定の入力で元より悪化する可能性があるためです。OpenAI Prompt optimizerガイド
架空の例:問い合わせ分類の失敗から評価ケースを追加する
以下は、顧客情報を含まない架空の例です。問い合わせを「請求」「障害」「契約変更」に分類し、緊急度も返すシステムを想定します。
失敗ログID「INC-042」で、「請求額が二重に計上されている」という入力が「契約変更」に誤分類されたとします。このとき、すぐにプロンプトを長くするのではなく、次の順で切り分けます。
- 入力文に「二重請求」を判断する情報が十分にあるか確認する。
- 期待ラベルを「請求」、緊急度を「通常」とし、根拠語句を定義する。
- 旧版の出力、検索した文書、LLMへ渡した文脈、最終判定を保存する。
- 「請求関連だが契約変更にも見える表現」の評価ケースを追加する。
- 変更案A(分類基準の例示追加)と変更案B(検索するFAQの追加)を別々に評価する。
- 能力評価でINC-042群が改善しても、既存の「契約更新」「解約」評価群が悪化していないか確認する。
- 採用時は変更IDを付け、旧版へ戻す条件を決めてから限定反映する。
実運用の失敗をテストケースに変換すると、評価セットを実際の利用状況に近づけられます。評価セットは最初から網羅的である必要はなく、Anthropicは実際の失敗から得た20〜50件程度の単純なタスクから始める実践的な目安を示しています。ただし、必要件数は業務の重要度や失敗のばらつきで変わり、普遍的な合格基準ではありません。Anthropicの初期評価セットに関する説明
改善が逆効果になる原因と切り分け
- 評価データへの過適合:既知の失敗だけに合わせ、未評価の言い回しや業務条件で悪化する。
- 評価器の誤判定:正しい処理を不合格にする、または危険な出力を通す。LLM評価器だけに依存せず、代表ケースを人が確認する。
- 複数変更を同時に入れる:モデル、プロンプト、検索、コードを一度に変えると、改善・悪化の原因が分からない。
- 平均値だけを見る:重要度の高い失敗が悪化していても、全体平均では隠れる場合がある。
- 本番ログをそのまま評価に使う:個人情報、機密情報、偶発的な入力条件を含む可能性がある。利用目的と取り扱いルールを確認し、必要最小限の情報に整える。
とくに、LLMを評価器に使う場合は「評価器が合格と言ったから正しい」とは扱えません。モデルベース評価器は柔軟な一方で非決定的であり、人手評価との較正が必要とされています。Anthropicのモデルベース評価器の注意点
変更履歴と採否を残す改善シート
次の改善シートはMojiによる設計提案です。スプレッドシート、チケット管理、GitのPRテンプレートなど、既存の運用に合わせて実装してください。
項目 | 記録する内容 |
|---|---|
変更ID・日時・担当 | 変更を一意に追跡できる情報 |
更新対象・旧版・新版 | モデル、プロンプト、知識、コードのどこをどう変えたか |
失敗ログID・失敗類型 | 改善の発端と、入力不足・誤分類・検索漏れなどの分類 |
追加した評価ケース | 入力、期待結果、失格条件、重要度 |
能力評価・回帰評価 | 旧版/新版の結果、比較条件、未評価の範囲 |
目視レビュー | 確認者、実行記録、評価器の誤判定有無 |
採否・採否理由 | 判断者、採用しない理由、次に調べる仮説 |
反映範囲・ロールバック条件 | 限定反映の対象、停止指標、戻す版 |
このシートの目的は、変更の正当化ではありません。「なぜ変更したのか」「どの評価で良いと判断したのか」「後で悪化したときにどこへ戻るのか」を追跡可能にすることです。
小さく始める手順とチェックリスト
最初から自己修正・自動本番反映まで作る必要はありません。まずは、変更を人が実施する半自動の改善ループから始める方が、評価器や失敗分類の品質を確かめやすくなります。
- 対象業務を1つに絞る。正解・不正解、または失格条件を定義できる業務を選ぶ。
- 過去の失敗から少数の評価ケースを作る。実データを扱う場合は、利用目的と情報管理の条件を確認する。
- 能力評価と回帰評価を分ける。どちらか一方だけで採否を決めない。
- 変更対象を1つに限定する。プロンプトと検索設定のように原因候補が複数ある場合は、別々の変更として比較する。
- 改善候補は隔離環境で比較し、採否と理由を記録する。
- 本番は限定反映から始め、停止条件と旧版への戻し方を事前に確認する。
開始前チェックリスト
- 何を更新対象にするかを、モデル・プロンプト・知識・コードに分けて書いたか
- 改善したい失敗と、絶対に悪化させたくない既存機能を分けたか
- 各評価ケースに期待結果と失格条件があるか
- 評価器の結果を人が見直す対象と頻度を決めたか
- 候補作成と本番反映の権限を分けたか
- 変更ID、採否理由、ロールバック条件を残せるか
まとめ
自己改善型システムでは、失敗を評価可能なケースへ変え、改善候補を旧版と比較し、回帰を確認したうえで、採用条件を満たす変更を反映するという一連の仕組みを設計します。
まずは、更新対象を一つに絞り、失敗ログから評価ケースを作り、能力評価・回帰評価・採否履歴を揃えてください。この土台があれば、モデル変更、知識更新、プロンプト改善、実行コードの変更を、同じ改善ループの中で比較・管理しやすくなります。
Contact
AI活用の相談、まずは無料で
コラムで取り上げたテーマについて、貴社への適用可能性をお気軽にご相談ください。