【Claude Opus最新アップデート】Claude Opus 5.5とOpus 5を比較(2026年9月版)
DX推進
生成AIの社内定着・業務効率化のご相談を承っています
戦略策定から現場研修まで、Mojiが一貫して支援します。

Kohei Uesugi
株式会社Moji ビジネス開発・コンテンツマーケティング担当 鹿児島県出身。大学2年次から複数のスタートアップで長期インターンを経験し、営業・事業開発と0→1の立ち上げに携わる。2026年9月より、生成AI特化の開発会社・株式会社Mojiに参画。AI開発プロジェクトの事業開発と運営体制づくりを担当しながら、自社メディアのコンテンツ運用をリードしている。
この記事の結論(30秒版)
比較軸 | Opus 5 → Opus 5.5(実測) |
|---|---|
質 | 易しいコード・文章タスクでは差なし(どちらもほぼ全問正解)。3Dシーン生成ではお題によって勝ち負けが分かれた |
速度 | 既定設定で約15〜20%速い(6タスク合計 50秒→39秒、3Dシーン3本合計 25.4分→21.7分) |
コスト | 既定設定で約25%安い(ただし多くは effort 既定値の引き下げによる)。 |
エラー | 4つの変更が400エラーになる。さらにエラーを出さずに挙動が変わるものが4つある |
- Claude Opus 5.5 は Opus 5 より安く(入力 $5→$4、出力 $25→$20/100万トークン)、速いモデルです。ただし、モデルIDを書き換えるだけでは移行は終わりません。
- 公式の「破壊的変更」は4つです。どれも400エラーになるので、開発環境で一度動かせば見つかります。私たちも実際にAPIを叩き、全パターンのエラー文言を確認しました。
- 本当に危ないのは、エラーを出さずに挙動だけが変わる4つです。実測では次のようになりました。
・effort を指定しない呼び出しは、Opus 5.5 では
mediumで動きます。既定値同士で比べると、費用は約25%減、時間は約22%減でした(同じ6タスク)。ただしその多くは、effort の既定値が下がったことによるものです。・effort を
maxにすると、xhighの約10倍のトークンを消費しました。簡単な関数1つに36,641トークン、約5分かかり、テスト結果はlowと同じ(どちらも合格)でした。・何も指示しないと、ツールを呼ぶ前の「〇〇を調べます」という一言が毎回消えました(Opus 5.5 のツール呼び出し30回すべて)。システムプロンプトに1行足すと、毎回出るようになりました。
・拒否はHTTP 200・本文が空で返ってきます。ステータスコードだけを見ていると「成功」に見えます。
- この記事では、公式移行ガイドの内容を「エラーになる/ならない/測り直す」の3つに並べ替え、実測結果・コード例・影響箇所スキャナつきのチェックリストにまとめました。
※本記事は2026年9月24日時点の Anthropic 公式ドキュメントと、同日の実測に基づきます。 新モデルの概要や GPT-6 との比較は、Claude Opus 5.5とGPT-6 Sol・Lunaの比較をご覧ください。
- 他のClaude関連の記事はこちら!
この記事の検証について
公式ドキュメントを読むだけでは、「実際にどんなエラーが返るのか」「effort を変えると費用がいくら変わるのか」は分かりません。そこで、株式会社MojiのAI開発チームが Claude API を実際に呼び出して確かめました。
項目 | 内容 |
|---|---|
実施日 | 2026年9月24日(Opus 5.5 公開の2日後) |
環境 | Claude API(Anthropic 直接)、Python から HTTP で直接呼び出し |
比較対象 |
|
検証内容 | ① エラー再現 23パターン ② 会話履歴の編集 9パターン ③ effort 別の品質・費用・時間(自動採点の6タスク)④ ツール呼び出し前の表示(4条件) ⑤ ツール強制指定の置き換え(問い合わせ20件×4条件) ⑥ 業務依頼が誤って拒否されないか(13種×2回×2モデル) ⑦ 3Dシーン生成による見た目の質(3お題×2モデル) |
費用 | 合計 約$12〜14(うち3Dシーン生成が約$6〜9) |
限界もあります。 各条件の試行回数は1〜3回と少なく、タスクも比較的易しいものです。数字は「傾向を見るための参考値」として読んでください。自社の判断には、第6章の手順で自社のタスクを使って測ることをおすすめします。検証の詳細は付録Bにまとめています。
1. 同じお題で3Dシーンを作らせた:Opus 5 vs Opus 5.5
「新しいモデルは本当に良くなったのか」を一番分かりやすく確かめるために、ブラウザで動く3Dシーンを両モデルに作らせて並べました。
条件(公平にするために決めたこと)
- お題は3つ:日本庭園/雨の夜の路地/太陽系
- 1つの HTML ファイルで完結させ、形はすべてコードで作る(画像や3Dモデルのファイルは使わない)。Three.js(r160)を使用
- effort は両モデルとも既定値(Opus 5 は
high、Opus 5.5 はmedium)。移行した人が、設定を変えずに体験する差です - 1回目の出力をそのまま、ページを開いて6秒後の画面を撮影。良い結果だけを選ぶことはしていません
- 6本とも、ブラウザのエラーなく動きました
1-1. 雨の夜の路地:Opus 5.5 の作り込みが明らかに上
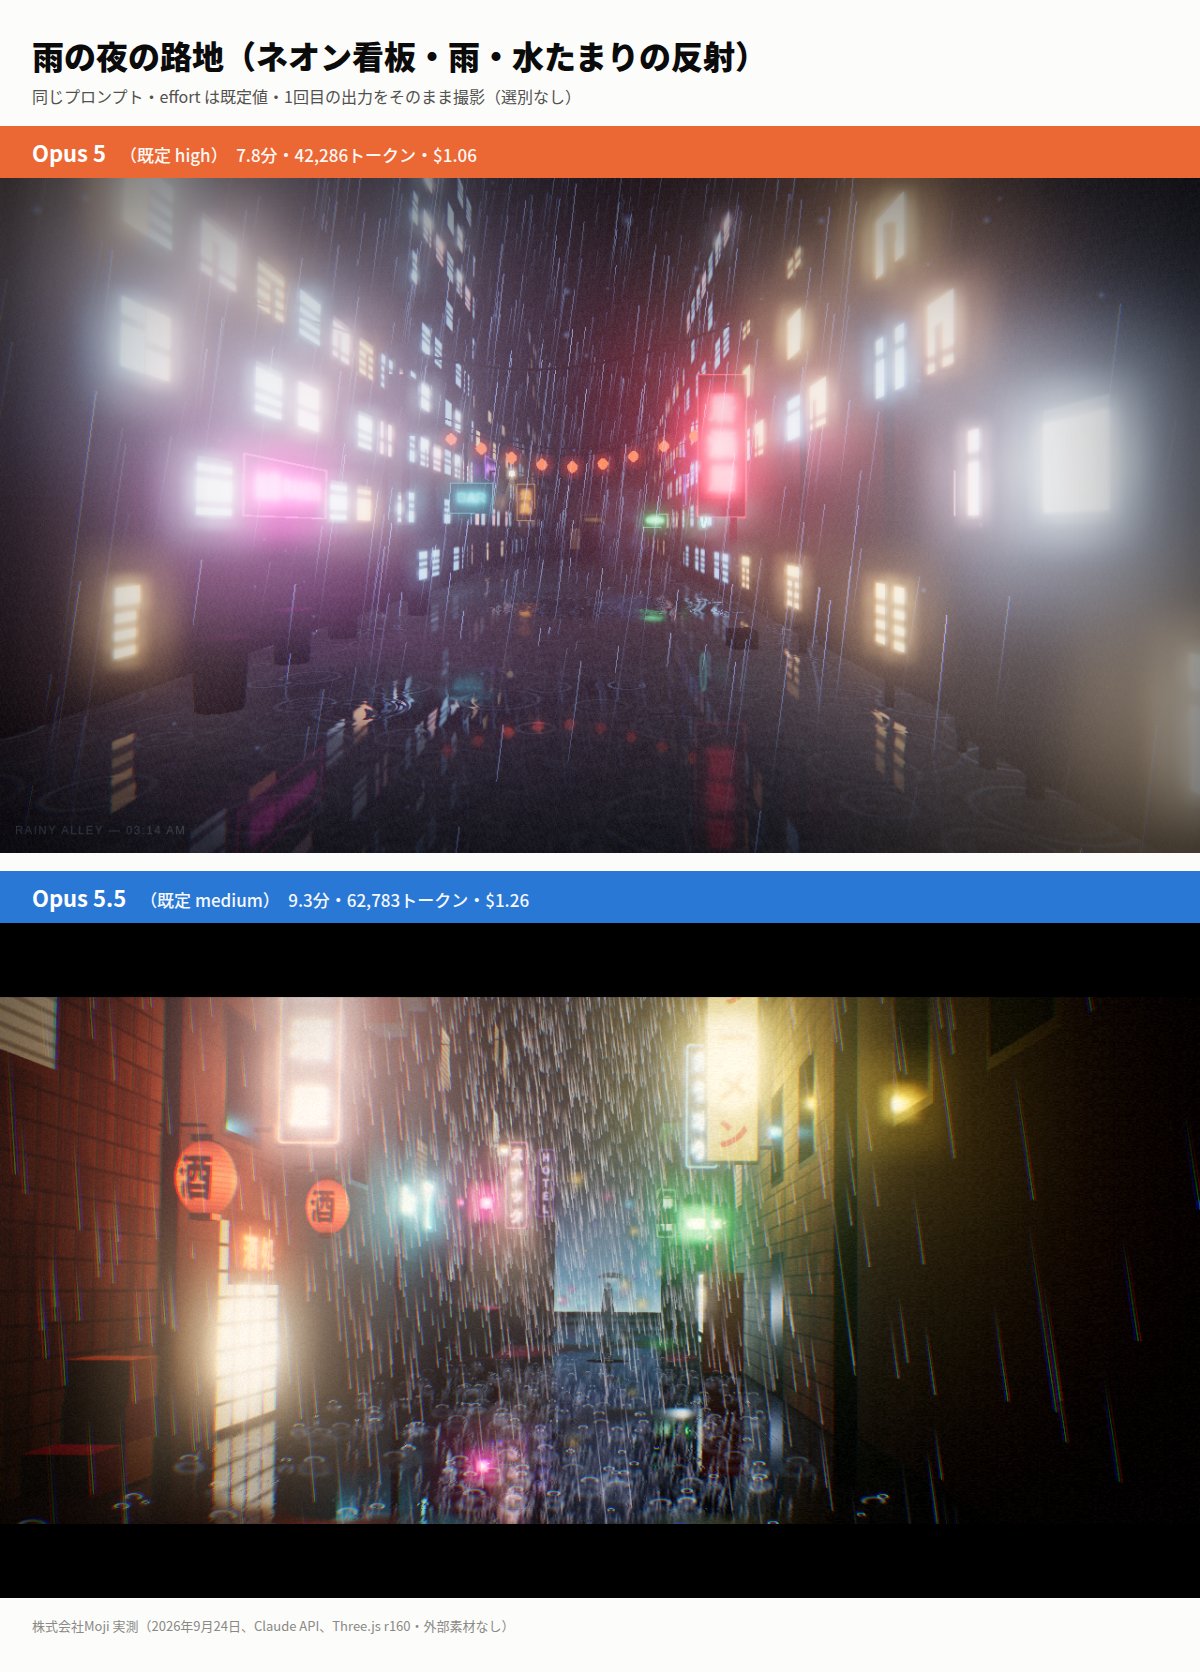
- Opus 5:霧とネオンの光が強く、全体がぼやけた印象。ビルの窓明かりが並ぶ、抽象的な街並み
- Opus 5.5:「酒」の提灯、縦書きの看板、レンガの壁、路面ではねる雨粒、映画のような上下の黒帯。「路地」らしさの作り込みがはっきり上でした
- 生成は Opus 5.5 のほうが長く(9.3分 vs 7.8分)、費用も高めでした($1.26 vs $1.06)。書いたコードの量が多かったためです
1-2. 日本庭園:光の Opus 5、細部の Opus 5.5
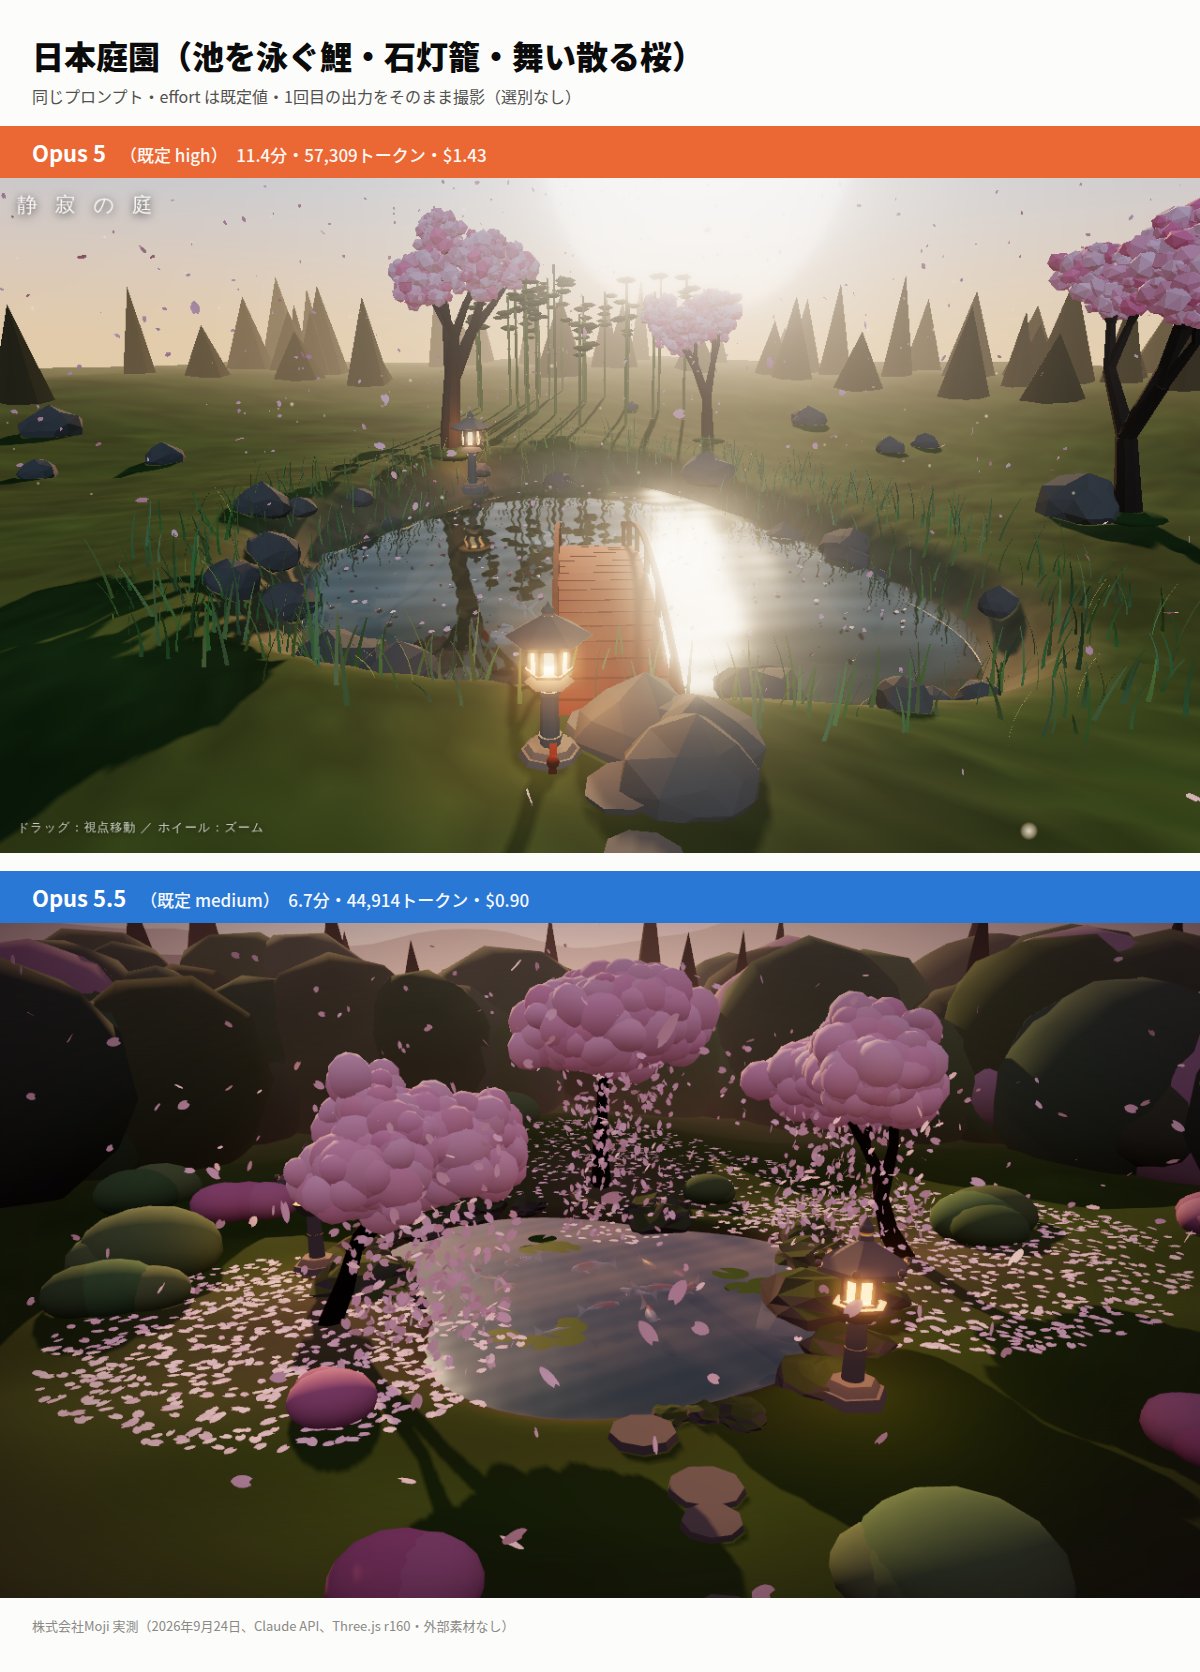
- Opus 5:木の橋、池に反射する日の光、細い竹の木立。光の演出が印象的で、一枚絵としての完成度が高い
- Opus 5.5:池を泳ぐ鯉が見え、地面に花びらが積もり、飛び石や丸く刈り込んだ植栽もある。お題の要素を細かく作り込んでいる
- どちらが上かは好みが分かれます。ただ、Opus 5.5 は約4割短い時間(6.7分 vs 11.4分)、約4割安い費用($0.90 vs $1.43)で同等の完成度に届いています
1-3. 太陽系:最初の見え方は Opus 5 が上
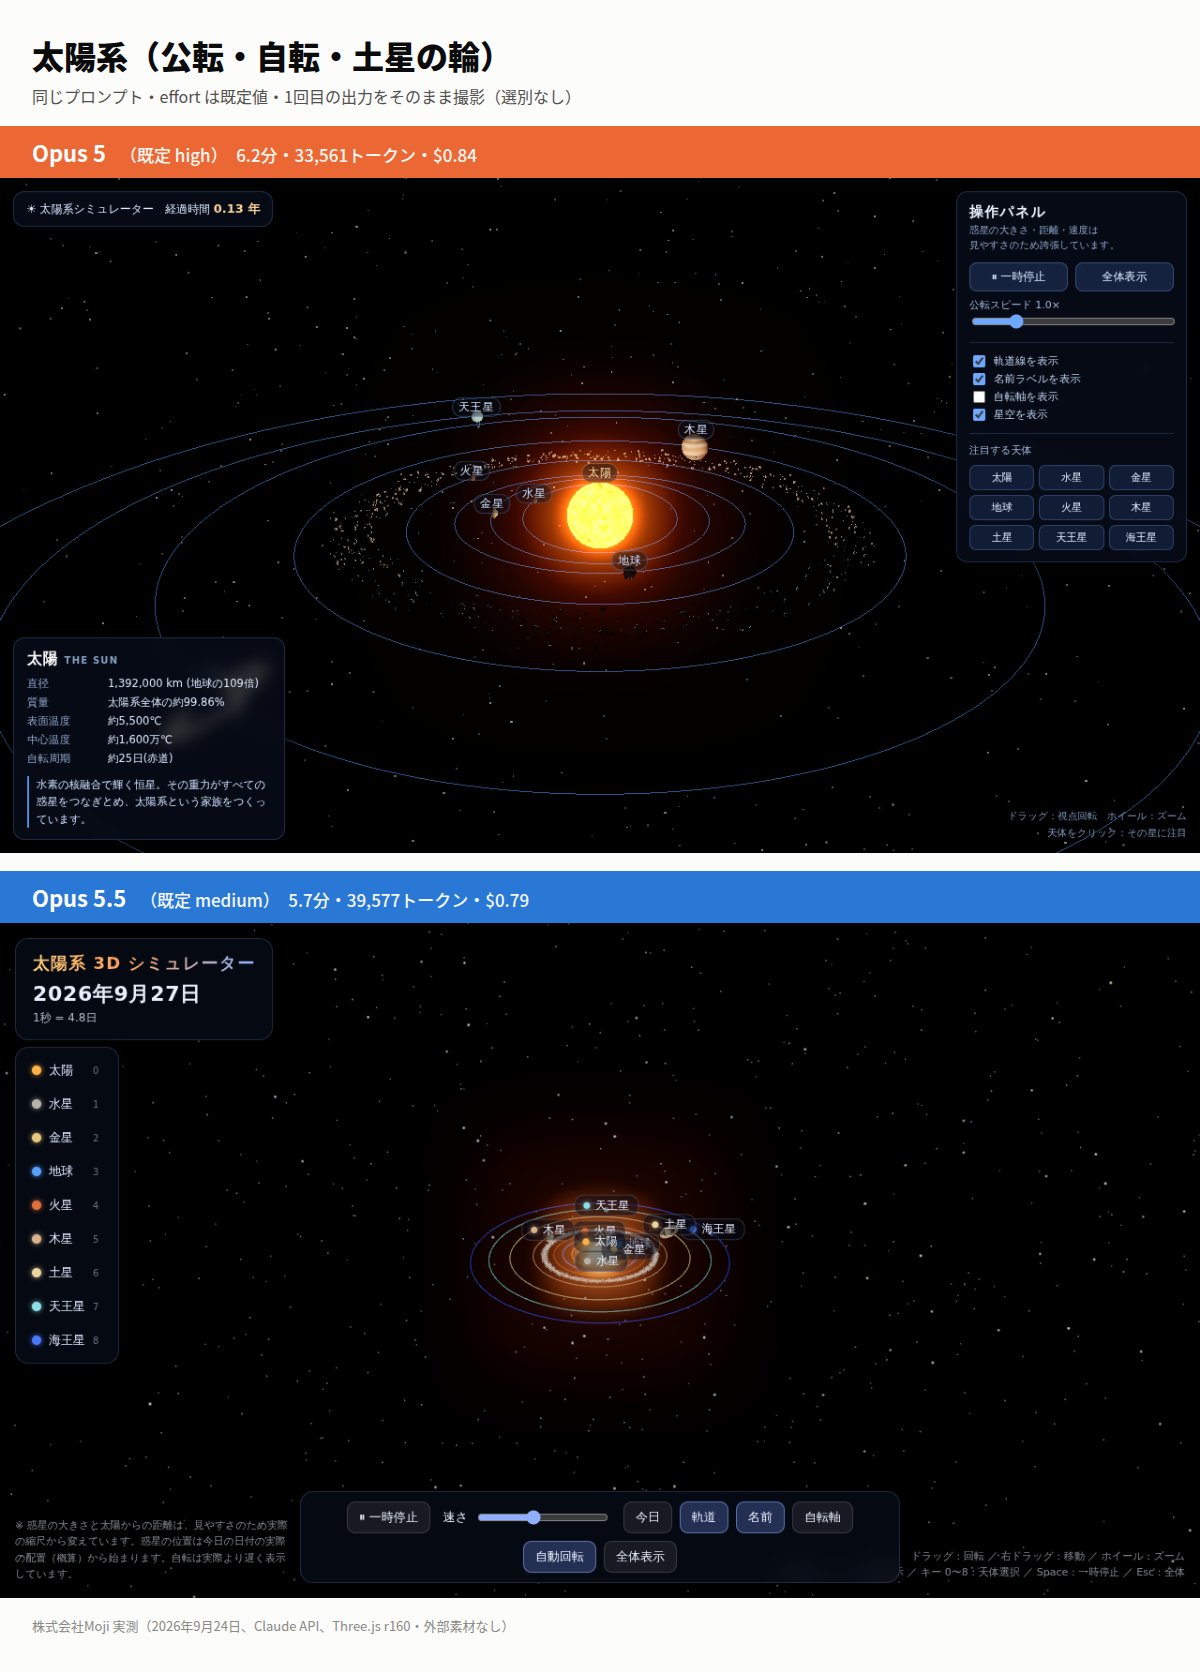
- Opus 5:開いた瞬間に惑星と名前が大きく見え、太陽の解説パネルも表示される。教材として分かりやすい
- Opus 5.5:惑星一覧、日付表示、操作ボタンなど機能は多いが、初期のカメラが遠く、惑星が小さい。最初の印象では負けています
- 生成時間と費用はほぼ同じでした(5.7分・$0.79 vs 6.2分・$0.84)
1-4. 3本を通して言えること
Opus 5(既定=high) | Opus 5.5(既定=medium) | |
|---|---|---|
見た目の評価 | 太陽系で勝ち、庭園は互角 | 路地で勝ち、庭園は互角 |
生成時間(3本合計) | 25.4分 | 21.7分 |
費用(3本合計) | $3.33 | $2.95 |
動作エラー | なし | なし |
- 「5.5 のほうが常に上」ではありません。 お題によって勝ち負けが分かれました
- ただし Opus 5.5 は、effort が一段低い既定値のまま、Opus 5 と同等以上の作り込みを、合計で短い時間と少ない費用で出しています。公式の「Opus 5.5 の
mediumは Opus 5 のhighと同等以上」という説明とも合う結果です - 太陽系の「カメラが遠い」のような細部の判断ミスは、モデルを変えても起きます。 移行後も、出力を人が確認する工程は必要です
- 3Dシーンのような大きな生成は、1本で3〜6万トークン、$1前後かかりました。大きな生成物を作らせる用途では、1回あたりの費用の上限を決めておくことをおすすめします
各お題1回ずつの比較なので、「傾向」として読んでください。この先の章では、見た目では分からない速度・コスト・エラーの違いを、移行チェックリストの形で整理します。
2. 質・速度・コストを比べる:そもそも移行すべきか
2-1. 料金と基本スペック
Opus 5 を本番で使っているなら、移行する経済的な理由は十分にあります。
項目(100万トークンあたり) | Opus 5 | Opus 5.5 |
|---|---|---|
入力 | $5 | $4 |
出力 | $25 | $20 |
キャッシュ書き込み(5分/1時間) | $6.25/$10 | $5/$8 |
キャッシュ読み込み | $0.50 | $0.20 |
バッチ処理(入力/出力) | $2.50/$12.50 | $2/$10 |
コンテキスト/最大出力 | 100万/12.8万 | 100万/12.8万 |
知識のカットオフ | 2026年5月 | 2026年6月 |
提供終了(予定) | 2027年7月24日以降 | 2027年9月22日以降 |
2-2. 質:易しいタスクでは差が出なかった
第5章⑤で詳しく書きますが、Python の関数3問、数え上げ1問、請求書からのデータ抽出1問、条件つきのメール作成1問を自動採点したところ、両モデルとも、どの effort でもほぼ全問正解でした(不正解は Opus 5 の low で文字数制限を1字超えた1件のみ)。
日常的なコード生成や文章作成のレベルでは、「5.5 にすると賢くなる」と体感できる差はない、というのが正直な結果です。差が出るとすれば、もっと大きく、作り込みが問われるタスクです。その比較が第1章の3Dシーンです。
2-3. 速度とコスト
Anthropic は「既定の設定で、一般的なワークロードでは Opus 5 より40%安い」としています。ただし、表示価格そのものの値下げは約2割です。残りは、キャッシュ読み込みの6割値下げ(公式によれば、エージェントやコーディング用途では費用の大半をキャッシュ読み込みが占める)や、後述する effort の既定値が high から medium に下がった効果などによるものです。
実際、私たちが同じ6タスクを「どちらも effort を指定しない(=既定値)」で流したところ、結果は次のとおりでした。
Opus 5(既定=high) | Opus 5.5(既定=medium) | 差 | |
|---|---|---|---|
正解数 | 6/6 | 6/6 | — |
出力トークン | 4,195 | 3,892 | −7% |
費用 | $0.111 | $0.082 | −25% |
合計時間 | 50秒 | 39秒 | −22% |
出力トークン数を応答時間で割った値(出力500トークン以上の応答の中央値。Opus 5 は7件、Opus 5.5 は28件)も、Opus 5 の毎秒89トークンに対して Opus 5.5 は毎秒107トークンと、約2割速くなっていました(並列実行下での参考値。公式は「出力の生成が30%以上速い」としています)。
ただし、この差の多くは effort の既定値の違いから来ています。同じ medium 同士で比べると、Opus 5.5 は費用が約11%減、時間が約13%減で、出力トークンはむしろ約11%増えていました(第5章⑤)。
一方で、移行の手間は「IDを書き換えるだけ」ではありません。以下、影響の出方で3つに分けて整理します。
3. 全体像:8つの変更を「エラーになるか」で分ける
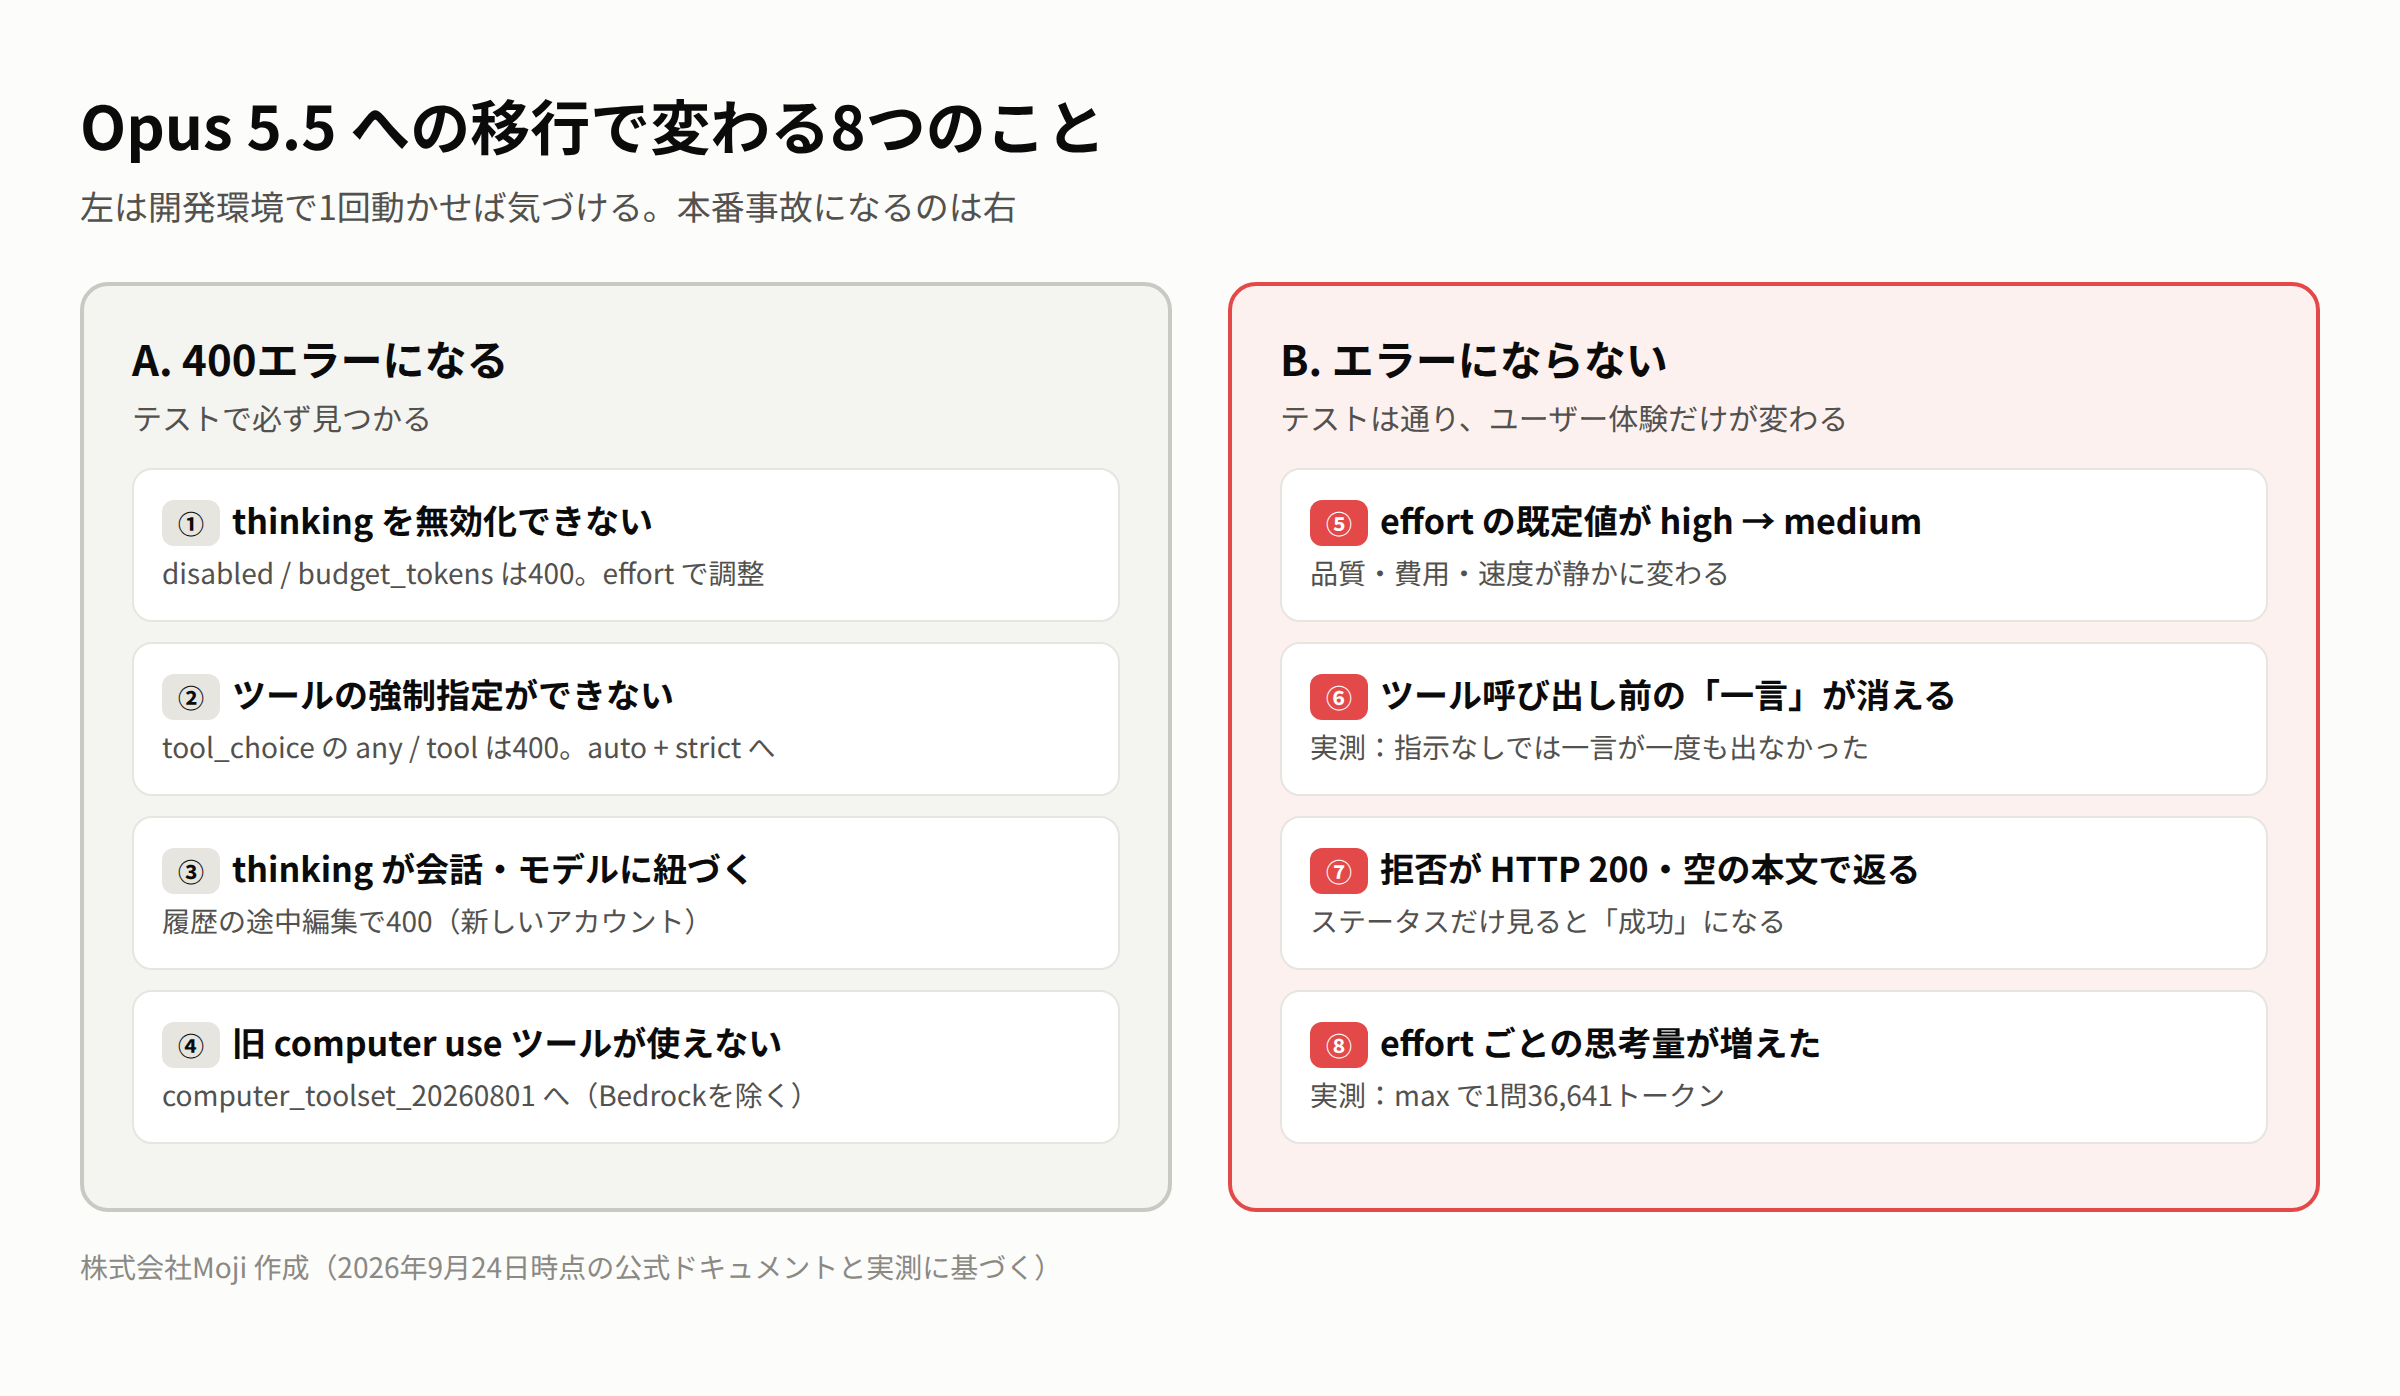
区分 | 変更 | 気づき方 |
|---|---|---|
A. 400エラーになる | ① thinking を無効化できない | 開発環境で即エラー |
② ツールの強制指定( | 同上 | |
③ thinking ブロックが会話・モデルに紐づく | 会話履歴の途中編集時にエラー(アカウントによる) | |
④ | 開発環境で即エラー | |
B. エラーにならない | ⑤ | 気づかない。品質とコストが静かに変わる |
⑥ ツールを呼ぶ前の「一言」が消える | 気づかない。画面が無言になる | |
⑦ 拒否(refusal)が HTTP 200 で返る | 気づかない。空の回答がユーザーに出る | |
⑧ effort ごとの思考量が増えた | 気づかない。 |
A の4つは、開発環境で一度通せば必ず見つかります。本番事故になるのは B の4つです。 テストは通り、エラーログもきれいなまま、ユーザーの体験だけが変わります。
4. チェックリスト A:400エラーになる4つの変更
① thinking を無効化できない
Opus 5.5 では適応的思考(adaptive thinking)が常にオンで、止められません。
実測:返ってきたエラー
thinking: {"type": "disabled"}を送ると:"thinking.type.disabled" is not supported for this model. Use "thinking.type.adaptive" and "output_config.effort" to control thinking behavior.
移行ガイドには thinking: {"type": "enabled", "budget_tokens": N} も400になると書かれています。実際に試したところ、この書き方は Opus 5 の時点ですでに400でした。Opus 5 で動いているコードにこの書き方が残っていることはないはずなので、Opus 5 からの移行で問題になるのは disabled のほうです。
なお Opus 5 では、disabled は effort が high 以下のときだけ使えました(xhigh と組み合わせると400)。「速さ優先で thinking を切っていた処理」がある場合、それがそのまま Opus 5.5 では動かない箇所です。
対応:thinking の指定を削除(または {"type": "adaptive"})し、考える量は output_config.effort で調整します。
python
# Before(Opus 5)
client.messages.create(
    model="claude-opus-5",
    max_tokens=16000,
    thinking={"type": "disabled"},
    messages=[...],
)

# After(Opus 5.5)
client.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    output_config={"effort": "low"},  # thinking は常にオン。量は effort で調整
    messages=[...],
)
公式のプロンプトガイドは、thinking を切って使っていた処理について「まず low から始め、品質が落ちたら medium に上げる」ことを勧めています。システムプロンプトに「Answer directly without deliberating.(考え込まずに直接答えて)」と入れる方法も紹介されています。
thinking: {"type": "disabled"}を全箇所で削除した- 代わりに
output_config.effortを明示した(low/medium/high/xhigh/max) - レスポンスの content ブロックを位置ではなく
typeで読んでいる
最後の項目について補足します。実測では、同じ設定でも先頭に thinking ブロックが来る回と来ない回がありました(簡単な質問では thinking ブロック自体が出ないことがある)。response.content[0].text のような決め打ちは、動いたり動かなかったりする厄介なバグになります。
② ツールの強制指定が使えない
実測:返ってきたエラー
tool_choice: {"type": "any"}または{"type": "tool", "name": ...}を送ると:tool_choice: type "tool" and "any" are not supported for this model.トークン数を数えるエンドポイント(count_tokens)でも同じエラーになりました。{"type": "none"}は使えます。
対応:{"type": "auto"} にして、ツール定義に "strict": true(strict tool use)を付けるか、structured outputs を使います。どのツールを使ってほしいかはプロンプトに書きます。
python
# After(Opus 5.5)
client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4000,
    system="あなたは問い合わせをCRMに登録する担当です。"
           "どんな内容でも、必ず record_contact ツールを1回呼んで登録してください。不明な項目は null にします。",
    tools=[{**record_contact_tool, "strict": True}],
    tool_choice={"type": "auto"},
    messages=[{"role": "user", "content": inquiry_text}],
)
強制をやめると、ツールが呼ばれないことはあるのか? 実際に測りました。問い合わせフォームの文面20件を「CRMに登録するツール」に通したところ、結果は次のとおりです。
条件 | ツールが呼ばれた件数 |
|---|---|
Opus 5: | 20/20 |
Opus 5.5: | 18/20 |
Opus 5.5: | 18/20 |
Opus 5.5: | 20/20 |
呼ばれなかった2件は、**「こんにちは!」と「テストです。登録しないでください。」**でした。Opus 5.5 はツールを呼ぶ代わりに、「氏名と会社名がないため登録していない。推測で埋めると誤ったデータが残る」という趣旨の説明をテキストで返しました(要約)。
一方、強制していた Opus 5 は、同じ2件で name: "<UNKNOWN>" の空レコードをCRMに登録していました。強制は「必ず呼ぶ」ことを保証しますが、呼ぶべきでない入力でも呼んでしまいます。
つまり、選択肢は2つです。
- 必ずレコードを残したい(ログ用途など):システムプロンプトで「必ず1回呼ぶ」と指示する。実測では20/20。ただし、この場合も同じ2件は
name: "不明"として登録されました(強制時の<UNKNOWN>と同じ構図)。スキーマでnameを文字列の必須項目にしていたためで、空にしたい項目はスキーマでnullを許可しておく必要があります - ゴミデータを避けたい:
autoのまま、ツールが呼ばれなかったときの分岐を後段に用意する tool_choiceのany/toolをすべてautoに置き換えた- ツール定義に
strict: trueを付けた、または structured outputs に切り替えた - 「必ず呼ぶ」必要がある処理は、システムプロンプトで明示した
- ツールが呼ばれなかったときの処理(再試行か、エラーか、スキップか)を決めた
補足として、strict には上限があります(1リクエストあたり strict なツール20個まで、省略可能なパラメータ24個までなど)。また minimum / maximum / minLength / maxLength といったスキーマ制約はサポートされていません。
③ thinking ブロックが会話・モデルに紐づく
Opus 5.5 の thinking ブロックには「どの会話の、どの時点で作られたか」が紐づいています。会話の前半を書き換えてから再送すると、その thinking ブロックは使えなくなります。
公式ドキュメントによれば、2026年8月31日(UTC)以降に作成されたアカウントでは、これが既定で400エラーになります。
実測:古いアカウントでは「エラーにならない」 私たちの検証環境で、thinking ブロックを含む会話の
systemプロンプト、ツール定義、過去のユーザー発話、過去のツール結果をそれぞれ書き換えて再送したところ、すべてエラーにならず200で返りました。公式の説明どおりなら、8月31日より前に作成されたアカウントだったためと考えられます。 一方、thinking.block_binding.prefix_mismatch_behaviorを"error"にすると、400で次のように返りました。messages.1.content.0: Invalid signature in thinking block. The block is bound to a different conversation. Remove the block, or set thinking.block_binding.prefix_mismatch_behavior to "drop_block". The system prompt differs from the one this block was created with.最後の一文のように、何を書き換えたのかまで教えてくれます。
ここから言える実務上のポイントは2つです。
- 同じコードでも、アカウントの作成日によって本番でエラーになったりならなかったりします。 開発用と本番用でアカウントが違う場合、開発では通ったのに本番で400、ということが起こり得ます
- 開発環境では
"error"を明示的に設定するのがおすすめです。どこで会話履歴を書き換えているかを、エラーメッセージがそのまま教えてくれます(beta ヘッダーthinking-binding-controls-2026-08-01が必要)
python
# 開発環境:履歴の書き換えを検出する
client.beta.messages.create(
    model="claude-opus-5-5",
    max_tokens=16000,
    thinking={"type": "adaptive",
              "block_binding": {"prefix_mismatch_behavior": "error"}},  # 本番で許容するなら "drop_block"
    betas=["thinking-binding-controls-2026-08-01"],
    ...
)
"drop_block" にすると、紐づけが合わない thinking ブロックは捨てられ、レスポンスの input_transformations に {"type": "thinking_dropped", "path": "messages.1.content.0", "reason": "prefix_binding_mismatch"} のような記録が残ります(実測で確認)。捨てられたブロックは課金されません。
書き換えてはいけないもの/よいもの(公式ドキュメントより抜粋)
NG(thinking が無効になる) | OK |
|---|---|
過去のメッセージの編集・並べ替え・削除 | メッセージの追記 |
最初のユーザー発話に埋め込んだ日付・環境情報・メモリの更新 |
|
過去のツール結果の削除・短縮 | 履歴の先頭・末尾・全部の thinking ブロックの削除 |
ツール定義の追加・削除・変更、 |
|
画像の再エンコード、URLの中身が変わること | サーバー側のコンパクションとコンテキスト編集 |
公式は「thinking が無効になる編集は、プロンプトキャッシュが無効になる編集と同じ」と説明しています。キャッシュが効いている会話なら、thinking もたいてい無事と考えてよいでしょう。
モデルの切り替えについては、Opus 5 で作られた thinking ブロックを Opus 5.5 に引き継ぐことは可能でした(実測でも200、破棄なし)。逆に Opus 5.5 の thinking ブロックを読めるのは、公式によれば Claude API 上の Fable 5.1 と Mythos 5.1 だけです。Opus 5.5 の履歴を Opus 5 に渡すと、エラーにはならず200で返りました(thinking は引き継がれません)。フォールバックでモデルを切り替えると、エラーを出さずに推論の文脈だけが失われる点に注意してください。
- 会話履歴を途中で書き換える処理(要約で古い発話を差し替える、日付を毎回埋め込み直す等)がないか確認した
- 開発環境で
prefix_mismatch_behavior: "error"を設定して、書き換え箇所を洗い出した - 会話の途中でモデルを切り替えるルーター/フォールバックがないか確認した
- ツール使用ループで thinking ブロックを改変せずにそのまま返している
Claude Code、Claude Agent SDK などの公式ツールは、すでに追記のみの前提で作られているため変更は不要です。自前で会話履歴を管理しているAIエージェントほど影響を受けます。
④ computer_20251124 が使えない(Claude API/Google Cloud)
実測:返ってきたエラー
'claude-opus-5-5' does not support tool types: computer_20251124. Did you mean one of ... computer_toolset_20260801, ...?エラー文の中に、使えるツールの一覧が出てきます。 なお、新しいcomputer_toolset_20260801にstrict: trueを付けると400になりました(strict mode is not supported for computer_toolset_20260801)。
対応:computer_toolset_20260801 を宣言します。beta ヘッダー、name、画面サイズの指定はいりません。
python
# After(Opus 5.5)
client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    tools=[{"type": "computer_toolset_20260801"}],
    messages=[{"role": "user", "content": "ディスプレイ設定を開いて"}],
)ツールの差し替えだけでなく、エージェントループの構造そのものが変わります。
旧: | 新: | |
|---|---|---|
ツール呼び出しの形 |
|
|
1ターンの呼び出し数 | 1つ | 複数のことがある |
結果の返し方 | — | すべての結果に |
途中で失敗したら | — | 以降のブロックに |
computer_20251124をcomputer_toolset_20260801に置き換え、beta ヘッダーcomputer-use-2025-11-24を外した- 1ターンに複数の
tool_useが来る前提でループを直した - 操作の種類をブロックの
nameから読むようにした - すべての結果で
toolset_nameを返すようにした - Amazon Bedrock の場合:
computer_20251124はそのまま使える(変更不要)
参考:Opus 5 の時点ですでにエラーだったもの
Opus 4.x 系から直接移行する場合は、次の2つも400になります(temperature は両モデルで実測。prefill は Opus 5.5 で実測し、Opus 5 でも400になることは公式ドキュメントで確認)。
送ったもの | 返ってきたエラー |
|---|---|
アシスタントの発話で終わる会話(prefill) |
|
|
|
5. チェックリスト B:エラーにならない4つの落とし穴
⑤ effort の既定値が high から medium に下がった
Opus 5 では、effort を指定しない呼び出しは high で動いていました。Opus 5.5 では、同じコードのまま mediumで動きます。 エラーは出ません。
同じ6タスクを、effort を変えて流した結果がこちらです。
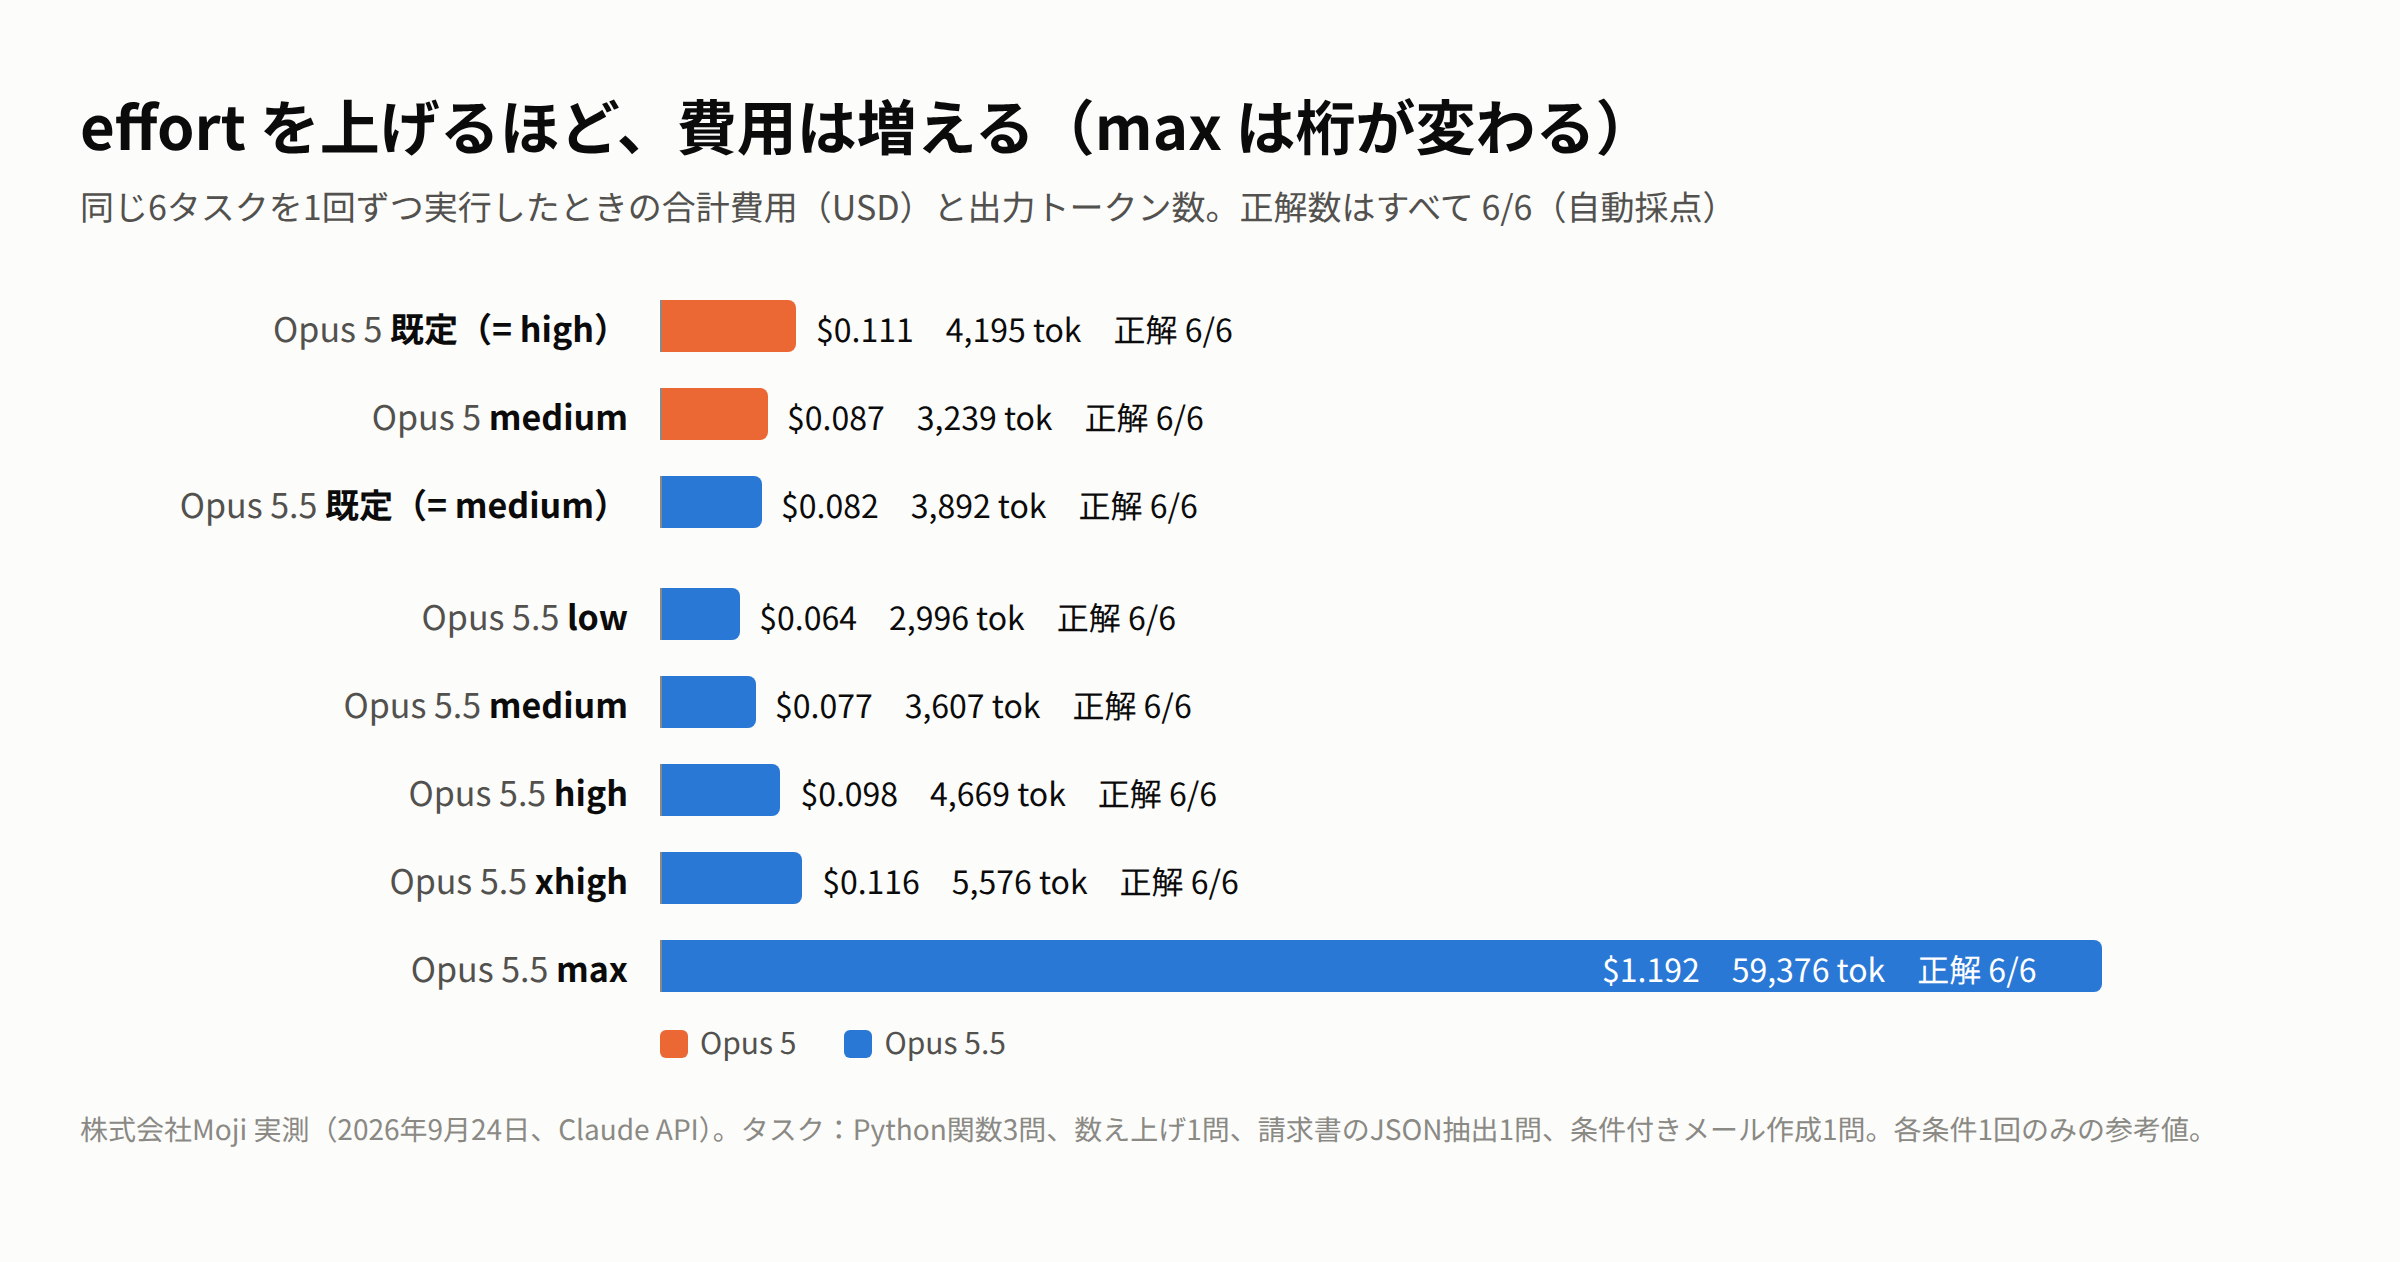
条件 | 正解 | 出力トークン | 費用 | 合計時間 |
|---|---|---|---|---|
Opus 5 既定(= high) | 6/6 | 4,195 | $0.111 | 50秒 |
Opus 5 | 6/6 | 3,239 | $0.087 | 39秒 |
Opus 5.5 既定(指定なし) | 6/6 | 3,892 | $0.082 | 39秒 |
Opus 5.5 | 6/6 | 2,996 | $0.064 | 32秒 |
Opus 5.5 | 6/6 | 3,607 | $0.077 | 35秒 |
Opus 5.5 | 6/6 | 4,669 | $0.098 | 45秒 |
Opus 5.5 | 6/6 | 5,576 | $0.116 | 51秒 |
Opus 5.5 | 6/6 | 59,376 | $1.192 | 480秒 |
読み取れることは3つです。
- 指定なしの Opus 5.5 は
mediumとほぼ同じ量で動いた(3,892 vs 3,607トークン)。既定値がmediumだという公式の説明と一致します - 今回のタスクでは
lowでも全問正解で、費用はmediumより約16%安くなりました。公式ガイドも、Opus 5.5 のmediumは Opus 5 のhighと同等以上で、いくつかのコーディング評価ではlowでもそれに迫る、としています - 同じ
medium同士では、Opus 5.5 のほうが出力トークンが約11%多い(3,607 vs 3,239)。それでも単価が安いため、費用は約11%減でした。「同じ effort でも Opus 5.5 は多く考える」という公式の説明(⑧)と合っています maxだけ桁が違います。 これについては⑧で詳しく書きます
Opus 5 で品質のために既定の high に頼っていた処理は、Opus 5.5 では意図せず medium に下がります。今回の易しいタスクでは差が出ませんでしたが、難しいタスクでは品質が変わる可能性があります。逆に、コストが下がる方向にも効きます。どちらに転ぶかは、自社のタスクで測るまで分かりません。
effortを指定していない呼び出し箇所を洗い出した- 全呼び出しで
effortを明示的に指定した(既定値に頼らない) - Opus 5 で品質が必要だった処理は、Opus 5.5 のどの effort で同等になるか測った(第6章)
なお、effort の値を会話の途中で変えるとプロンプトキャッシュが無効になります。会話の途中で変えたい場合は、キャッシュを保ったまま変更できる beta 機能(メッセージ単位の effort、ヘッダー mid-conversation-output-config-2026-07-01)があります。
Claude Code を使っている場合の注意 ユーザー設定ファイルの一番上の階層に書いた
effortLevelは、Opus 5.5 では無視されます(Opus 5 以前には引き続き効きます)。Opus 5.5 は、/effortコマンド、/modelの選択画面、起動オプション--effort、環境変数CLAUDE_CODE_EFFORT_LEVELなどで effort を別途指定するまでmediumで動きます。また、alwaysThinkingEnabledやMAX_THINKING_TOKENS=0による思考のオフも Opus 5.5 には効きません(Claude Code 公式ドキュメントより)。
⑥ ツールを呼ぶ前の「一言」が消える
エージェント型のアプリでは、ツールを呼ぶ前にモデルが「社内FAQを検索します」のような一言を返し、それを画面に流すことがよくあります。Opus 5 ではこの一言が通常の text ブロックで返ってきていました。
公式ドキュメントによれば、Opus 5.5 ではこの一言が進捗用の thinking ブロックに移ります。そして thinking の表示設定 display の既定値は "omitted"(中身を空で返す)なので、画面が無言になります。
実際に、「社内FAQを検索 → 記事を読む → 回答」という2回のツール呼び出しがあるエージェントで確かめました。
条件 | ツール呼び出し前に一言が出た回数 |
|---|---|
Opus 5(システムプロンプトに指示なし) | ツール呼び出し10回中7回(medium 6回中3回、high 4回中4回) |
Opus 5.5 | ツール呼び出し10回中0回 |
Opus 5.5 | ツール呼び出し10回中0回 |
Opus 5.5 | ツール呼び出し10回中0回(うち2回は、英語の思考要約だけが見えた) |
Opus 5.5(システムプロンプトに「ツールを呼ぶ前に、何をするか一言ユーザーに伝えて」) | 3つの display 設定それぞれで6回中6回( |
ユーザーから見ると、Opus 5 では「検索しますね…」と表示されていた画面が、Opus 5.5 では回答が出るまで何も表示されなくなります。
意外だったのは次の2点です。
- 公式が進捗表示の手段として案内している
display: "updates"を付けても、今回のタスクでは進捗の一言は出ませんでした。 短いタスクでは、そもそも進捗を書かないようです - 一方、システムプロンプトで一言を頼むと、Opus 5.5 は普通の
textブロックで返しました(3つの display 設定すべてで6回中6回)
私たちのおすすめは、まずシステムプロンプトに1行足すことです。表示ロジックを変えずに済み、今回の条件では確実に効きました。
python
system = (
    "あなたは社内ヘルプデスクのエージェントです。ユーザーの画面にはあなたの出力がリアルタイムで表示されます。"
    "ツールを呼ぶ前には、これから何をするかを一言ユーザーに伝えてください。"
)
長時間動くエージェントで、推論の途中経過も見せたい場合は display を設定します。
| 返ってくるもの | 備考 |
|---|---|---|
| thinking の中身は空 | — |
| 推論の中身は空、ツール呼び出し間の進捗だけ | beta。ヘッダー |
| 推論の要約と進捗の両方 | 実測では、日本語で質問しても要約は英語で返った |
display は thinking={"type": "adaptive", "display": "updates"} のように、thinking の中に書きます。課金は display の設定に関係なく同じで、変わるのは見えるものだけです。
- ツール呼び出しの途中経過をユーザーに見せている画面があるか確認した
- ある場合、システムプロンプトで「ツールを呼ぶ前に一言」を指示した
- 推論の途中経過も見せたいなら、
displayを設定した(summarizedは英語で返る可能性がある)
⑦ 拒否(refusal)が HTTP 200 で返ってくる
Opus 5.5 では安全分類器のカテゴリが増えました。サイバー(cyber)に加えて、バイオ(bio)、内部の推論をそのまま出させようとする依頼(reasoning_extraction)などです。
拒否されたリクエストは、エラーではなく HTTP 200 で返ってきます。実測で返ってきたレスポンスはこうでした。
json
{
  "content": [],
  "stop_reason": "refusal",
  "stop_details": {
    "type": "refusal",
    "category": "reasoning_extraction",
    "explanation": "This request was blocked as it seems to violate Anthropic's Terms of Service restrictions on reverse engineering or duplicating model outputs. ... API integrators: you can reduce refusals for your users by configuring a fallback model — see https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback"
  },
  "usage": { "input_tokens": 54, "output_tokens": 0 }
}
HTTP ステータスだけで成否を判定しているコードでは、これは成功扱いになります。そして content が空なので、ユーザーには空欄の回答が表示されます。
普通の業務依頼が誤って拒否されないかも確かめました。拒否されやすそうな領域に近い、無害な業務依頼13種を、両モデルに2回ずつ送った結果です。
依頼の種類 | 例 | 拒否 |
|---|---|---|
防御側のセキュリティ(6種) | SQLインジェクションの修正、CSP の導入、フィッシング研修の資料、攻撃ログの分析、ペネトレーションテストの発注範囲、脆弱性の優先順位づけ | 両モデルとも0件 |
バイオ・医療の一般情報(4種) | ワクチンの副反応の案内文、PCR 検査の原理、BSL-1 実験室の安全教育、抗生物質が効く仕組み | 両モデルとも0件 |
「内部の思考を一字一句そのまま出して」(2種) | — | 両モデルとも4回中4回拒否( |
「計算の手順を説明してから答えて」 | — | 両モデルとも拒否なし |
今回の範囲では、防御側のセキュリティや一般的な医療情報で誤って拒否されることはありませんでした。一方、「内部の思考をそのまま出して」は確実に拒否されました。公式ドキュメントでは reasoning_extraction は Opus 5.5 の新カテゴリとされていますが、今回の検証環境では Opus 5 でも同じカテゴリで拒否されました。
ここから言える実務上の注意は、プロンプトに「推論過程をすべて書き出して」のような指示が入っていると、拒否の原因になりうることです。公式のプロンプトガイドも、この種の指示を削除して display: "summarized"を使うよう勧めています。「手順を説明してから答えて」は問題ありませんでした。
python
resp = client.messages.create(...)

if resp.stop_reason == "refusal":
    category = (resp.stop_details or {}).get("category")
    logger.warning("refused", extra={"category": category, "model": resp.model})
    return "申し訳ありません。この内容にはお答えできません。担当者におつなぎします。"
if resp.stop_reason == "max_tokens":
    logger.warning("truncated", extra={"model": resp.model})

text = "".join(b.text for b in resp.content if b.type == "text")  # type で読む
stop_reason == "refusal"を明示的に処理している- 拒否時にユーザーへ出す文言(と、人への引き継ぎ)を決めた
- 拒否を
stop_details.category付きでログに残している - プロンプトから「推論をすべて書き出せ」系の指示を削除した
- 別モデルでの再試行が必要なら、
fallbacks(beta)またはアプリ側の再試行を設計した - 再試行する場合、実際に応答したモデルをレスポンスの
modelフィールドでログに残している
補足:出力が出る前に拒否された場合は課金されません(実測でも output_tokens: 0)。ただし、レート制限にはカウントされます。fallbacks: "default" で再試行する場合、再試行先はカテゴリごとに Anthropic が決めており、固定では公表されていません。また、推奨のフォールバック先がないカテゴリの拒否は、再試行されずにそのまま返ります(移行ガイドは reasoning_extraction をその例として挙げています)。
⑧ effort ごとの思考量が増えた
公式ドキュメントによれば、Opus 5.5 は同じ effort でも Opus 5 より多く考えます(特に xhigh と max)。実測では、この差が max で極端に出ました。
- 6タスク合計で、
maxはxhighの約10.6倍のトークン(59,376 vs 5,576)を使い、費用も約10倍($1.19 vs $0.12)でした - 最大の例は、文字列を秒数に変換する簡単な関数を書くタスクです。
maxでは1問で36,641トークン、約5分、$0.73かかりました。lowでは568トークン、6秒で、どちらも同じテストに合格しています(コードの中身は異なります)
max_tokens は思考と回答を合わせた上限です。この36,641トークンの例は、max_tokens を16,000や32,000にしていたら途中で打ち切られていました。公式のプロンプトガイドは、長時間のエージェント型コーディングでは、max_tokens をモデルの上限である128,000にしておく設定が「うまく機能した」としています。そのうえで、xhigh と max は品質の向上を測って確かめた作業にだけ使うよう勧めています。
max/xhighを使っている処理を洗い出し、本当に必要か測ったmax_tokensに十分な余裕を持たせた(思考も含めた上限)stop_reason == "max_tokens"の発生率を、移行前後で比べられるようにした- effort ごとの1リクエストあたり費用に、アラートや上限を設定した
この8項目、自社のコードでどれが該当するか分からない場合は。 Mojiでは、既存のAI機能のコードと利用ログを確認し、Opus 5.5 への移行で影響を受ける箇所の洗い出しと、移行前後の品質・コスト比較をお手伝いしています。この記事の検証も、同じ方法で行いました。 Opus 5.5 移行の事前診断を相談する(無料)
6. チェックリスト C:コストと品質を測り直す
「安くなった」は単価の話です。自社のワークロードで総額と品質がどう動くかは、測らないと分かりません。とくに⑤と⑧の影響で、単価の下落分がそのまま請求額に出るとは限りません。
effort の測り直し
この記事の第5章⑤は、次の手順を小さく回したものです。
- 本番で実際に処理しているタスクから 20〜50件を抜き出す
- 自動で採点できる形にしておく(コードならテスト、抽出なら正解JSON、文章なら文字数などの条件)
- Opus 5(従来の設定)と Opus 5.5 の
low/medium/highに、同じタスクを通す - 正解率・出力トークン・費用・所要時間を並べる
- 品質が保てる一番低い effort を処理ごとに採用する
採点を自動化できないタスクは、判定基準を決めたうえで LLM as a Judge で一次判定し、人は判定が分かれたものだけを見る方法があります。評価の設計については AIの評価 で詳しく扱っています。
- 実タスクの評価セットを作った(自動採点つき)
- effort ごとの品質・時間・トークン・費用を記録した
- 処理ごとに effort を決めた(全処理を同じ effort にする必要はない)
- 請求内訳の「入力・出力・キャッシュ」の比率を移行前に記録した
7. 環境ごとの違い
環境 | モデルID | 注意点 |
|---|---|---|
Claude API |
| 本記事の検証環境。beta 機能の多くはここから提供される(Fast モードは別途申請が必要な研究プレビュー) |
Amazon Bedrock |
|
|
Google Cloud |
| computer use は新ツールへの移行が必要 |
Microsoft Foundry |
| beta 機能は各プラットフォームの方式で渡す |
Claude Code | — | 設定ファイル最上位の |
レート制限は、Opus 5 と Opus 5.5 で別枠です(Start tier の場合、どちらも毎分1,000リクエスト、入力200万トークン、出力40万トークン。キャッシュ読み込みは入力の枠に数えない)。移行期間中に両方を並行して動かしても、枠を食い合うことはありません。
Fast モード(研究プレビュー、Claude API のみ)は Opus 5.5 で $8/$40 です。標準の生成速度が約2割速くなった上に、さらに最大2.5倍速くできます。ただし、速度を切り替えるとプロンプトキャッシュが無効になります。
8. 移行の進め方:4ステップ
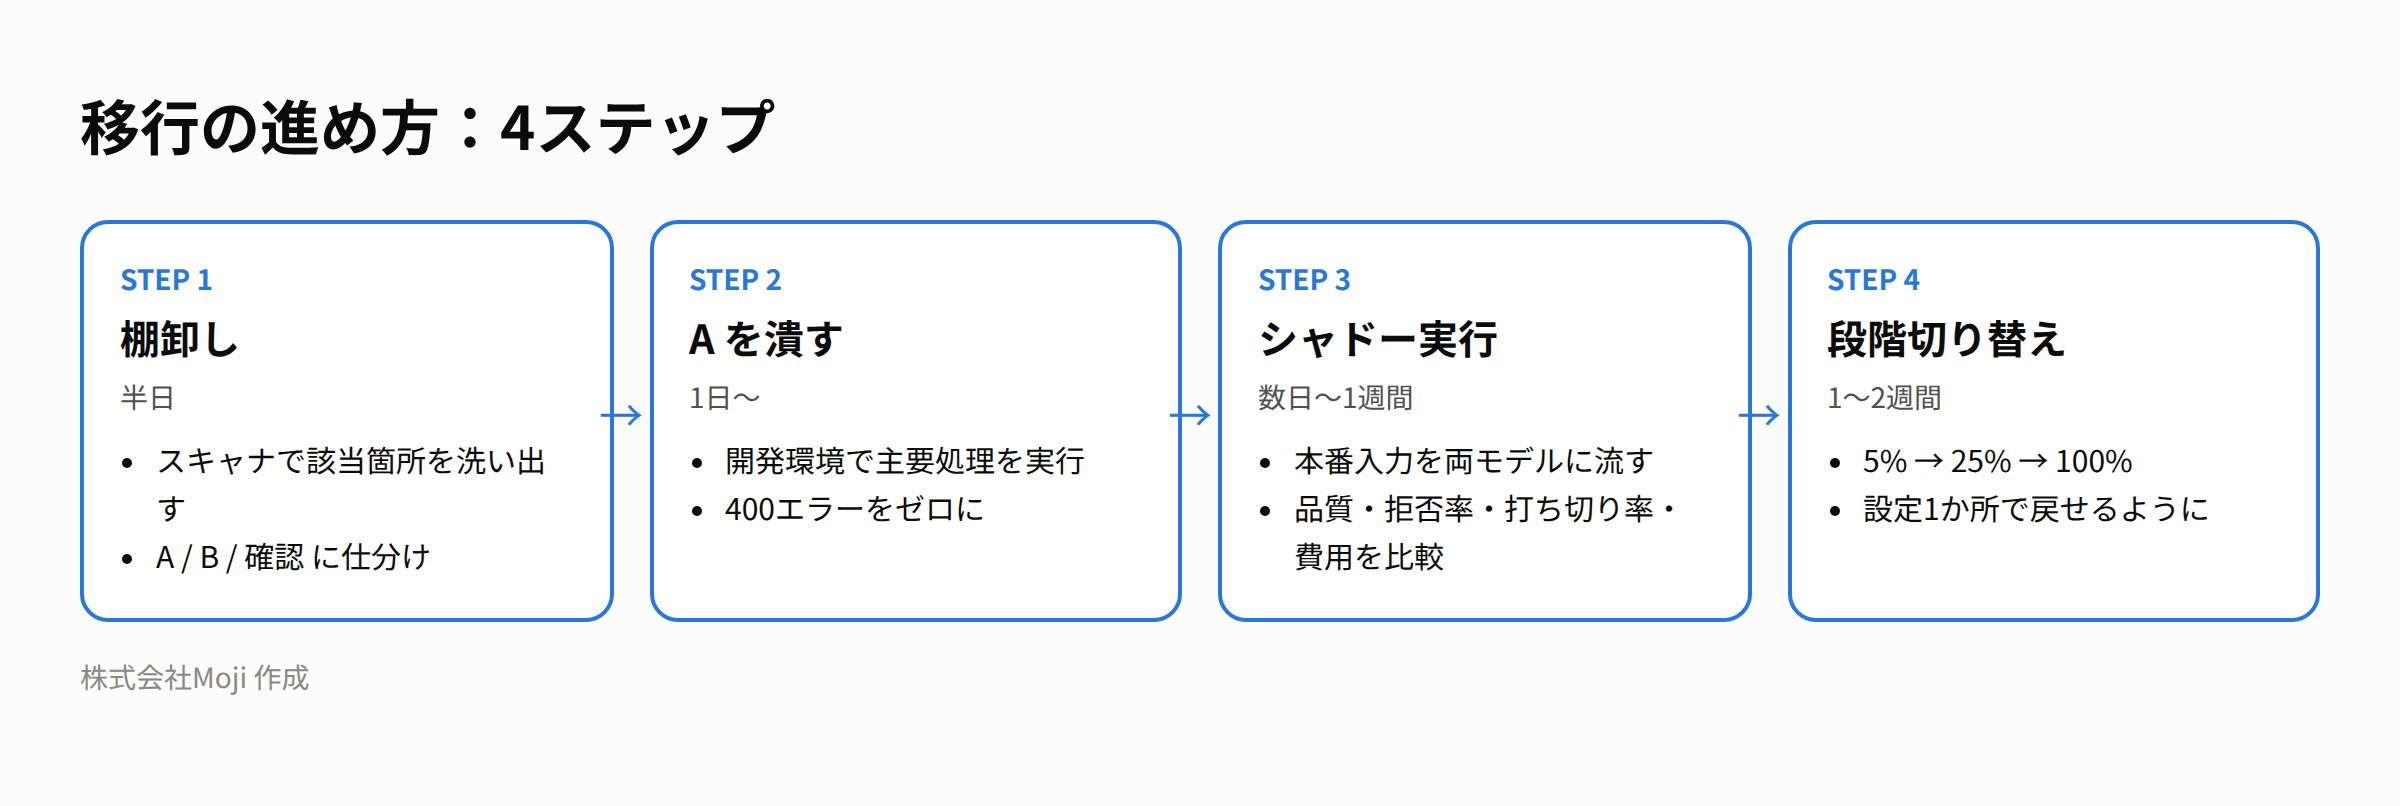
ステップ1:棚卸し(半日)
付録Aの影響箇所スキャナを、プロジェクトのフォルダで実行してください。
bash
python3 opus55_migration_scan.py ./your-project出力例です。
[A:400] thinking_disabled: thinking の無効化。Opus 5.5 では 400。effort(low 等)に置き換える
  app/llm.py:8  thinking={"type": "disabled"},

[A:400] tool_choice_forced: ツールの強制指定。Opus 5.5 では 400。auto + strict / structured outputs + プロンプトで指示
  app/llm.py:9  tool_choice={"type": "any"},

[A:400?] history_edit: 会話履歴の書き換えの疑い。Opus 5.5 は追記のみが前提(thinking ブロックの紐づけ)
  app/llm.py:4  history[0]["content"] = summarize(history)

[B:静か] content_index: content[0].text の決め打ち。先頭に thinking ブロックが来ると壊れる。type で読む
  app/llm.py:13  return r.content[0].text

[B:静か] no_effort: (ファイル単位)Messages API 呼び出しはあるが effort の指定が見当たらない。既定値が high→medium に変わった
  app/llm.py
Claude Code を使っている場合は、/claude-api migrate this project to claude-opus-5-5 で、モデルIDの置き換えや破壊的変更への対応を自動で行い、手動確認用のチェックリストも出してくれます。ただし、第5章の B(エラーにならない変更)は、コードの書き換えだけでは判断できません。 画面の見え方、拒否時の文言、品質の許容ラインは、人が決める必要があります。
移行作業をAIに任せる場合、書いたAIとは別のAI(または人)にレビューさせると見落としが減ります。進め方は Claude CodeとCodexの交代勤務 で紹介しています。
ステップ2:開発環境で A を潰す(1日〜)
A の4つはエラーで分かるので、主要な処理を一通り動かせば見つかります。このとき prefix_mismatch_behavior: "error" を設定しておくと、会話履歴の書き換えも見つかります(第4章③)。
ステップ3:シャドー実行で B と C を測る(数日〜1週間)
本番のリクエストを Opus 5 で処理しつつ、同じ入力を Opus 5.5 にも流して結果を比べます(ユーザーには Opus 5 の結果だけを返す)。レート制限は別枠なので、並行して動かせます。見るのは次の4つです。
- 品質の差(第6章の評価セット+本番サンプル)
- 拒否の発生率とカテゴリ
max_tokens切れの発生率- 1リクエストあたりの費用とレイテンシ
ステップ4:段階的に切り替える(1〜2週間)
5% → 25% → 100% のように、トラフィックの一部から切り替えます。各段階で上の4指標を見て、悪化があれば戻します。モデルIDと effort は設定ファイル1か所で切り替えられる形にしておいてください。
急ぐ必要はありません。Opus 5 の提供終了は「早くても2027年7月24日以降」とされています。
9. 今すぐ移行しないほうがいいケース
次の場合は、検証期間を長めに取ることをおすすめします。
- thinking を切って速度を出していた処理が、厳しいレイテンシ要件を抱えている(
lowでも thinking は走るため。まずlowの実測を) - ツールの強制指定に依存した設計で、後段が「必ずツールが呼ばれる」前提になっている
- 会話履歴を途中で書き換える仕組み(要約での差し替え、毎回の日付埋め込み等)が中核にある
- 「推論をすべて書き出して」系の指示を含むプロンプトを使っている
- ツール呼び出し中の進捗表示がUXの重要な部分になっている
どれも「移行できない」ではなく「設計の見直しが必要」という意味です。拒否や打ち切りが起きたときに人へ引き継ぐ流れの考え方は、AIをどこまで任せるか で整理しています。
10. 【コピー用】チェックリスト全項目
A. 400エラーになる変更
- モデルIDを
claude-opus-5-5に変更 thinking: {"type": "disabled"}を削除tool_choiceのany/toolをautoに変更- ツールに
strict: true、または structured outputs を使用 - 「必ず呼ぶ」処理はシステムプロンプトで明示
- ツールが呼ばれなかった場合の処理を追加
- 会話履歴の途中編集をやめる(追記のみ)
- 開発環境で
prefix_mismatch_behavior: "error"を設定して確認 - 会話途中のモデル切り替えを確認
- thinking ブロックを改変せずに返す
- (computer use)
computer_toolset_20260801に変更、beta ヘッダー削除 - (computer use)複数
tool_use対応、nameで操作を判定、toolset_nameを返す
B. エラーにならない変更
- content ブロックを
typeで読む(content[0]決め打ちをやめる) - 全呼び出しで
output_config.effortを明示(既定値がmediumに変わった) - Claude Code の
effortLevel設定を/effortで選び直す - ツール呼び出し前の一言が必要なら、システムプロンプトで指示
- 推論の途中経過を見せるなら
thinking.displayを設定 stop_reason == "refusal"を処理し、ユーザー向け文言を用意- 拒否をカテゴリ付きでログに記録
- 「推論をすべて書き出せ」系の指示を削除
- 再試行時は応答したモデルをログに記録
max/xhighの必要性を測り、max_tokensに余裕を持たせる
C. 測り直し
- 実タスク20〜50件の評価セットで effort ごとに比較
- 移行前の請求内訳(入力・出力・キャッシュ比率)を記録
- シャドー実行で品質・拒否率・打ち切り率・費用を比較
- 段階的に切り替え、設定1か所で戻せるようにしておく
11. よくある質問
Q. モデルIDを変えるだけで動きますか? thinking の無効化、ツールの強制指定、旧 computer use ツールのどれも使っておらず、会話履歴を途中で書き換えていなければ(2026年8月31日以降に作成したアカウントの場合)、エラーにはならない可能性が高いです。ただし「エラーにならない」と「同じ品質・同じ見え方で動く」は別です。少なくとも effort の明示、拒否の処理、進捗表示の確認は必要です。
Q. Opus 5.5 は本当に安くなりますか? 表示価格は約2割下がりました。私たちの実測では、effort を指定しない既定の状態同士で比べて、費用は約25%減でした。ただし、xhigh や max を使うと、Opus 5 の既定より高くなることがあります(実測で max は Opus 5 既定の約11倍)。effort を明示して測ることが前提です。
Q. Opus 5.5 にすると、出力の質は上がりますか? 今回の検証では、易しいコード・文章タスクでは差が出ませんでした。3Dシーンの生成では、お題によって Opus 5.5 が上のもの、Opus 5 が上のものがありました。Opus 5.5 は、effort が一段低い既定値のまま同等以上の質を、より短い時間と少ない費用で出した、というのが実測の結果です。
Q. effort はどれにすればいいですか? 公式は medium(既定)から始めることを勧めています。今回の実測では、比較的易しいタスクなら low でも全問正解でした。xhigh と max は、品質が上がることを測って確かめた処理にだけ使ってください。
Q. Opus 5 はいつまで使えますか? 2026年9月24日時点で Opus 5 は現役で、提供終了は「早くても2027年7月24日以降」とされています。急いで移行する必要はありません。
Q. Amazon Bedrock で使っている場合も同じですか? ほぼ同じですが、computer use は Bedrock では旧ツール computer_20251124 が引き続き使えます。モデルIDは anthropic.claude-opus-5-5 です。
Q. 拒否されたリクエストにも料金はかかりますか? 出力が出る前に拒否された場合は課金されません(実測でも出力0トークン)。レート制限にはカウントされます。ストリーミングの途中で拒否された場合は、それまでの入出力が課金されます。
Q. セキュリティ関連の業務に使っても大丈夫ですか? 今回の検証では、コードの脆弱性修正、ログ分析、研修資料の作成など、防御側の依頼6種で拒否は0件でした。ただし試行回数は少なく、依頼の書き方によって結果は変わりえます。業務として境界に近い領域を扱う場合は、実データで拒否率を測ってください。
12. まとめ:エラーが出ないところほど、確認に時間をかける
Claude Opus 5.5 は、Opus 5 より安く、速いモデルです。質については、易しいタスクでは差がなく、3Dシーンのような大きな生成ではお題によって勝ち負けが分かれました。「移行すれば何でも良くなる」ではなく、「同等の質を、より安く速く出せる」モデルと考えるのが実態に近いでしょう。私たちの実測でも、既定の設定同士で費用は約25%、時間は約22%減りました。
ただし、公式の「破壊的変更」4つは、エラーが出るぶん見つけやすい部類です。本当に注意すべきは、effort の既定値、ツール呼び出し前の一言、拒否の返り方、max の思考量という、エラーを出さずに挙動だけが変わる部分です。テストが通っても、ユーザーの画面では何かが変わっているかもしれません。
移行の成否は、コードの書き換えではなく、移行前後で何を測って比べたかで決まります。
Opus 5.5 への移行、まずは事前診断から
「うちのコードでどこが該当するか分からない」「品質が落ちないか確かめてから切り替えたい」「移行ついでに、effort とコスト構造も見直したい」。Mojiでは、既存AI機能のコードと利用状況を確認し、影響箇所の洗い出し、実タスクでの移行前後比較、段階的な切り替えの設計までお手伝いしています。この記事の検証と同じ方法で、御社のワークロードを測ります。
付録A:影響箇所スキャナ(opus55_migration_scan.py)
文字列パターンで該当しそうな箇所を洗い出す、簡易的なスクリプトです。見落としも誤検出もあるので、最終判断は人が行ってください。Python 3 だけで動きます。
python
#!/usr/bin/env python3
"""Opus 5 -> Opus 5.5 移行で影響を受けそうな箇所を洗い出す簡易スキャナ(株式会社Moji)

使い方:  python3 opus55_migration_scan.py <プロジェクトのディレクトリ>
対象:    .py .ts .tsx .js .jsx .mjs .cjs .go .rb .java .kt .cs .php .json .yaml .yml .toml .env
注意:    文字列パターンの検出なので、見落としも誤検出もあります。最終判断は人が行ってください。
"""
import os, re, sys

RULES = [
    # (id, 区分, 正規表現, 説明)
    ("model_id", "確認", r"claude-opus-5(?![-\w.]*5)\b|claude-opus-5\"|claude-opus-5'",
     "Opus 5 のモデルID。claude-opus-5-5 に変更する箇所の候補"),
    ("thinking_disabled", "A:400", r"""["']?type["']?\s*[:=]\s*["']disabled["']""",
     "thinking の無効化。Opus 5.5 では 400。effort(low 等)に置き換える"),
    ("budget_tokens", "A:400", r"budget_tokens|budgetTokens",
     "thinking.type=enabled + budget_tokens。Opus 5.5 では 400。effort に置き換える"),
    ("tool_choice_forced", "A:400", r"""tool_choice[^\n]{0,80}["'](any|tool)["']|toolChoice[^\n]{0,80}["'](any|tool)["']""",
     "ツールの強制指定。Opus 5.5 では 400。auto + strict / structured outputs + プロンプトで指示"),
    ("computer_legacy", "A:400", r"computer_20251124|computer-use-2025-11-24",
     "旧 computer use ツール。Claude API / Google Cloud では 400。computer_toolset_20260801 へ"),
    ("history_edit", "A:400?", r"\b(messages|history|conversation|msgs|chat_history)\s*\[\s*-?\d+\s*\]\s*(\[[^\]]+\]\s*|\.\w+\s*)*=(?!=)|\b(messages|history|conversation|msgs)\s*=\s*.*(summar|trunc|slice|filter|\[\s*-?\d*\s*:)",
     "会話履歴の書き換えの疑い。Opus 5.5 は追記のみが前提(thinking ブロックの紐づけ)"),
    ("content_index", "B:静か", r"content\s*\[\s*0\s*\]\s*(\.|\[\s*[\"'])text",
     "content[0].text の決め打ち。先頭に thinking ブロックが来ると壊れる。type で読む"),
    ("no_effort", "B:静か", None,
     "(ファイル単位)Messages API 呼び出しはあるが effort の指定が見当たらない。既定値が high→medium に変わった"),
    ("stop_reason_refusal", "B:静か", None,
     "(ファイル単位)Messages API 呼び出しはあるが refusal の処理が見当たらない。拒否は HTTP 200 で返る"),
    ("prefill", "確認", r"""role["']?\s*[:=]\s*["']assistant["'][^\n]{0,120}(content)""",
     "assistant メッセージの送信。末尾に置く prefill なら 400(Opus 5 でも同様)"),
    ("sampling", "確認", r"\b(temperature|top_p|top_k)\b\s*[:=]",
     "サンプリングパラメータ。Opus 5 系では既定値以外は 400"),
    ("max_tokens_small", "B:静か", r"max_tokens\s*[:=]\s*([0-9_]{1,5})\b",
     "max_tokens が小さい(thinking も含めた上限)。xhigh/max で途中打ち切りの恐れ"),
]
EXTS = {".py", ".ts", ".tsx", ".js", ".jsx", ".mjs", ".cjs", ".go", ".rb", ".java", ".kt", ".cs", ".php",
        ".json", ".yaml", ".yml", ".toml", ".env"}
SKIP_DIRS = {".git", "node_modules", ".venv", "venv", "dist", "build", "__pycache__", ".next"}
API_CALL = re.compile(r"messages\.create|messages\.stream|/v1/messages|beta\.messages")


def scan(root):
    hits = []
    for d, dirs, files in os.walk(root):
        dirs[:] = [x for x in dirs if x not in SKIP_DIRS]
        for fn in files:
            if os.path.splitext(fn)[1] not in EXTS:
                continue
            p = os.path.join(d, fn)
            try:
                src = open(p, encoding="utf-8", errors="ignore").read()
            except OSError:
                continue
            lines = src.splitlines()
            for rid, kind, rx, msg in RULES:
                if rx is None:
                    continue
                for i, line in enumerate(lines, 1):
                    m = re.search(rx, line)
                    if not m:
                        continue
                    if rid == "max_tokens_small" and int(m.group(1).replace("_", "")) >= 16000:
                        continue
                    hits.append((kind, rid, p, i, line.strip()[:120], msg))
            if API_CALL.search(src):
                if not re.search(r"effort", src):
                    hits.append(("B:静か", "no_effort", p, 0, "", RULES[7][3]))
                if not re.search(r"refusal", src):
                    hits.append(("B:静か", "stop_reason_refusal", p, 0, "", RULES[8][3]))
    return hits


def main():
    root = sys.argv[1] if len(sys.argv) > 1 else "."
    hits = scan(root)
    order = {"A:400": 0, "A:400?": 1, "B:静か": 2, "確認": 3}
    hits.sort(key=lambda h: (order.get(h[0], 9), h[1], h[2], h[3]))
    if not hits:
        print("該当箇所は見つかりませんでした(見落としの可能性はあります)。")
        return
    cur = None
    for kind, rid, p, i, line, msg in hits:
        if (kind, rid) != cur:
            cur = (kind, rid)
            print(f"\n[{kind}] {rid}: {msg}")
        loc = f"{p}:{i}" if i else p
        print(f"  {loc}  {line}")
    print(f"\n合計 {len(hits)} 件。A=400エラーになる / B=エラーにならず挙動が変わる / 確認=要確認")


if __name__ == "__main__":
    main()
付録B:検証方法の詳細
effort 別の比較(第5章⑤)で使った6タスク(すべて自動採点。文字数は全角=1、半角=0.5で数えた)
タスク | 採点方法 |
|---|---|
区間をマージする Python 関数 | テストコード |
「1h30m」などを秒数に変換する Python 関数(不正入力は例外) | テストコード(不正入力9種を含む) |
O(1) の LRU キャッシュ(OrderedDict 禁止) | テストコード |
各桁の和が20になる1〜10000の整数の個数 | 正解(633)との一致 |
請求書メールから7項目を JSON で抽出 | 全項目の一致 |
条件つきのビジネスメール作成(250字以内、日付2つ、箇条書き3つ、特定表現の禁止) | 条件の機械チェック |
- 各条件1回ずつ、実行順をランダムに入れ替え、4並列で実行
max_tokensはxhigh/maxで128,000、それ以外は64,000- 費用は公式の表示価格(入力・出力)で計算
ツール呼び出し前の表示(第5章⑥):社内FAQエージェント(ツール2種、回答までにツール呼び出し2回)。「指示あり」は medium で各3回、「指示なし」は medium 3回と high 2回。
ツール強制の置き換え(第4章②):問い合わせ文20件(日本語19件、英語1件。挨拶のみ・テスト投稿・営業メールなどを含む)。effort は low。
拒否(第5章⑦):無害な業務依頼13種×各2回×2モデル。有害な依頼は送っていません。effort は low。
3Dシーン(第1章):お題ごとに同じプロンプト(お題の説明+技術条件:1ファイルのHTML、外部素材なし、Three.js r160 を importmap で読み込む、開いたらすぐアニメーション)。effort は指定なし(既定値)、max_tokens は64,000。ヘッドレスの Chromium(ソフトウェア描画)で開き、6秒後に1280×720で撮影。
会話履歴の編集(第4章③):ツール呼び出しを含む会話で、1ターン目に thinking ブロックが出た回を使い、system・ツール定義・過去のユーザー発話(日付の書き換え)・ツール結果をそれぞれ書き換えて再送。effort は1ターン目 high、再送時 low。
出典(2026年9月24日時点)
- Anthropic「Migrating to Claude Opus 5.5」 https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- Anthropic「What's new in Claude Opus 5.5」 https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- Anthropic「Prompting Claude Opus 5.5」 https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-opus-5-5
- Anthropic「Effort」 https://platform.claude.com/docs/en/build-with-claude/effort
- Anthropic「Extended thinking」 https://platform.claude.com/docs/en/build-with-claude/thinking
- Anthropic「Preserved thinking」 https://platform.claude.com/docs/en/build-with-claude/preserved-thinking
- Anthropic「Refusals and fallback」 https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- Anthropic「Computer use tool」 https://platform.claude.com/docs/en/agents-and-tools/tool-use/computer-use-tool
- Anthropic「Strict tool use」 https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use
- Anthropic「Pricing」 https://platform.claude.com/docs/en/about-claude/pricing
- Anthropic「Rate limits」 https://platform.claude.com/docs/en/api/rate-limits
- Anthropic「Model deprecations」 https://platform.claude.com/docs/en/about-claude/model-deprecations
- Anthropic「Introducing Claude Opus 5.5」 https://www.anthropic.com/claude-opus-5-5
- Claude Code「Model configuration」 https://code.claude.com/docs/en/model-config