【発表1週間で整理】Claude Opus 5.5とGPT-6 Sol・Lunaはどっちを使う?料金・ベンチマーク・用途別の選び方
AI評価クラウド
そのAI、精度やリスクを正しく計測できていますか?
ハルシネーション検知や満足度計測など、AI品質の可視化をご支援します。

上杉 洸平 事業開発・SEO/AIO担当
株式会社Moji ビジネス開発・コンテンツマーケティング担当 鹿児島県出身。大学2年次から複数のスタートアップで長期インターンを経験し、営業・事業開発と0→1の立ち上げに携わる。2026年9月より、生成AI特化の開発会社・株式会社Mojiに参画。AI開発プロジェクトの事業開発と運営体制づくりを担当しながら、自社メディアのコンテンツ運用をリードしている。
Claude Opus 5.5 vs GPT-6 Sol・Luna|同じ日に出た2つの新モデルを料金・ベンチマーク・使いどころで比べる(2026年9月版)
この記事の結論(30秒版)
- 2026年9月22日(米国時間)、AnthropicがClaude Opus 5.5を、OpenAIがGPT-6 SolとGPT-6 Lunaを同じ日に発表した。
- 両社に共通するのは、「前世代より賢い」ではなく 「前世代より安い」 が発表の主語になっていること。Opus 5.5は同等作業のコストが約40%減、GPT-6 Sol/Lunaはトークン単価が半額になった。
- トークン単価だけ見ればGPT-6 Solが最安級(入力$2/出力$10)。Opus 5.5は入力$4/出力$20だが、1タスクを少ない手数で終わらせる方向で効率を出している。単価と総額は別物なので、自社のワークロードで測るしかない。
- 両社のベンチマーク発表は、そのまま並べて比較できない。 測定ハーネスも比較対象モデルも違い、同じ評価名で異なる数字が出ている。この記事ではその噛み合わなさも含めて提示する。
- 実務上いちばん効くのは、キャッシュ読み込みの値下げ(Opus 5.5は$0.50→$0.20、GPT-6系は90%割引)。長い前提を毎回読ませるRAGやエージェント用途では、ここが総額の大半を占める。
※本記事の料金・仕様は2026年9月23日時点の公式発表に基づきます。各社の一次情報へのリンクは末尾の「出典」に記載しています。
1. 何が起きたか:同じ日に、2社とも値札を書き換えた
2026年9月22日、大規模言語モデル(LLM)の主要2社が、偶然にも同じ日に新モデルを発表しました。
- Anthropic:Claude Opus 5.5(モデルID
claude-opus-5-5) - OpenAI:GPT-6 Sol / GPT-6 Luna(モデルID
gpt-6-sol/gpt-6-luna)
日本時間では9月23日の未明にあたります。
注目すべきなのは発表のタイミングよりも、両社の発表資料の力点が揃っていたことです。「新しい能力ができるようになった」ではなく、「同じことがもっと安く・速くできるようになった」が主題になっています。
Anthropicは Opus 5.5 について、Claude Fable 5.1 と同等の性能をOpus 5比で約40%低い実行コストで、かつ出力速度30%以上向上と説明しています。OpenAIは GPT-6 Sol / Luna について、GPT-5.6世代比でトークン単価を50%引き下げたと明示しました。
フロンティアモデルの発表が「賢さの更新」から「値段の更新」に移った日、と読むこともできます。この背景については第10章で触れます。
2. ここ3か月のモデル発表タイムライン
今回の2つを、直近の流れの中に置くとこうなります。
日付(米国時間) | 発表 |
|---|---|
2026年5月28日 | Claude Opus 4.8 |
2026年6月9日 | Claude Fable 5 / Mythos 5 |
2026年6月30日 | Claude Sonnet 5 |
2026年7月9日 | GPT-5.6 Sol |
2026年7月24日 | Claude Opus 5 |
2026年9月1日 | Claude Fable 5.1 / Mythos 5.1 |
2026年9月3日 | GPT-6 Astra |
2026年9月22日 | Claude Opus 5.5 / GPT-6 Sol・Luna |
3か月で8回。この速度自体が、後述する「フロンティアのペース調整」という議論の背景になっています。
3. Claude Opus 5.5:40%安く、30%速く
何が変わったか
Anthropicの発表によれば、Opus 5.5 の主な変更点は次のとおりです。
- コスト:同等の作業を、Opus 5比で約40%低い実行コストで完了
- 速度:出力生成がOpus 5比で30%以上高速
- 性能:ほとんどのタスクで Claude Fable 5.1 と同等以上
- 安全性:Anthropicの自動行動監査で最高スコア。プロンプトインジェクションへの耐性が向上し、安全境界を回避しようとする挙動が Opus 5比で85%減少
スペック
項目 | 値 |
|---|---|
コンテキストウィンドウ | 100万トークン |
同期出力の上限 | 12万8,000トークン |
Batches API の出力上限 | 30万トークン(ベータ) |
提供 | Claude Platform( |
適応的思考(adaptive thinking)が常時オンになり、effort パラメータで制御する形に変わりました。あわせて、effort を指定しないときの既定値が high から medium に下がっています。 これは後述するとおり、移行時に注意が必要な変更です。
ベンチマーク(Anthropic発表・対 Fable 5.1)
評価 | Opus 5.5 | Fable 5.1 |
|---|---|---|
Terminal-Bench 4.0(エージェント型コーディング) | 66.4% | 55.8% |
FrontierCode v1.1 | 54.4% | 50.3% |
CursorBench 4.0 | 57.8% | 51.8% |
GDPval-AA v2.1(知識労働) | 1846 Elo | 1735 Elo |
Anthropicは実利用の例として、68万行のコード移行が1日以内、20万行のコードベースの監査・修復が3時間以内(Opus 5では20時間超)といった報告も挙げています。これらは同社が紹介した事例であり、第三者検証ではない点は割り引いて読む必要があります。
AIエージェントに長時間の作業を任せる用途では、「1ステップあたりの賢さ」より「何手で終わるか」が総コストを決めます。Opus 5.5 の訴求はこの軸に寄っています。
4. GPT-6 Sol / Luna:単価を半額にした
位置づけ
9月3日に発表された GPT-6 Astra が最上位、今回の Sol が実務主力、Luna が高頻度・軽量用途、という3段構えになりました。
- GPT-6 Sol:複雑なコーディングとエージェント型AIワークフロー向け
- GPT-6 Luna:大量・低複雑度のタスク向け。ChatGPTの無料/Goユーザーにもデスクトップアプリで提供
スペック(GPT-6 Sol)
項目 | 値 |
|---|---|
コンテキストウィンドウ | 105万トークン |
最大出力 | 12万8,000トークン |
知識カットオフ | 2026年4月20日 |
| none / low / medium(既定) / high / xhigh / max |
入出力 | テキスト入出力、画像入力 |
ベンチマーク(OpenAI発表)
評価 | スコア | 備考 |
|---|---|---|
AutomationBench 1.0.6 | Sol(xhigh)33.2%/1タスク$0.27 | GPT-6 Astra(low)30.3%はSolの3.9倍コスト、Claude Opus 5(max)26.9%は11.1倍コスト |
Agents' Last Exam V1 | Sol(max)56.4% | Claude Opus 5(60%)に対し約60%低コスト |
DeepSWE v1.1 | Sol(max)68.8%/Luna(max)66.6% | LunaはOpus 5比93%、Fable 5比96%低コスト |
OSWorld 2.0 offline(コンピュータ操作) | Sol(xhigh)60.5% | Opus 5の60.3%に対し約80%低コスト |
事実性についてOpenAIは、ユーザーが誤りを報告した匿名化済み会話に基づく社内評価で、GPT-5.6 Sol比で誤りが約半分としています。ハルシネーションが減る方向の改善ですが、ゼロになったわけではありません。
5. 料金を並べる
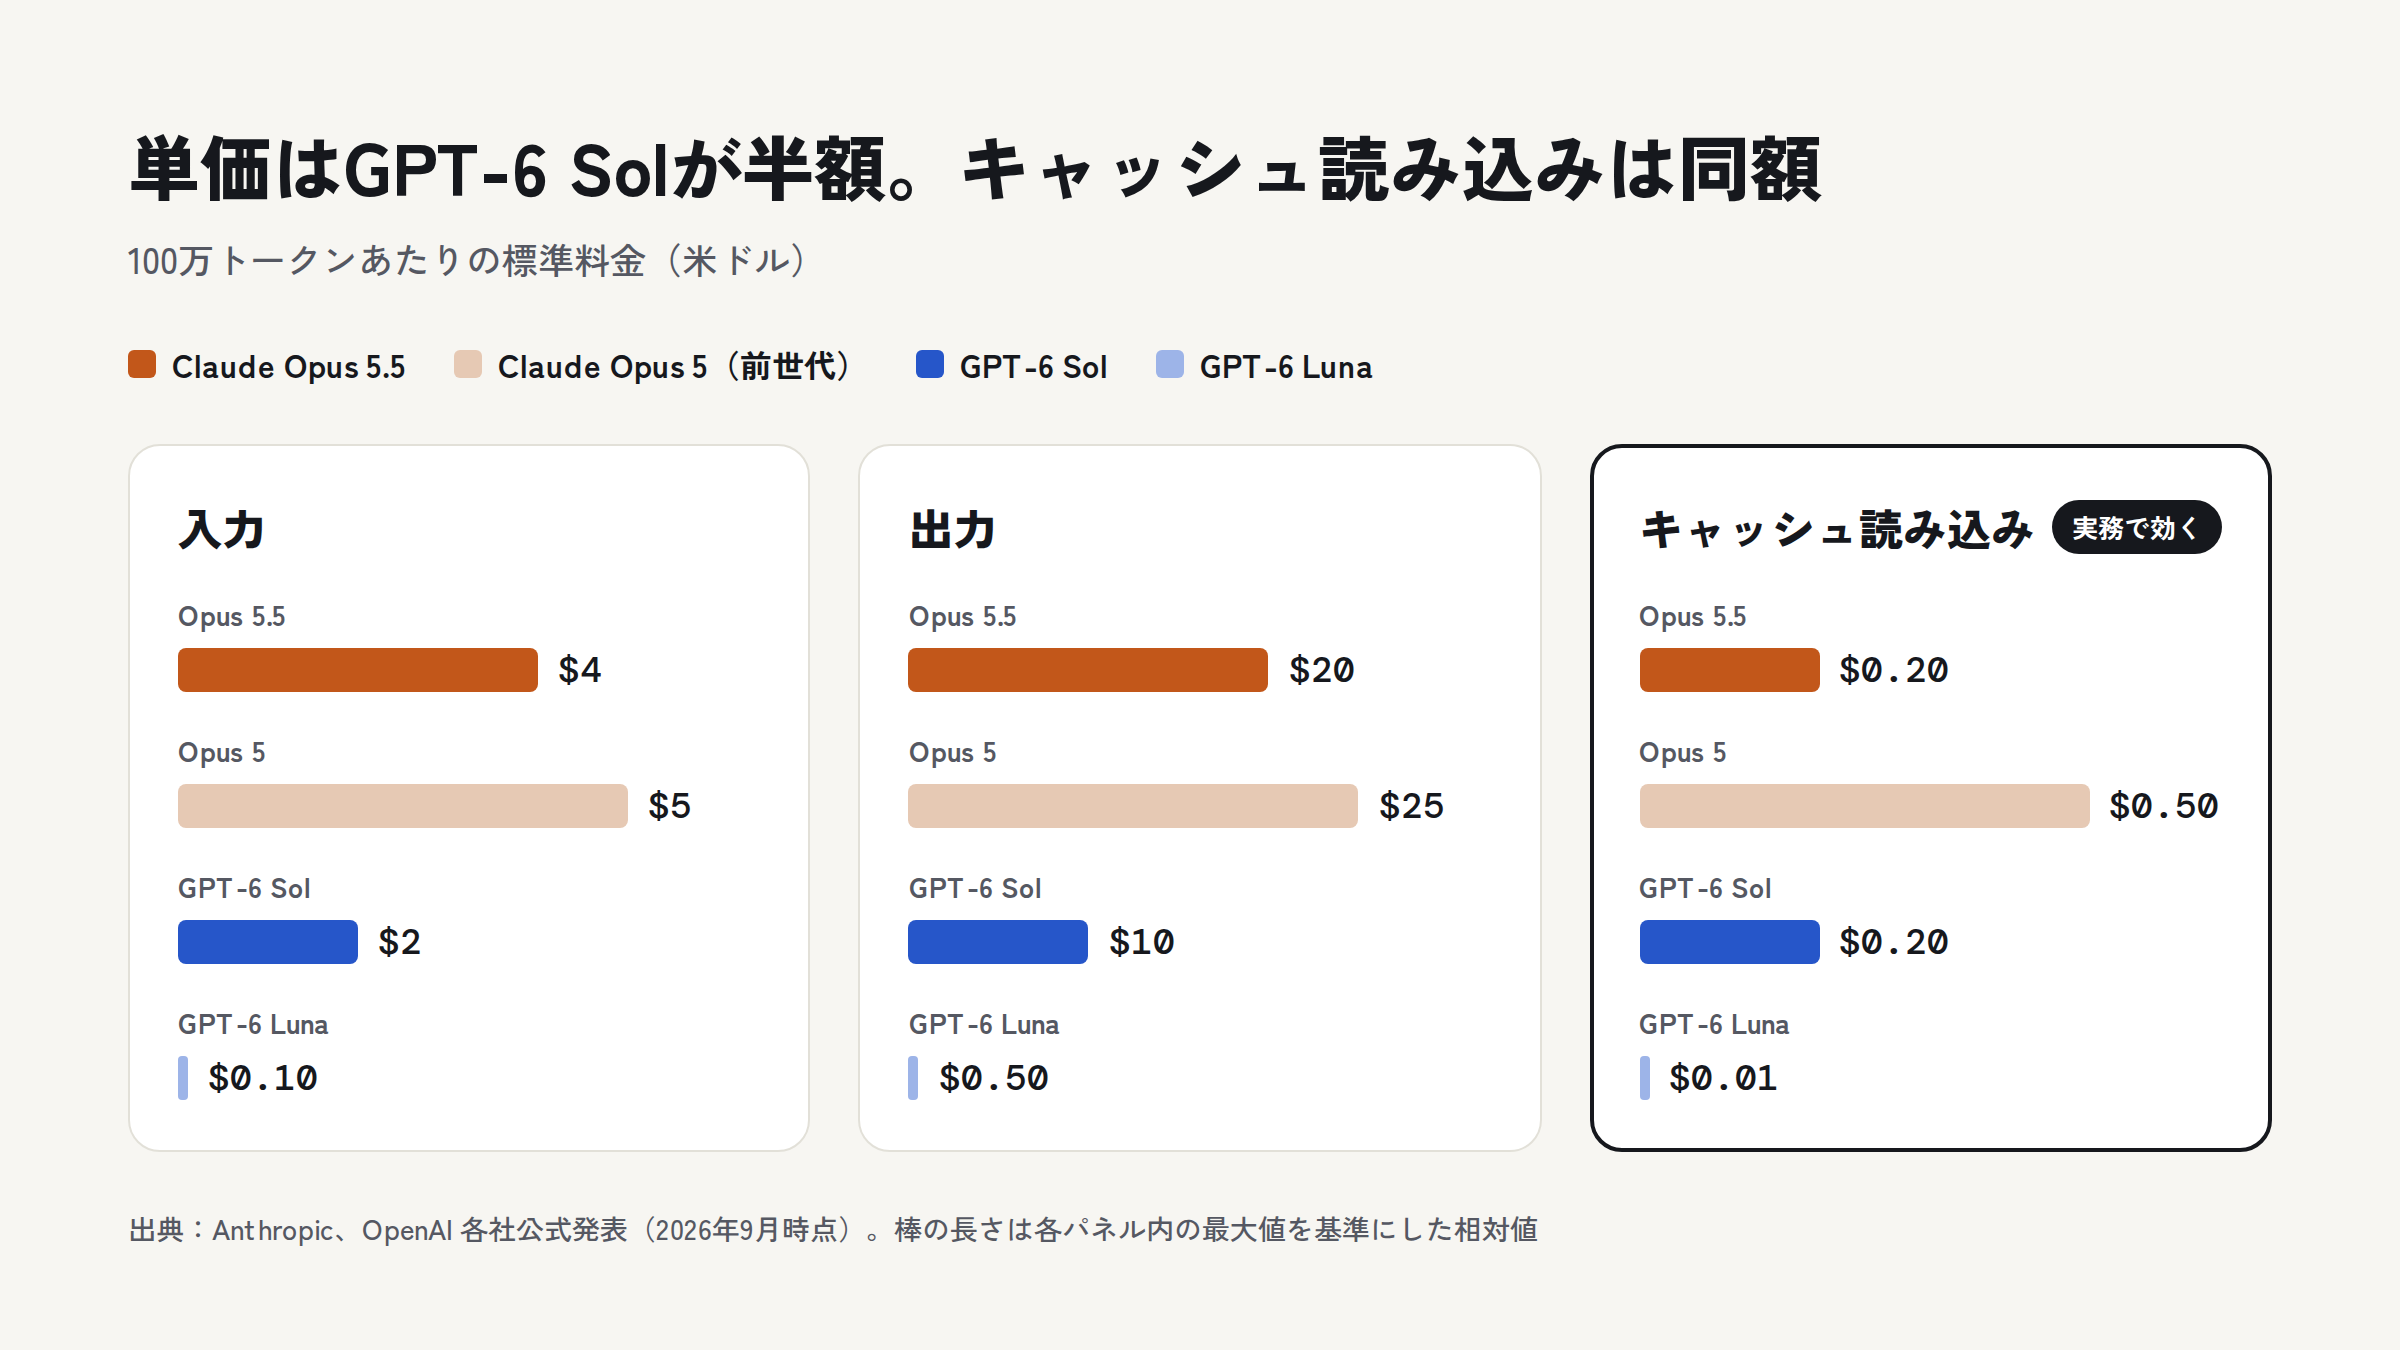
2026年9月23日時点、100万トークンあたりの標準料金です。
モデル | 入力 | 出力 | キャッシュ読み込み | キャッシュ書き込み |
|---|---|---|---|---|
Claude Opus 5.5 | $4 | $20 | $0.20 | $5 |
Claude Opus 5(前世代) | $5 | $25 | $0.50 | $6.25 |
GPT-6 Sol | $2 | $10 | $0.20 | $2.50 |
GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.125 |
補足:
- Fast モード:Opus 5.5 は $8/$40(最大2.5倍速)、GPT-6 Sol は標準の2倍
- バッチ処理:GPT-6 Sol は Batch / Flex で50%割引
- キャッシュ:OpenAIはキャッシュ済み入力トークンの読み込みに90%割引を適用(書き込みは入力単価の1.25倍)
- 「半額」の比較元:前世代の GPT-5.6 Sol の現在の価格(入力$4/出力$20)は、2026年11月21日までのキャンペーン価格です
単価表の落とし穴
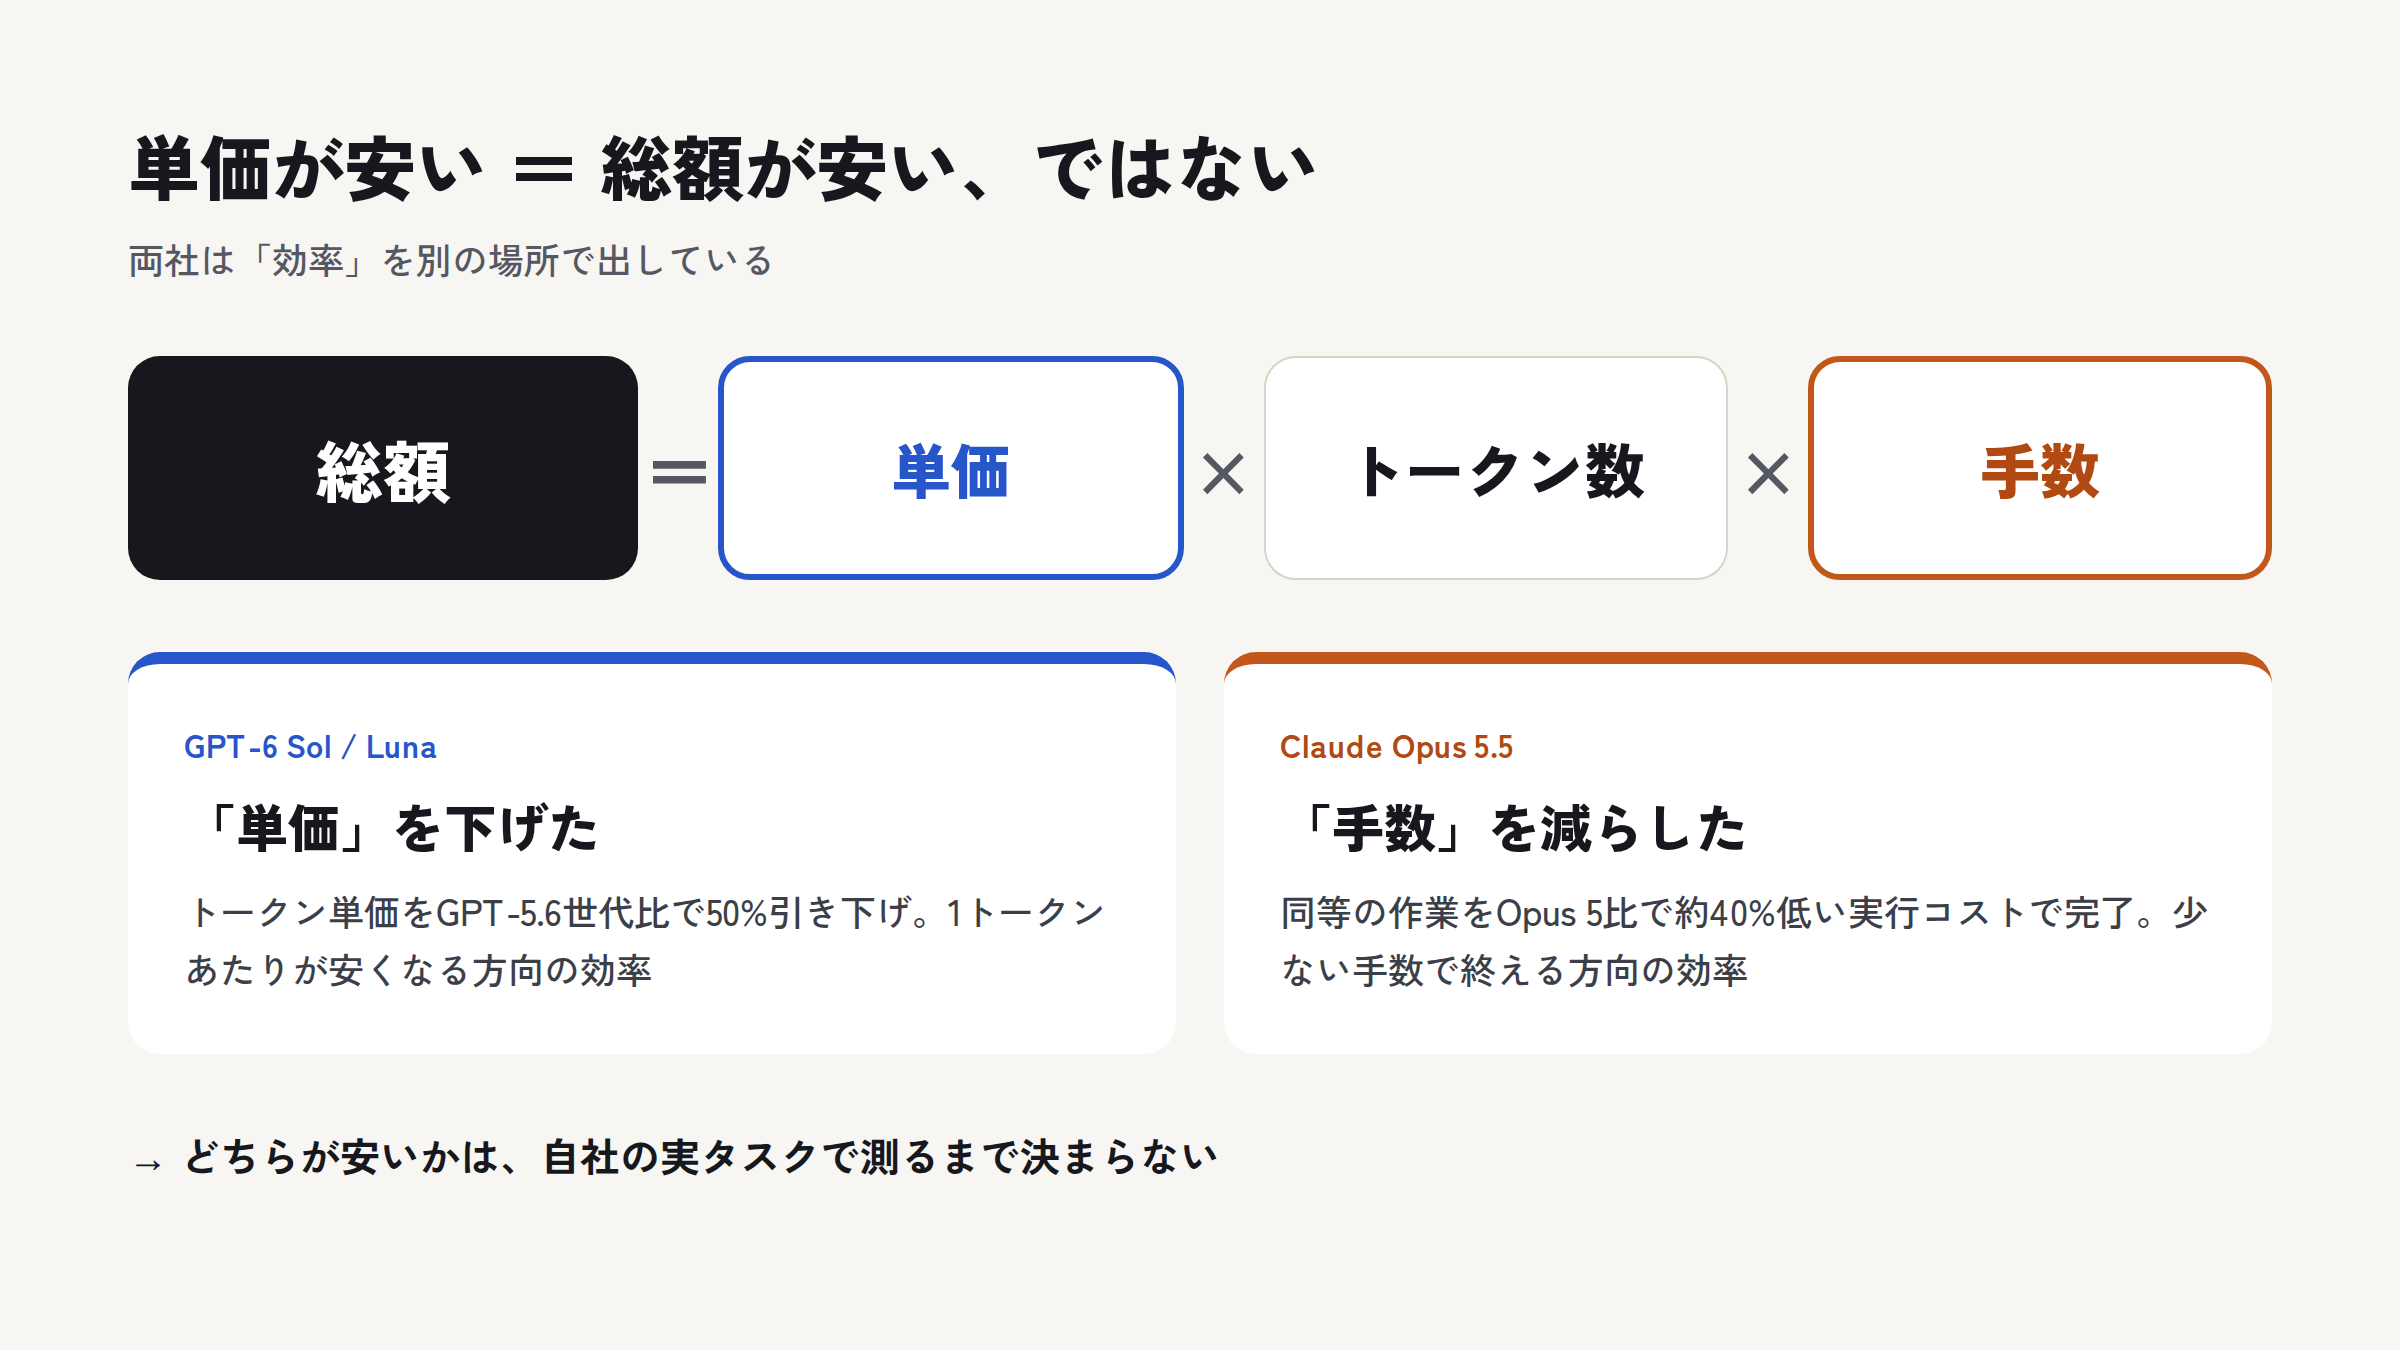
この表だけ見ると「GPT-6 Sol が Opus 5.5 の半額」に見えます。ただし総額=単価 × トークン数 × 手数です。
Anthropicが Opus 5.5 で訴求しているのは「同じ作業を少ない手数で終える」方向の効率で、OpenAIが Sol で訴求しているのは「1トークンあたりを安くする」方向の効率です。どちらが安いかは、単価表ではなく自社のワークロードで測るまで決まりません。
実務で効くのは、多くの場合キャッシュ読み込みです。RAGやエージェント用途では、同じ社内文書・同じシステムプロンプトを毎リクエスト読ませます。ここの単価が Opus 5 の $0.50 から Opus 5.5 の $0.20 に下がったことは、入力単価が $5→$4 になったこと以上に月額に効きます。自社の請求内訳で、キャッシュ読み込みが何割を占めているかを先に確認してください。
6. 【重要】両社のベンチマークは噛み合っていない
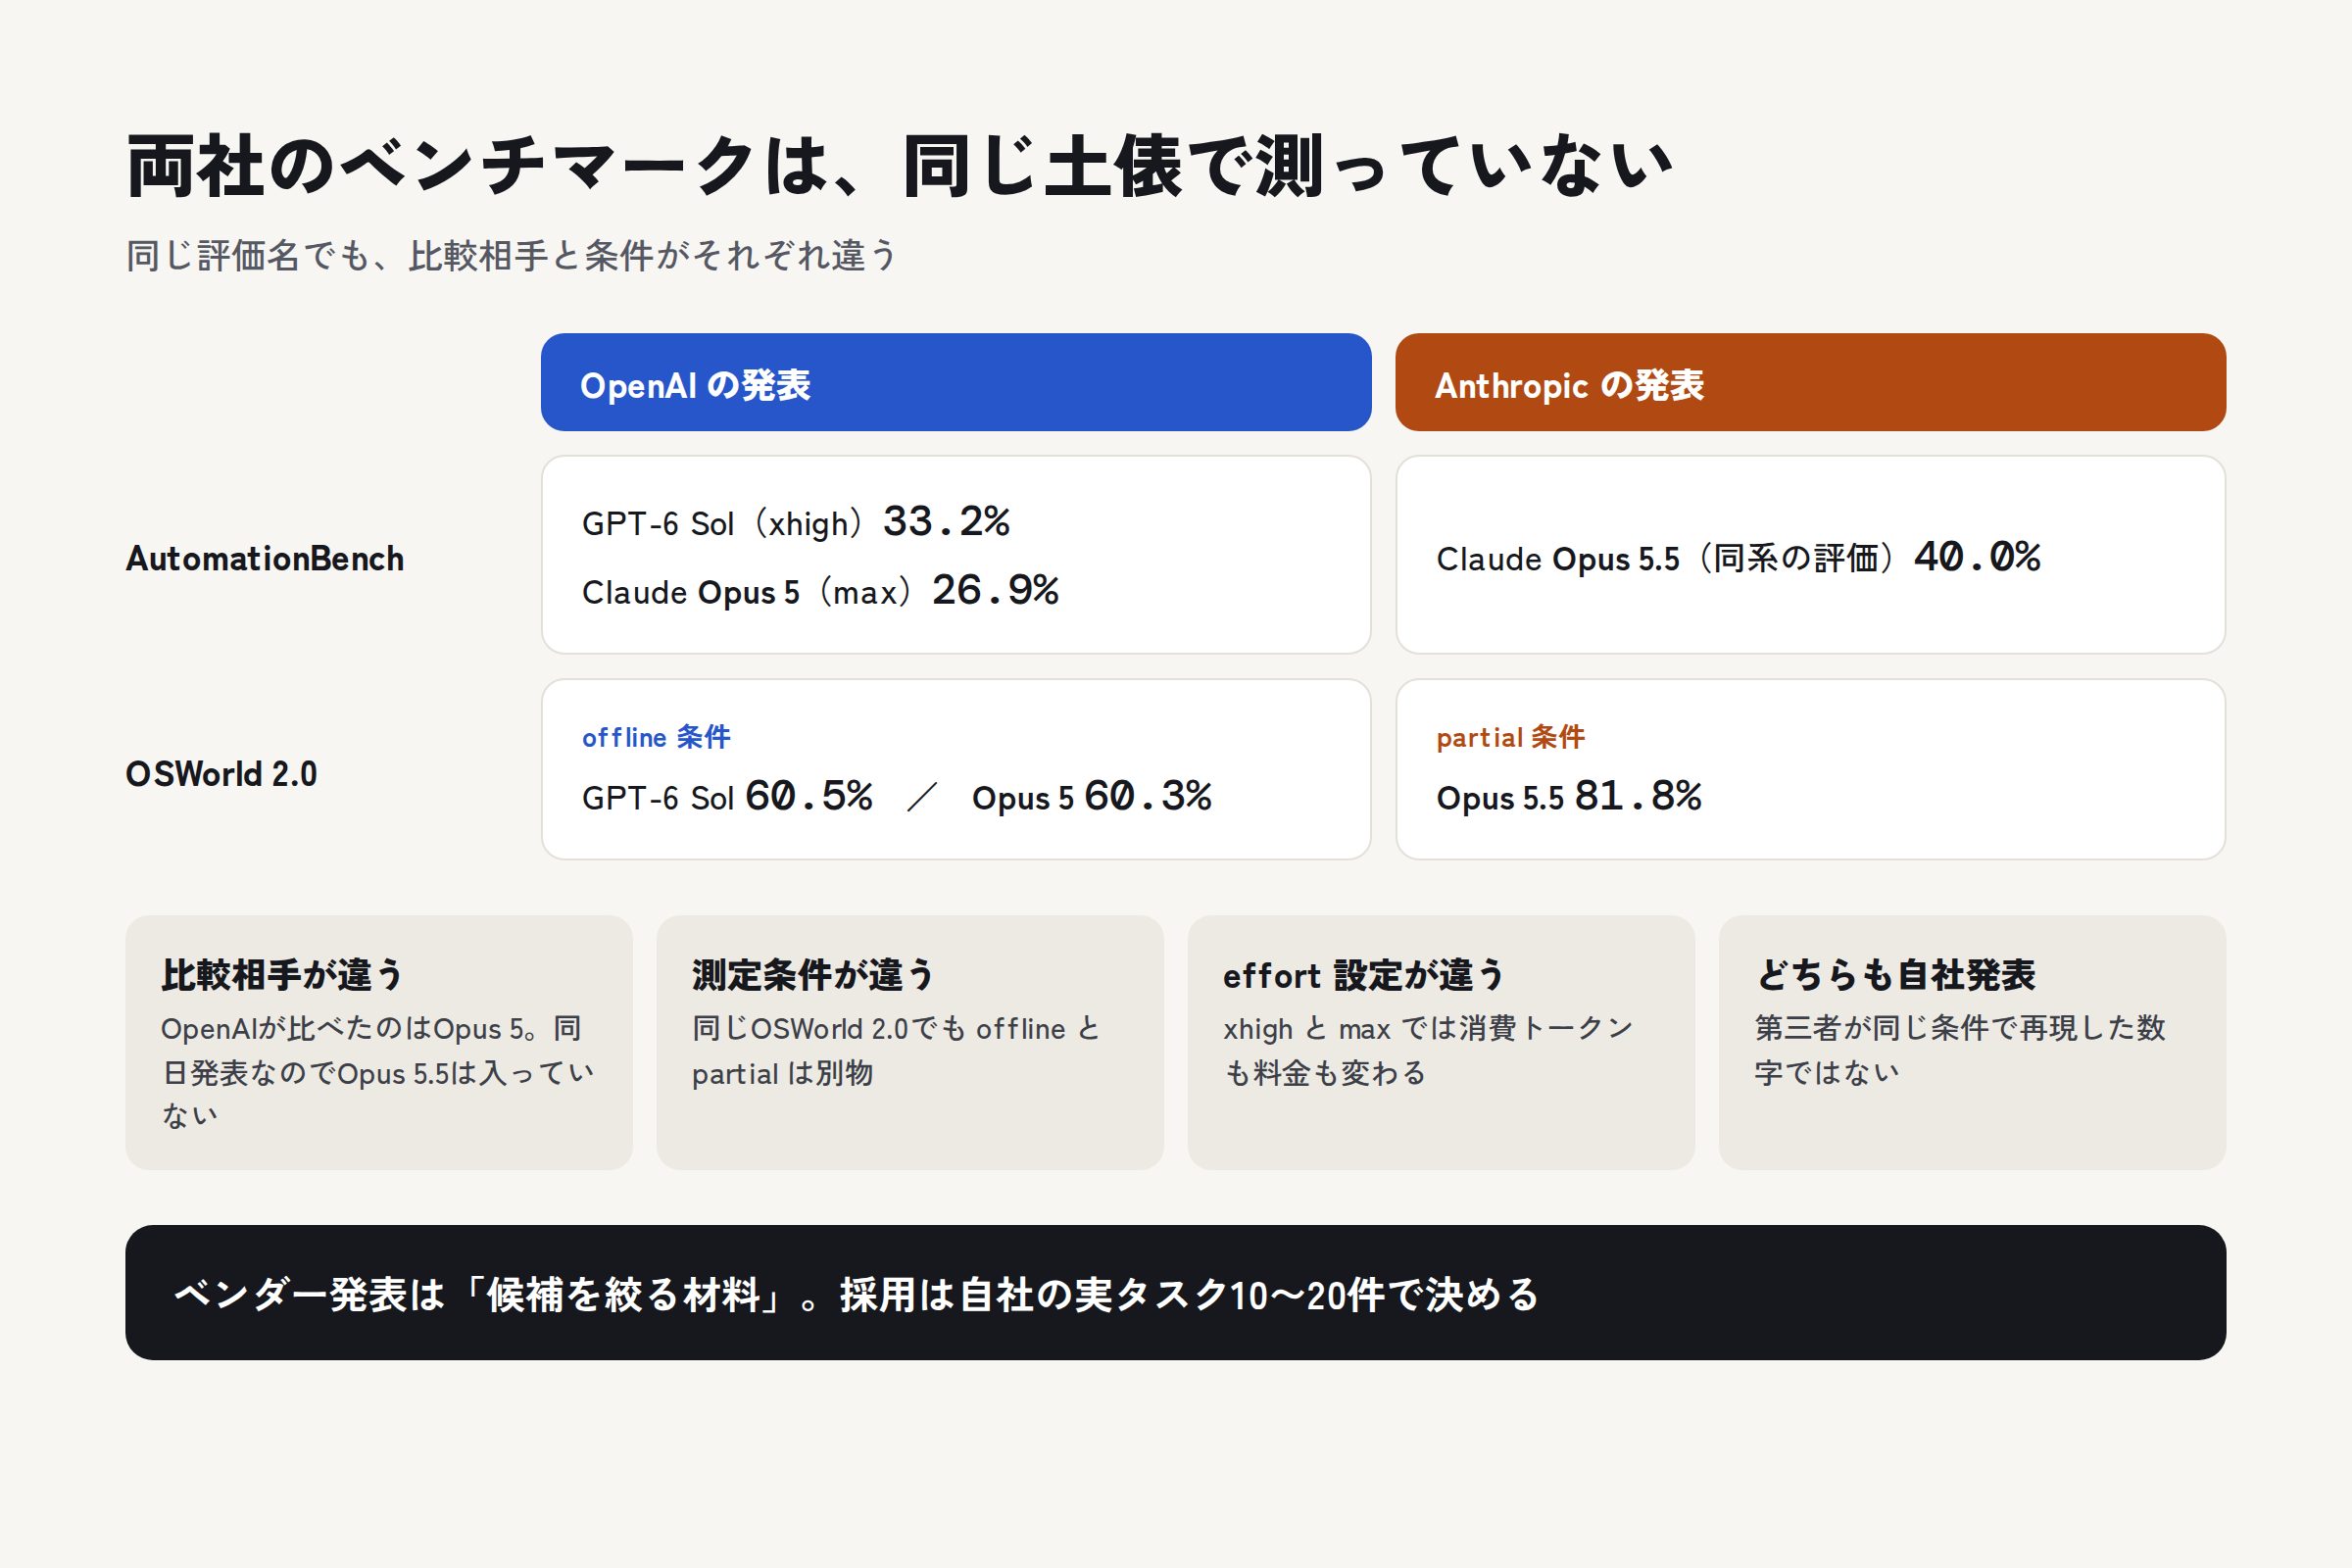
ここがこの記事でいちばん伝えたい部分です。
同じ日に出た2つの発表を並べると、次のような食い違いが見つかります。
- OpenAI は AutomationBench 1.0.6 で、GPT-6 Sol(xhigh)33.2% に対し Claude Opus 5(max)26.9% と報告
- Anthropic は同系の評価で Opus 5.5 が40.0% と報告
- OSWorld 2.0 では、OpenAIが「offline」条件で Sol 60.5%/Opus 5 60.3%、Anthropicが「partial」条件で Opus 5.5 81.8%
数字だけ拾えば「Opus 5.5 が圧勝」にも「Sol が圧勝」にも書けてしまいます。実際には、
- 比較対象が違う(OpenAIが比べているのは Opus 5 であって Opus 5.5 ではない。発表が同日なので当然です)
- 測定条件が違う(同じ OSWorld 2.0 でも offline と partial は別物)
- effort 設定が違う(xhigh と max では消費トークンも料金も変わる)
- どちらも自社発表(第三者による同一条件の再現ではない)
つまり、両社の数字は「同じ土俵の勝敗」ではなく、それぞれが自分の土俵で測った自己申告です。
この構造は、AIの評価や LLM as a Judgeで扱っている問題そのものです。評価は「何を・どの条件で・誰が測ったか」を外すと意味を失います。ベンダー発表のベンチマークは候補を絞る材料であって、採用を決める材料ではありません。
実務での結論:自社の実タスク10〜20件で小さな評価セットを作り、同じプロンプト・同じ手順で両方を通してください。1時間の検証が、ベンチマーク表100行より確実です。
7. 用途別:どう使い分けるか
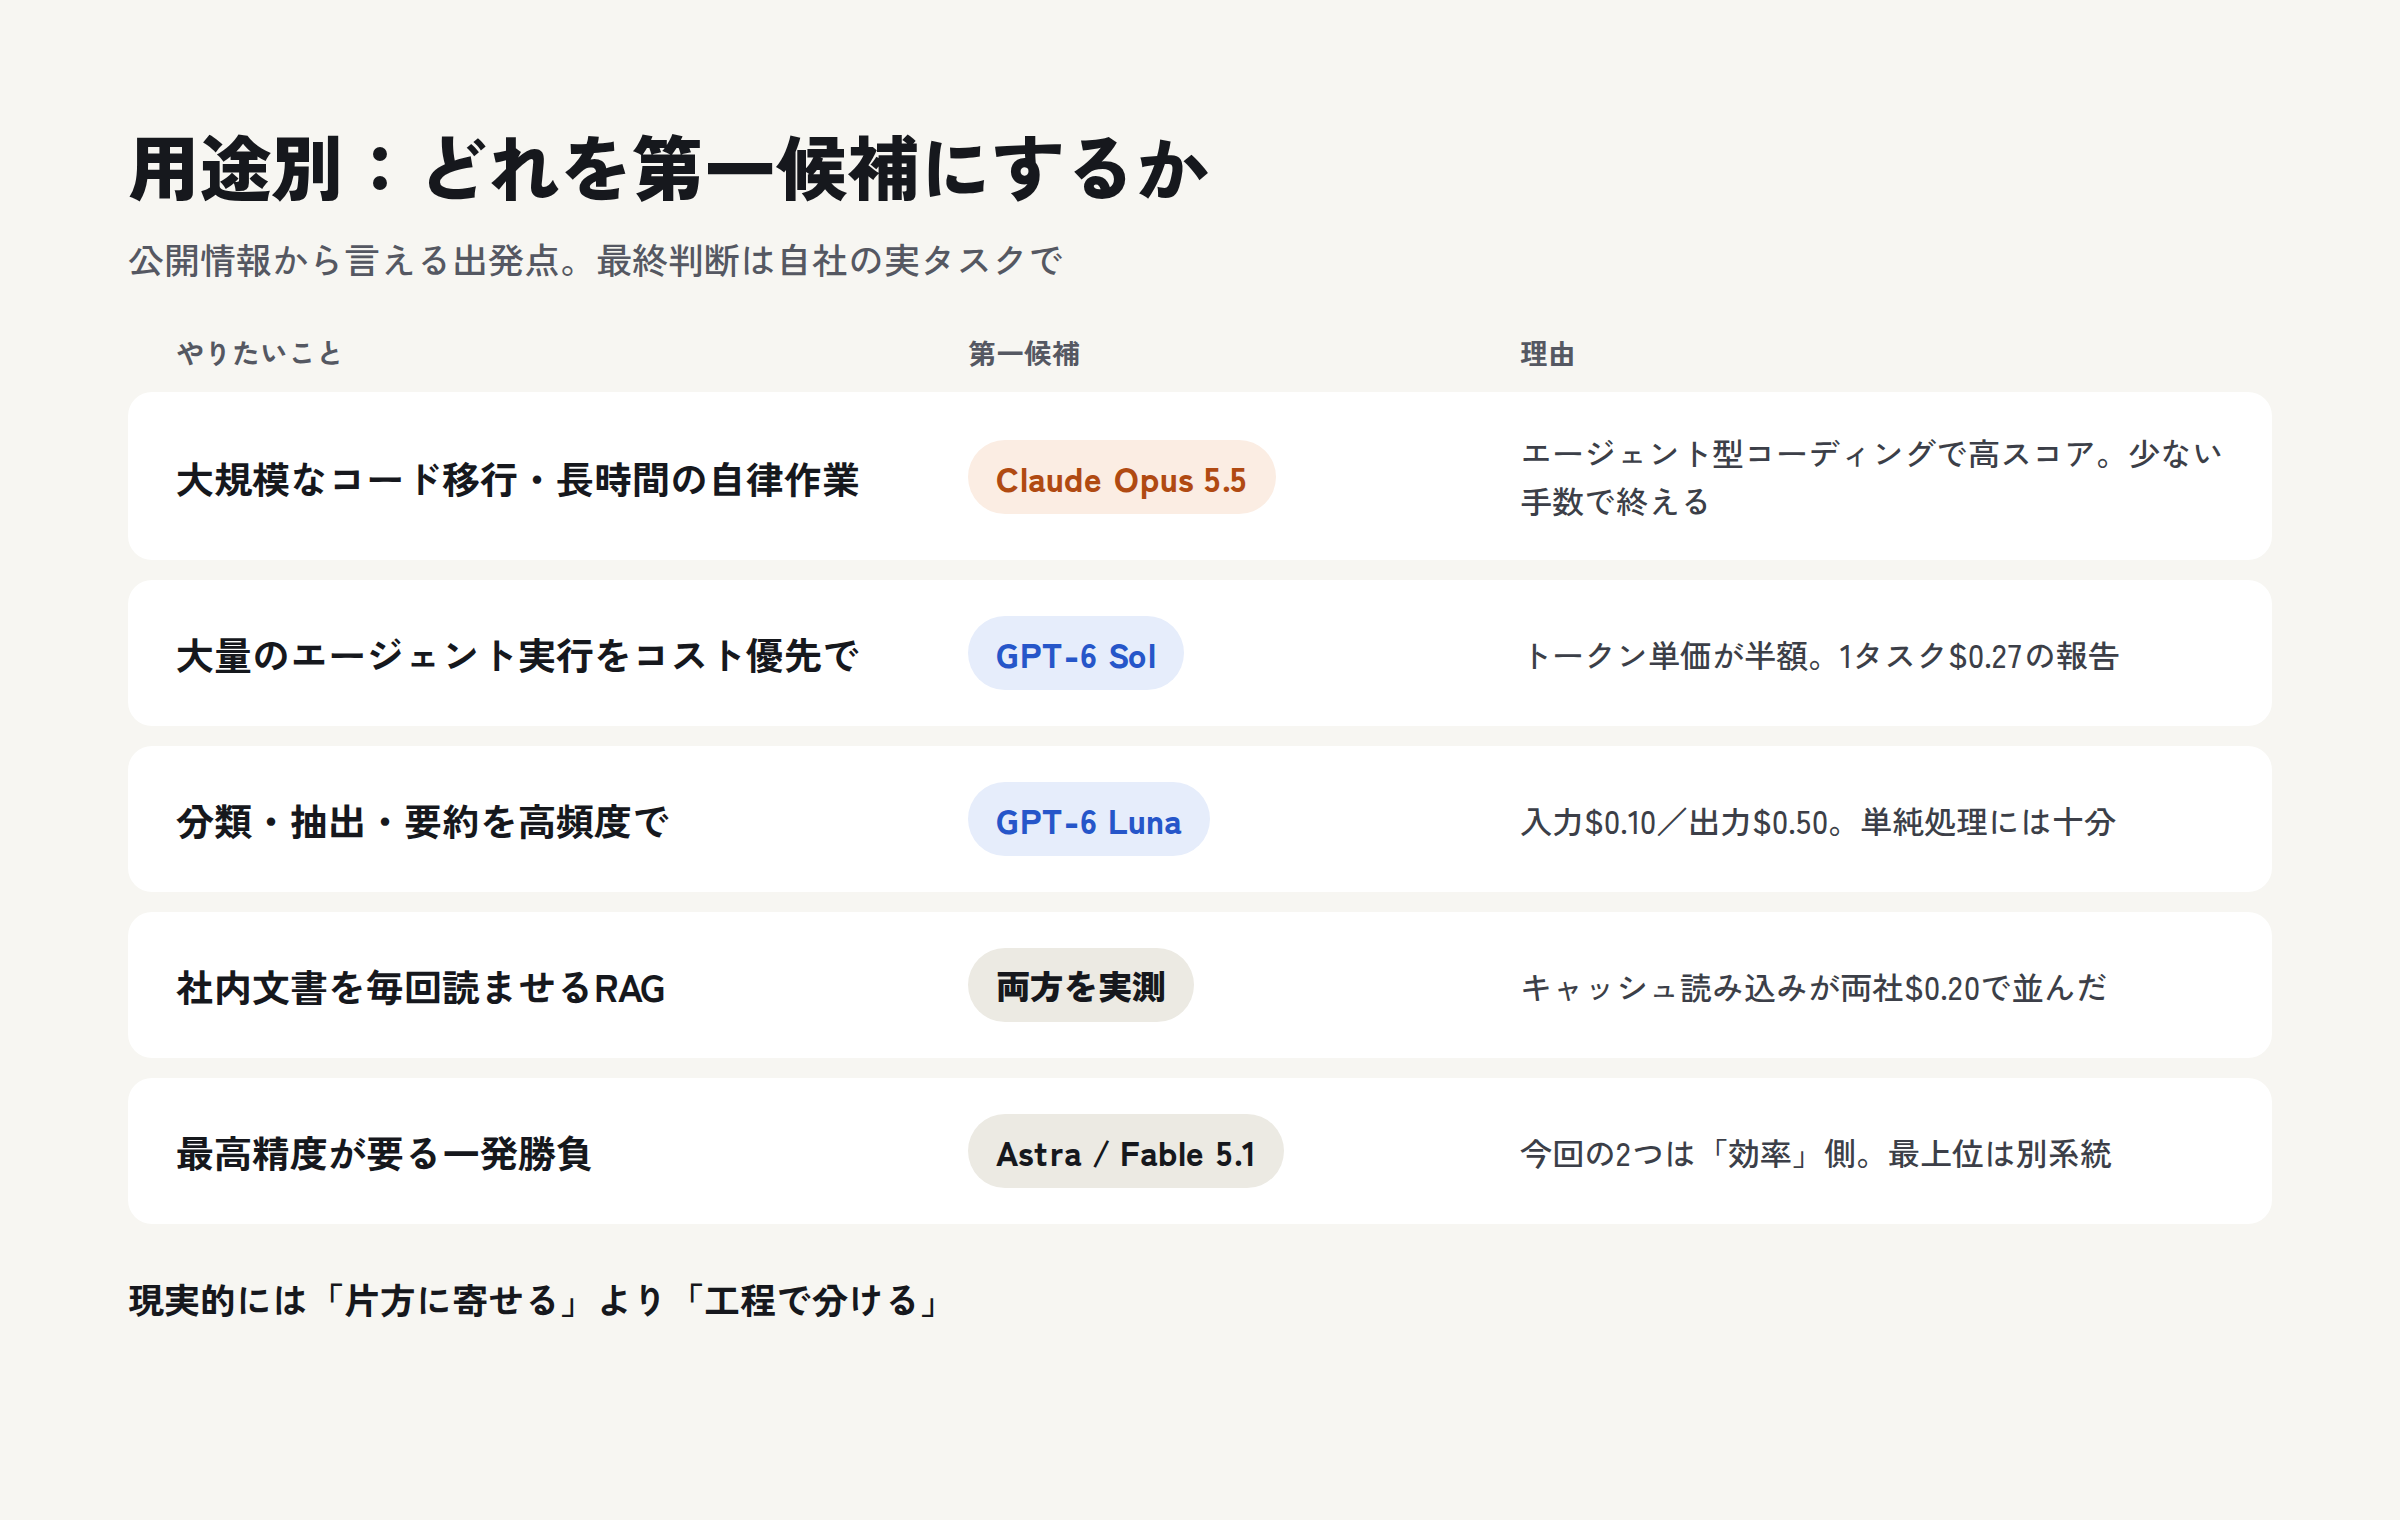
現時点の公開情報から言える、実務的な切り分けです。断定ではなく出発点として使ってください。
やりたいこと | 第一候補 | 理由 |
|---|---|---|
大規模なコード移行・長時間の自律作業 | Claude Opus 5.5 | Terminal-Bench 4.0 / CursorBench で高スコア。手数が少ない方向の効率 |
大量のエージェント実行をコスト最優先で回す | GPT-6 Sol | トークン単価が半額。AutomationBench で1タスク$0.27 |
分類・抽出・要約などの単純処理を高頻度で | GPT-6 Luna | 入力$0.10/出力$0.50。DeepSWE 66.6%と単純処理には十分 |
社内文書を毎回読ませるRAG | 両方を実測 | キャッシュ読み込みが両社$0.20で並んだ。総額は前提の長さ次第 |
最高精度が要る一発勝負 | GPT-6 Astra / Claude Fable 5.1 | 今回の2つは「効率」側。最上位は別系統 |
現実的な運用は「片方に寄せる」ではなく「工程で分ける」です。 設計とレビューは片方、実装と大量処理はもう片方、という分担は、Claude CodeとCodexの交代勤務で具体的な手順を紹介しています。書いたAIと別のAIにレビューさせると、書いた側には出しにくい指摘が出ます。
8. AI受託開発の現場で、何が変わるか
Mojiでは日常的に両社のモデルを実案件で使っています。今回の値下げで、現場の判断が変わるのは次の3点です。
1. PoCの「やってみる」閾値が下がった。 これまで「APIコストが読めないから、まず要件を固めてから」と後回しにしていた検証を、先に回せるようになります。特にLunaの入力$0.10は、数万件の社内文書を一度全部通して傾向を見る、といった使い方を現実的にします。「どの業務から手をつけるか」の判断材料としてのPoCが安くなった、という意味です。着手順の考え方は生成AI導入前の業務棚卸しで整理しています。
2. 「高いモデルを使うべきか」の議論の前提が変わった。 これまでは「精度が要るなら高いモデル、コストが要るなら安いモデル」という二択でした。今回、両社とも「上位モデル相当の性能を下位価格で」と主張しています。議論の焦点は「どのモデルか」から「1タスクを何手で終わらせる設計か」に移ります。 プロンプトとツール設計で手数を減らすほうが、モデル選定より効く場面が増えます。
3. 既存プロジェクトの見積もり前提が古くなった。 2026年前半に組んだ運用コスト試算は、今回の改定で実態とずれます。特にキャッシュ読み込みが総額の大半を占める設計では、試算し直す価値があります。請求内訳を開いて、入力・出力・キャッシュの比率を確認するところから始めてください。
自社のワークロードで、実際にいくら変わるのか。 Mojiでは、既存のAI機能の利用実績をもとに、モデル変更でコストと精度がどう動くかの試算と、実タスクでの比較検証をお手伝いしています。「単価表を見てもうちの場合が分からない」という段階からご相談ください。 無料相談する
9. 移行するなら:Opus 5.5 の破壊的変更に注意
Opus 5 から Opus 5.5 に切り替える場合、APIの挙動に変更があります。既存実装がそのまま動くとは限りません。
- 適応的思考が常時オンになった(
effortパラメータで制御) - 強制ツール使用(forced tool use)がエラーを返す場合がある
- thinking ブロックが特定のモデル・会話に紐づくようになった
- 古い
computer_20251124ツールは拒否される - 安全分類器のカテゴリが増え、一部のリクエストは拒否(
stop_reason: "refusal")として返る
最後の項目は特に注意が必要です。拒否はエラーではなく HTTP 200 で返り、本文は空になります。ステータスコードだけで成否を判定していると「成功」に見えてしまうため、stop_reason を必ず確認してください。fallbacks(ベータ)を設定すれば別モデルで自動再試行できますが、その場合はどのモデルが実際に応答したかをログに残す設計にしておいてください。
どこまでAIに任せ、どこで人間が止めるかの設計はAIをどこまで任せるかで詳しく扱っています。
実際にAPIで試した移行手順はこちら → Claude Opus 5.5とOpus 5を比較【実測】
<!-- GPT 版の公開後に、次の1行を上の行の下に追加 --> <!-- GPT-5.6 Sol からの移行を実測した記事はこちら → [GPT-6 SolとGPT-5.6 Solを比較【実測】](https://www.moji-inc.com/articles/gpt-6-sol-vs-gpt-5-6-sol) -->
10. 背景:「フロンティアのペース調整」という文脈
今回の同日発表が「性能」ではなく「効率」だったことには、業界の文脈があります。
2026年7月、フロンティアAI企業の従業員1,386名が署名した Pacing the Frontier(フロンティアのペース調整) という声明が公開されました。署名者には Anthropic CEO のダリオ・アモデイ氏、Safe Superintelligence CEO のイリヤ・サツキヴァー氏、Google DeepMind 共同創業者のシェーン・レッグ氏らが名を連ねています。声明は、AIの能力向上が社会の適応速度を超えつつあるとして、米国政府に対し「自動化されたAI研究のフロンティアを意図的にペース調整するための技術的・ガバナンス的手段」を国際的に整備するよう求めるものです。
Anthropicは Opus 5.5 を「フロンティアのペース調整を呼びかけて以降、最初のリリース」と位置づけています。能力の大幅な引き上げではなく、コストと速度と安全性に振った発表であることは、この文脈と整合します。Opus 5.5 には EU AI Act に対応した電子透かしや、サイバー・バイオ領域の利用制限、検証済み組織向けのプログラムが併せて発表されました。
一方で、同じ日に両社が競って値下げしている構図を「ペース調整」と呼べるかは議論があります。値下げは利用量を増やす施策でもあるからです。 この点は各社の主張と実態を分けて見る必要があり、AIのリスクの観点からも、導入する企業側が自分で判断すべき領域です。
11. よくある質問
Q. 結局どっちを使えばいいですか? 現時点の公開情報だけでは決められません。自社の実タスク10〜20件で両方を同じ条件で走らせ、「所要時間」「手数」「総額」「失敗率」の4つを記録してください。単価が半分でも手数が倍なら総額は同じです。
Q. GPT-6 Luna は無料で使えますか? ChatGPTの無料ユーザーとGoユーザーは、デスクトップアプリからLunaを利用できます。Sol はPlus / Pro / Business / Enterprise / Edu 向けです。API利用は別料金です。
Q. Claude Opus 5.5 と GPT-6 Astra、どちらが上位ですか? 系統が違うため「上位/下位」では比較できません。Astra は9月3日発表のOpenAI最上位モデル、Opus 5.5 は Anthropic が「Fable 5.1 相当を低コストで」と位置づけたモデルです。OpenAI自身、AutomationBench で Astra(low)より Sol(xhigh)のほうが高スコアかつ低コストだったと報告しています。同一ブランド内ですら、評価と設定次第で順位が入れ替わります。
Q. 既存のOpus 5を使い続けても問題ありませんか? 当面は利用できますが、Opus 5.5 のほうが安く速いため、移行の経済合理性はあります。ただし第9章の破壊的変更があるため、検証なしの切り替えは避けてください。
Q. ベンチマークのスコアはどこまで信じていいですか? 「候補を絞る材料」としては有用、「採用を決める材料」としては不十分、が実務的な答えです。第6章のとおり、両社の数字は測定条件が揃っていません。自社データでの小規模評価に勝る材料はありません。
Q. この記事の数字はいつまで有効ですか? 2026年9月23日時点の公式発表に基づきます。この領域は料金改定が頻繁です。契約や見積もりに使う前に、必ず各社の公式料金ページで最新を確認してください。
12. まとめ:値段が下がった日は、設計を見直す日
2026年9月22日、AnthropicとOpenAIが同じ日に新モデルを発表しました。共通していたのは「もっと賢く」ではなく「もっと安く」です。Opus 5.5 は実行コスト約40%減・出力30%以上高速化、GPT-6 Sol / Luna はトークン単価を半額にしました。
ただし、単価表の比較だけで乗り換え先は決まりません。両社のベンチマークは条件が揃っておらず、そのまま並べれば結論はどうにでも書けてしまいます。決め手になるのは、自社の実タスクで測った総額と失敗率です。
そして値下げが効くのは、モデルを入れ替えたときだけではありません。1タスクを何手で終わらせるか——プロンプト、ツール設計、工程の分け方。ここを見直すほうが、モデル選定より総額に効く場面が増えてきました。値段が下がった日は、設計を見直す日でもあります。
Mojiは、AI受託開発の現場で両社のモデルを実案件に使いながら、「どのモデルを選ぶか」ではなく「その業務をAIでどう設計するか」から一貫して支援しています。既存AI機能のコスト試算の見直し、実タスクでのモデル比較検証、PoCから本番までの設計。どの段階からでもご相談ください。
AI開発のコスト設計、まずは無料相談から
「うちのワークロードだと結局いくら変わるのか」「モデルを変えるべきか、設計を変えるべきか」「PoCをどこから始めるか」は、業務の内容とデータ量で答えが変わります。Mojiでは、現在の利用実績をもとにした試算と、実タスクでの比較検証をお手伝いしています。
[AI新規事業デザイン開発支援の詳細を見る] / 無料相談する
関連記事
- 大規模言語モデル(LLM)とは?
- AIエージェントとは?
- エージェント型AI(Agentic AI)とは?
- AIの評価とは?評価指標や評価方法、その費用について
- LLM as a judge(自動評価)とは?
- ハルシネーションとは?
- Claude CodeとCodexを「交代勤務」させる全手順
- AIエージェントはどこまで任せるべきか
- 生成AI導入前の業務棚卸し
- Claude Opus 5.5とOpus 5を比較【実測】
出典(2026年9月23日時点。9月24日に一部追加)
- Anthropic「Introducing Claude Opus 5.5」 https://www.anthropic.com/claude-opus-5-5
- Anthropic「Refusals and fallback」 https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- Anthropic「Effort」 https://platform.claude.com/docs/en/build-with-claude/effort
- OpenAI「Introducing GPT-6 Sol and Luna」 https://openai.com/index/introducing-gpt-6-sol-and-luna/
- OpenAI「GPT-6 Sol モデル仕様」 https://developers.openai.com/api/docs/models/gpt-6-sol
- OpenAI「Changelog」(GPT-6 Luna のキャッシュ料金) https://developers.openai.com/api/docs/changelog
- OpenAI「Prompt caching」(キャッシュ書き込みの料金) https://developers.openai.com/api/docs/guides/prompt-caching
- OpenAI「News」 https://openai.com/news/
- OpenAI「ChatGPT リリースノート」 https://help.openai.com/en/articles/6825453-chatgpt-release-notes
- Pacing the Frontier(2026年7月の声明) https://www.pacingthefrontier.com/
- VentureBeat「Anthropic releases Claude Opus 5.5...」 https://venturebeat.com/technology/anthropic-releases-claude-opus-5-5-beating-fable-5-1-on-key-agentic-benchmarks-at-60-cheaper-api-price
- MarkTechPost「Anthropic Claude Opus 5.5 release」 https://www.marktechpost.com/2026/09/22/anthropic-claude-opus-5-5-release/
- endoflife.date「Anthropic Claude」(モデル別リリース日) https://endoflife.date/claude