【Chat GPT最新アップデート】GPT-6 SolとGPT-5.6 Solを比較(2026年9月版)
Contact
AI活用の相談、まずは無料で承っています
コラムで取り上げたテーマについて、貴社への適用可能性をお気軽にご相談ください。

Kohei Uesugi
株式会社Moji ビジネス開発・コンテンツマーケティング担当 鹿児島県出身。大学2年次から複数のスタートアップで長期インターンを経験し、営業・事業開発と0→1の立ち上げに携わる。2026年9月より、生成AI特化の開発会社・株式会社Mojiに参画。AI開発プロジェクトの事業開発と運営体制づくりを担当しながら、自社メディアのコンテンツ運用をリードしている。
この記事の結論(30秒版)
比較軸 | |
|---|---|
質 | 易しいコード・抽出・文章タスクでは差なし(どちらも全問正解)。3Dシーン生成では3お題ともGPT-6 Solのほうが作り込みが上だった |
コスト | 既定設定で約4〜5割安い(6タスク合計 −44%、3Dシーン3本合計 −49%)。単価が半額になったため |
速度 | ほぼ同じ(6タスク合計 34.3秒→34.6秒、3Dシーン3本合計 5.4分→6.1分) |
回答の長さ | 約6割短くなった(平均1,399字→528字)。見出しと箇条書きがほぼ消えた |
エラー | GPT-5.6 Sol で通るリクエストは、GPT-6 Sol でもすべて通った(25パターンで確認) |
- GPT-6 Sol は GPT-5.6 Sol の半額のモデルです(入力 $4→$2、出力 $20→$10/100万トークン)。OpenAI は「破壊的変更はない」としており、私たちの実測でも、GPT-5.6 Sol で通るリクエストはすべてそのまま通りました。
- ただし、エラーが出ないことと、同じように動くことは別です。 実測では、エラーを出さずに次のような変化がありました。
・回答が約6割短くなり、見出しと箇条書きがほぼ消えました。
verbosityをhighにしても長さは戻らず、プロンプトで「見出しと箇条書きで詳しく」と指示すると戻りました。・推論に使うトークンが約5割増えました。 ただし単価が半額なので、費用は約4割減です。
・effort は6段階(none〜max)すべて使えました。 公式ドキュメント同士で記載が食い違っていた点です。
maxでも費用は既定(medium)の約2倍にとどまりました。・新機能の非同期ツール(
async: true)は、ツールの結果を待たずに「取得できませんでした」と答えて会話を終えることがありました。 同じツールを何度も呼び直す挙動も出ました。 - この記事では、公式の移行ガイドと実測結果をもとに、GPT-5.6 Sol から GPT-6 Sol に切り替える前に確かめたいことをチェックリストにまとめました。
※本記事は2026年9月24日時点の OpenAI 公式ドキュメントと、同日の実測に基づきます。 新モデルの概要や Claude との比較は、Claude Opus 5.5とGPT-6 Sol・Lunaの比較をご覧ください。
- 他のGPT関連の記事はこちら!
この記事の検証について
公式ドキュメントを読むだけでは、「回答の見た目がどれくらい変わるのか」「費用が実際にいくら下がるのか」は分かりません。そこで、株式会社MojiのAI開発チームが OpenAI API を実際に呼び出して確かめました。
項目 | 内容 |
|---|---|
実施日 | 2026年9月24日(GPT-6 Sol 公開の2日後) |
環境 | OpenAI API(Responses API を中心に、一部 Chat Completions)、Python から HTTP で直接呼び出し |
比較対象 |
|
検証内容 | ① パラメータの互換性 25パターン ② effort 別の品質・費用・時間(自動採点の6タスク) ③ ツール呼び出し前の一言(4条件) ④ 回答の長さ(5問×2回、追加で verbosity 別に3問) ⑤ プロンプトキャッシュ ⑥ 非同期ツール(3問×3条件×2回) ⑦ 3Dシーン生成による見た目の質(3お題×2モデル) |
費用 | 合計 約$1.7 |
限界もあります。 各条件の試行回数は1〜2回と少なく、タスクも比較的易しいものです。数字は「傾向を見るための参考値」として読んでください。自社の判断には、第7章の手順で自社のタスクを使って測ることをおすすめします。検証の詳細は付録にまとめています。
1. 同じお題で3Dシーンを作らせた:GPT-5.6 Sol vs GPT-6 Sol
「新しいモデルは本当に良くなったのか」を一番分かりやすく確かめるために、ブラウザで動く3Dシーンを両モデルに作らせて並べました。
条件(公平にするために決めたこと)
- お題は3つ:日本庭園/雨の夜の路地/太陽系
- 1つの HTML ファイルで完結させ、形はすべてコードで作る(画像や3Dモデルのファイルは使わない)。Three.js(r160)を使用
- effort は両モデルとも既定値(どちらも
medium)。移行した人が、設定を変えずに体験する差です - 1回目の出力をそのまま、ページを開いて6秒後の画面を撮影。良い結果だけを選ぶことはしていません
- 6本とも、ブラウザのエラーなく動きました
1-1. 雨の夜の路地:看板と濡れた路面の GPT-6 Sol
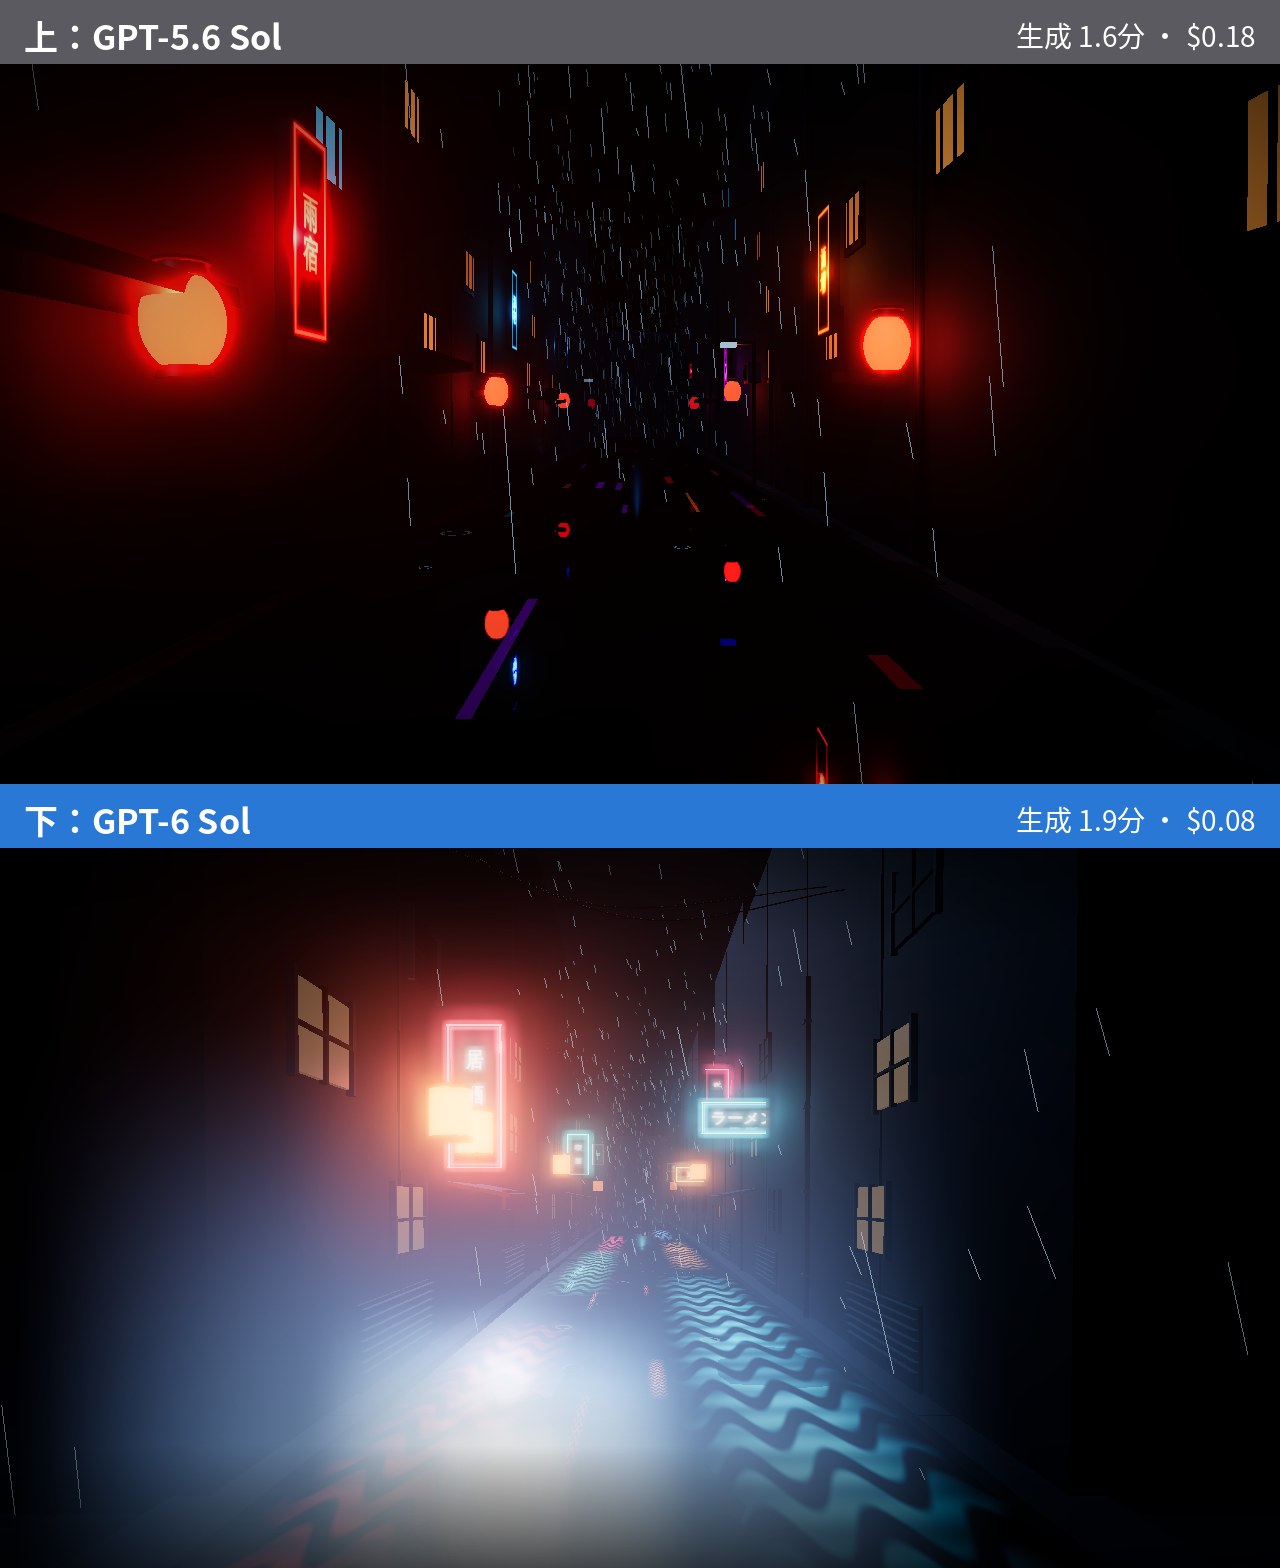
- GPT-5.6 Sol:画面の大部分が暗く、赤い提灯と「雨宿」の縦看板が浮かぶ。雰囲気はあるが、路地の様子は読み取りにくい
- GPT-6 Sol:「ラーメン」「居酒屋」のネオン看板、格子の窓、電線、光を映す濡れた路面。路地としての情報量がはっきり多い。ただし、路面の反射が波模様になっていて、やや不自然に見える部分もあります
- 費用は GPT-6 Sol が半額以下($0.08 vs $0.18)。生成時間は GPT-6 Sol のほうが少し長め(1.9分 vs 1.6分)でした
1-2. 日本庭園:構図の GPT-6 Sol
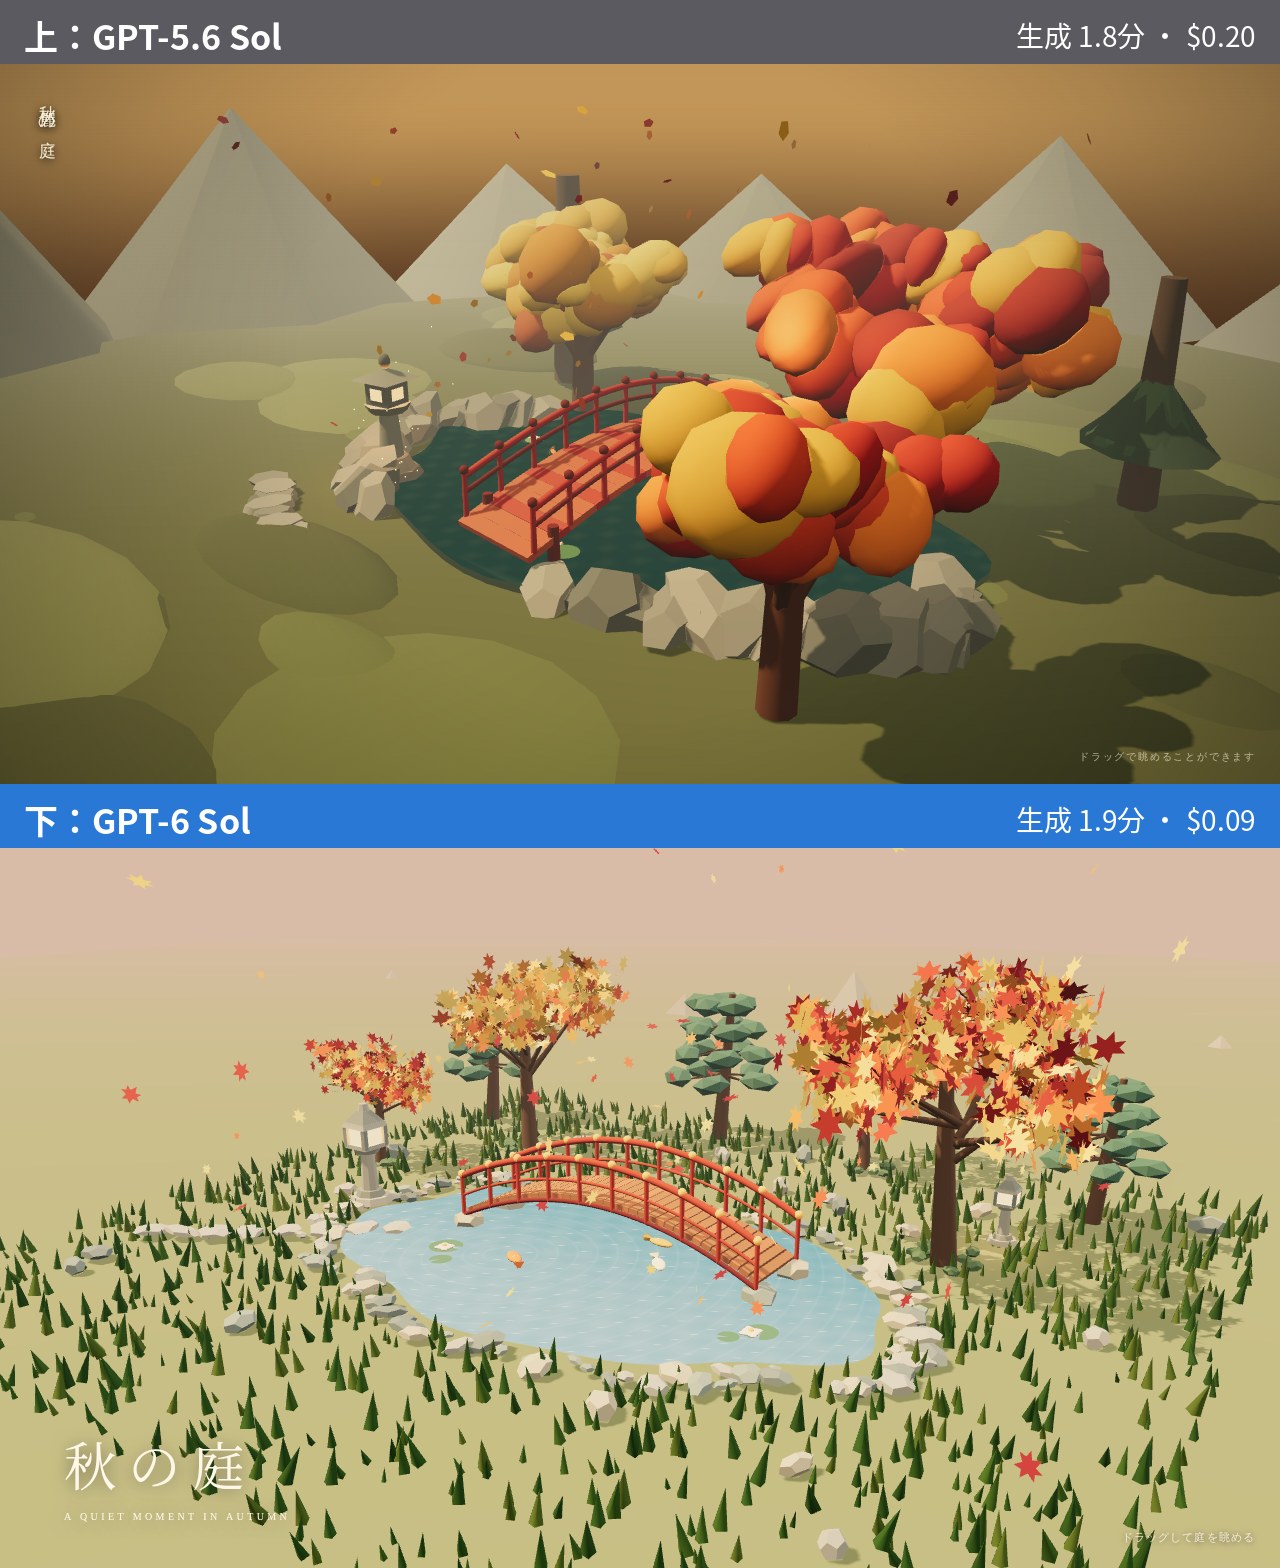
- どちらも「秋の庭」を選び、赤い橋・石灯籠・紅葉を置いたのは同じでした
- GPT-5.6 Sol:丸い紅葉の木が手前に大きく立ち、池と橋の半分が隠れている
- GPT-6 Sol:池の全体、泳ぐ鯉、睡蓮の葉、赤い橋、石灯籠2基、松が一望できる。紅葉の葉もカエデの形で、画面左下には「秋の庭」のタイトルまで入る。一枚の絵としての構図が上です
- 費用は $0.09 vs $0.20。生成時間はほぼ同じ(1.9分 vs 1.8分)
1-3. 太陽系:教材としての完成度は GPT-6 Sol
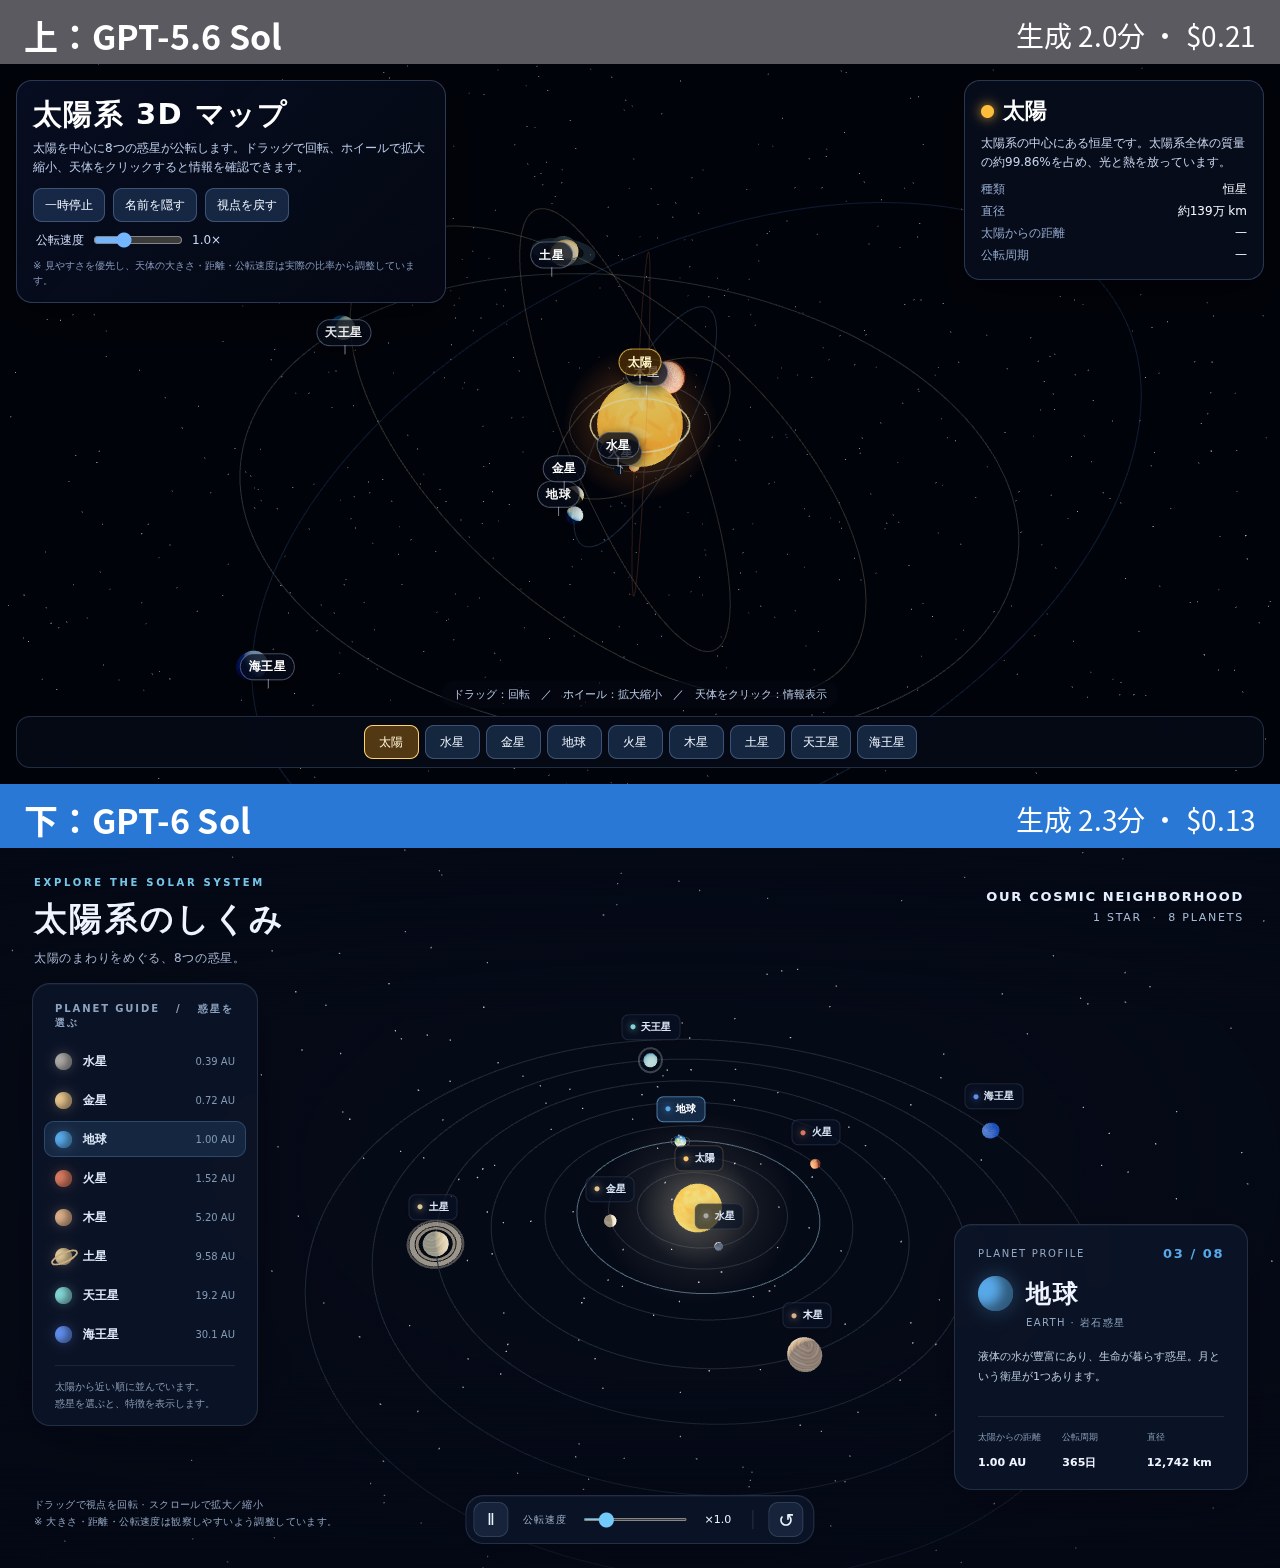
- GPT-5.6 Sol:操作ボタンや太陽の解説パネルはあるが、惑星の軌道が斜めに交差し、太陽の近くで名前のラベルが重なっている
- GPT-6 Sol:同心円の軌道、太陽からの距離(AU)つきの惑星一覧、選んだ惑星(地球)の解説カード。教材としてそのまま使えそうな画面です
- 費用は $0.13 vs $0.21。生成時間は GPT-6 Sol のほうが長め(2.3分 vs 2.0分)でした
1-4. 3本を通して言えること
GPT-5.6 Sol(既定=medium) | GPT-6 Sol(既定=medium) | |
|---|---|---|
見た目の評価 | — | 3お題とも上(路地の路面反射には不自然さあり) |
生成時間(3本合計) | 5.4分 | 6.1分 |
費用(3本合計) | $0.58 | $0.30 |
出力トークン(3本合計) | 29,044 | 29,594 |
動作エラー | なし | なし |
- 出力トークンの量はほぼ同じ(+2%)なのに、費用は約半分。単価の値下げがそのまま効いています
- 生成時間は GPT-6 Sol のほうが約1割長くなりました。3本とも2分前後なので、体感の差は小さいです
- 3本とも GPT-6 Sol が上、という結果は私たちの主観による評価です。各お題1回ずつの比較なので、「傾向」として読んでください
この先の章では、見た目では分からない費用・回答の長さ・エラーの出方の違いを、移行チェックリストの形で整理します。
2. 質・速度・コストを比べる:そもそも移行すべきか
2-1. 料金と基本スペック
GPT-5.6 Sol を本番で使っているなら、移行する経済的な理由は十分にあります。
項目 | GPT-5.6 Sol | GPT-6 Sol |
|---|---|---|
入力(100万トークンあたり) | $4 ※ | $2 |
キャッシュ読み込み | $0.40 ※ | $0.20 |
キャッシュ書き込み(入力の1.25倍) | $5 ※ | $2.50 |
出力 | $20 ※ | $10 |
27.2万トークンを超える入力 | 入力2倍・出力1.5倍 | 入力2倍・出力1.5倍 |
コンテキスト/最大出力 | 105万/12.8万 | 105万/12.8万 |
知識のカットオフ | 2026年2月16日 | 2026年4月20日 |
reasoning.effort | none/low/medium(既定)/high/xhigh/max | 同じ |
レート制限(Tier 1〜5) | 同じ | 同じ |
※ GPT-5.6 Sol の価格は、2026年11月21日までのキャンペーン価格です(8月21日に入力20%、出力33%値下げ)。
GPT-6 Sol は Batch/Flex で50%割引、Fast モードは標準の2倍の料金です。
2-2. 質:易しいタスクでは差が出なかった
Python の関数3問、数え上げ1問、請求書からのデータ抽出1問、条件つきのメール作成1問を自動採点したところ、両モデルとも、どの effort でも全問正解でした(GPT-6 Sol は none から max までの6段階すべてで6/6)。
日常的なコード生成や抽出のレベルでは、「GPT-6 Sol にすると賢くなる」と体感できる差はない、というのが正直な結果です。差が出たのは、作り込みが問われる大きな生成物(第1章の3D)と、回答の書き方(第5章①)でした。
2-3. コストと速度
同じ6タスクを「どちらも effort を指定しない(=既定値)」で流した結果です。
GPT-5.6 Sol(既定) | GPT-6 Sol(既定) | 差 | |
|---|---|---|---|
正解数 | 6/6 | 6/6 | — |
出力トークン | 1,509 | 1,722 | +14% |
うち推論トークン | 519 | 789 | +52% |
費用 | $0.0334 | $0.0188 | −44% |
合計時間 | 34.3秒 | 34.6秒 | ほぼ同じ |
トークンは増えたのに、費用は4割以上減りました。 単価が半額になった分が、トークン増を上回っています。high 同士で比べても、費用は約41%減($0.0394→$0.0233)、出力トークンは約20%増でした。
つまり GPT-6 Sol は、「同じ作業を少ないトークンで終える」モデルではなく、**「少し多く考えるが、1トークンあたりが半額」**のモデルです。移行後に請求額がどこまで下がるかは、この2つの綱引きで決まります。
3. 全体像:移行で変わる5つのこと
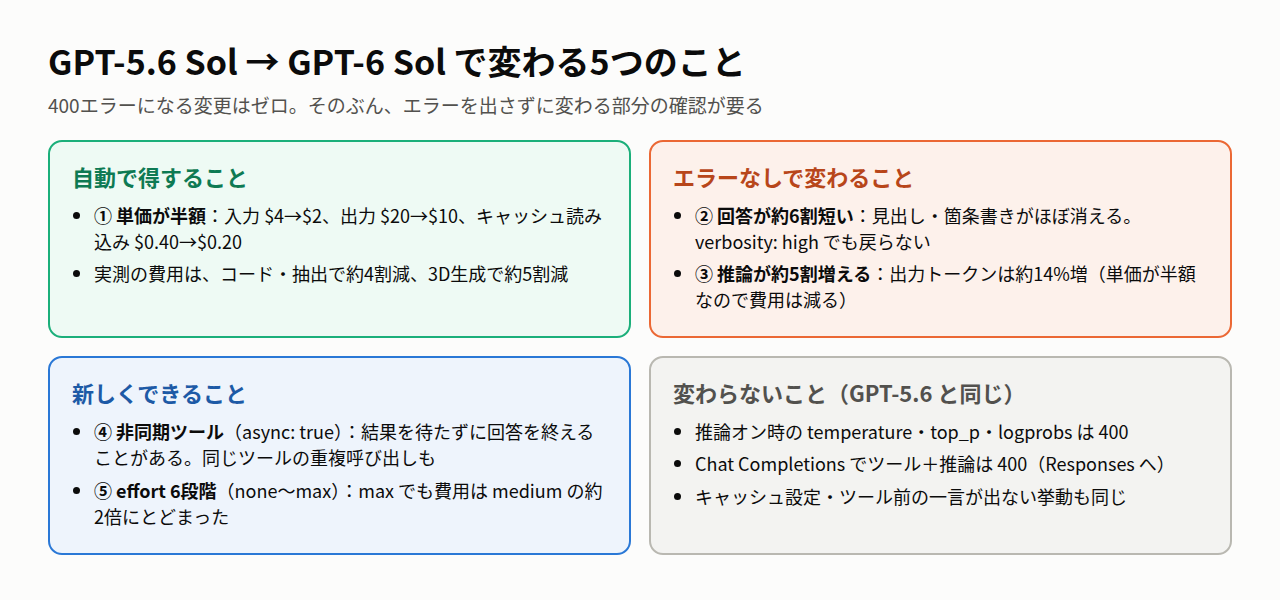
区分 | 変更 | 気づき方 |
|---|---|---|
自動で得する | ① 単価が半額 | 請求書で気づく |
エラーなしで変わる | ② 回答が約6割短くなり、見出し・箇条書きがほぼ消える | 気づきにくい。画面の見え方が変わる |
③ 推論トークンが約5割増える | 気づきにくい。 | |
新しくできる | ④ 非同期ツール( | 自分で有効にしたときだけ。結果を待たずに回答を終えることがある |
⑤ effort 6段階と、 | 公式ドキュメントの記載が食い違っていたので実測で確認 |
GPT-5.6 Sol からの移行では、400エラーになる変更は見つかりませんでした。 そのぶん「テストは通るのに、ユーザーの画面では何かが変わっている」という形の変化が中心です。
4. 変わらないこと:GPT-5.6 Sol と同じ制約(エラー文言つき)
GPT-5.6 Sol で動いているコードなら、ここは読み飛ばしてかまいません。GPT-5.5 以前から直接移行する場合や、新しくコードを書く場合に引っかかりやすい制約を、実際に返ってきたエラー文言と一緒にまとめます。どれも GPT-5.6 Sol と GPT-6 Sol で同じ結果でした。
送ったもの | 結果(両モデル共通) |
|---|---|
| 400: |
| 400: |
| 400: |
| 400: |
上の3つを effort | 200(使える) |
Chat Completions でツール定義を送る(effort 指定なし) | 400: |
Chat Completions でツール定義+ | 200(ツールが呼ばれた) |
| 400: |
| 200 |
| 200 |
| 400: |
| 200(ツールが強制的に呼ばれた) |
特に注意したいのは、Chat Completions でツールを使うときは、effort を指定していなくても400になる点です。effort の既定値が medium なので、「推論ありでツールを使った」扱いになります。Chat Completions のまま使うなら reasoning_effort: "none" を明示し、推論とツールを両方使いたいなら Responses API に移る必要があります。
公式の移行ガイドは、GPT-5.5 以前から移る場合に prompt_cache_retention を prompt_cache_options.ttl: "30m" に置き換えるよう勧めています。実測では prompt_cache_retention: "24h" もエラーにはなりませんでしたが、公式の案内どおり新しい書き方に移しておくのが安全です。
ツールの強制指定(tool_choice: "required")がそのまま使えるのは、Claude からの乗り換えを考えている人には大きな違いです。Claude Opus 5.5 では、ツールの強制指定そのものが400になります(Claude Opus 5.5 と Opus 5 の実測比較の第4章②)。
5. エラーにならない変化:ここを確かめる
① 回答が約6割短くなり、見出しと箇条書きがほぼ消える
OpenAI は GPT-6 Sol について「より明快に、専門用語を減らし、価値の低い細部を減らし、全体としてやや短い回答にした」と説明しています。実測してみると、「やや」ではありませんでした。
同じ質問5問(RAG とファインチューニングの違い、生成AI導入の最初の1か月、API のレート制限への対処など)を、両モデルに既定設定で2回ずつ聞いた結果です。
GPT-5.6 Sol | GPT-6 Sol | 差 | |
|---|---|---|---|
回答の文字数(平均) | 1,399字 | 528字 | −62% |
見出し(1回答あたり) | 7.6個 | 0.4個 | ほぼ消えた |
箇条書き・番号付きの行(1回答あたり) | 25.7行 | 1.0行 | ほぼ消えた |
出力トークン(平均) | 979 | 432 | −56% |
応答時間(平均) | 14.7秒 | 7.9秒 | −46% |
費用(10回の合計) | $0.197 | $0.044 | −78% |
たとえば「RAG とファインチューニングの違いを、社内の非エンジニア向けに説明して」への回答は、次のように変わりました(要約)。
- GPT-5.6 Sol(959字):「一言でいうと」「たとえ話」「主な違い」「どちらを選ぶべきか」の見出しつき。箇条書きと比較表を組み合わせた、資料のような構成
- GPT-6 Sol(500字):冒頭の1文で結論、比較表1つ、具体例を1段落、最後に1文でまとめ。見出しも箇条書きもなし
内容が薄くなったわけではなく、同じ要点を、表と短い文章で言い切る書き方に変わった、という印象です。チャット画面ではむしろ読みやすくなります。
一方で、困るケースもあります。
- 回答をそのまま社内資料や FAQ として保存している:見出しがなくなり、構成が変わる
- Markdown の見出しや箇条書きを前提に、後段で分割・整形している:分割のきっかけになる記号が出てこない
- 「詳しい回答」が価値になっているサービス:ユーザーから「前より雑になった」と見える可能性がある
verbosity を上げれば戻るのか
OpenAI の API には、回答の長さを調整する text.verbosity(low / medium / high)があります。これで元に戻るかを、3問で確かめました。
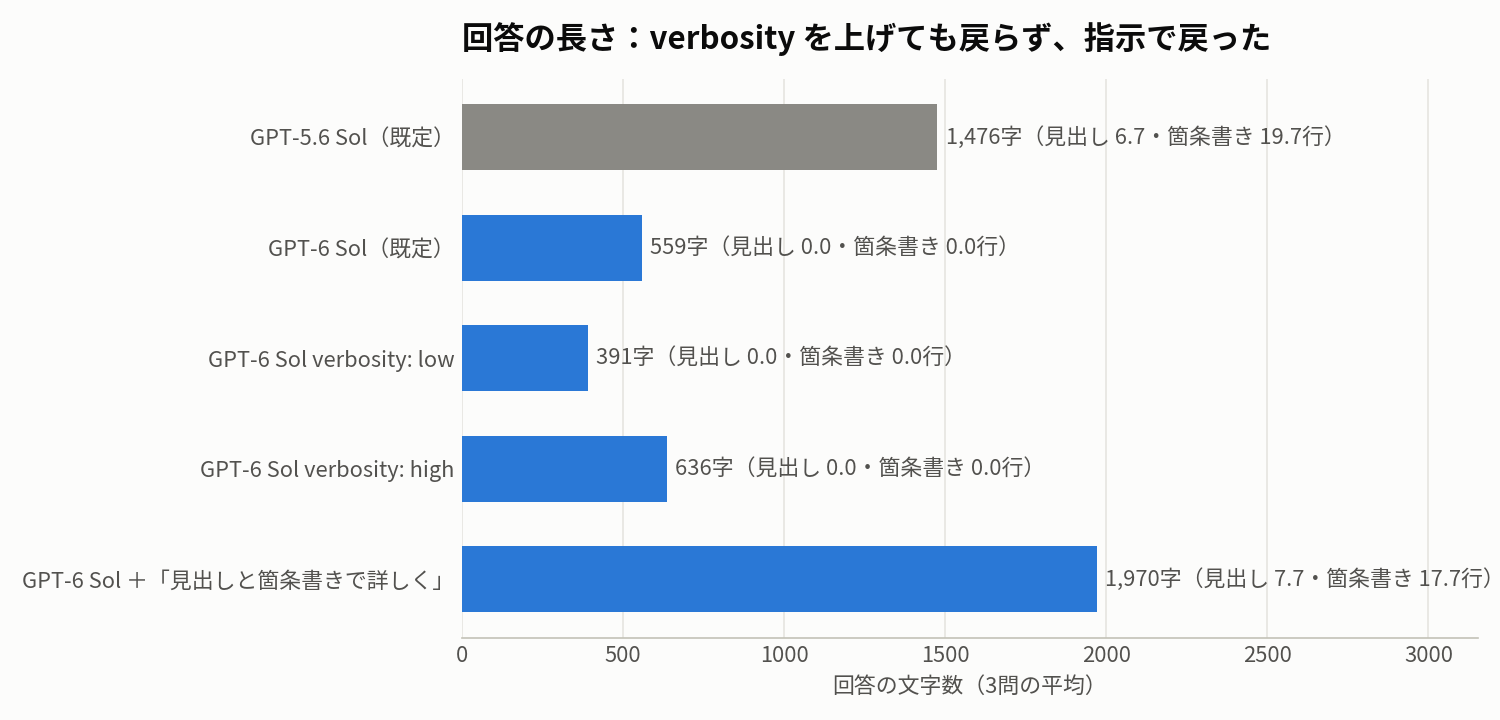
条件(3問の平均) | 文字数 | 見出し | 箇条書き | 応答時間 |
|---|---|---|---|---|
GPT-5.6 Sol(既定= | 1,476字 | 6.7個 | 19.7行 | 15.9秒 |
GPT-6 Sol(既定= | 559字 | 0個 | 0行 | 7.5秒 |
GPT-6 Sol | 391字 | 0個 | 0行 | 5.9秒 |
GPT-6 Sol | 636字 | 0個 | 0行 | 8.7秒 |
GPT-6 Sol +指示「見出しと箇条書きを使って、網羅的に詳しく説明してください」 | 1,970字 | 7.7個 | 17.7行 | 27.9秒 |
verbosity: "high" にしても、長さは1割ほどしか戻りませんでした。 見出しと箇条書きも出ません。一方、instructions(システムプロンプト)に1文足すと、GPT-5.6 Sol より長い回答が返ってきました。ただし応答時間も約2倍になっています。
私たちのおすすめは次のとおりです。
- チャット画面で使っている:まずは既定のまま、短くなった回答をユーザーに見せて反応を確かめる
- 資料・FAQ・レポートの生成に使っている:「見出しと箇条書きを使う」「〇〇字程度で」など、欲しい形をプロンプトで明示する
- 後段で Markdown を解析している:出力形式の指示に加え、structured outputs(JSON スキーマ)への切り替えを検討する
- 回答をユーザーに見せている画面で、GPT-6 Sol の回答を実際に表示して確認した
- 回答の形式(見出し・箇条書き・長さ)に依存した後段処理がないか確認した
- 形式が必要な処理は、
verbosityではなくプロンプトで明示した
② 推論トークンが約5割増える
第2章のとおり、同じ6タスクで GPT-6 Sol の推論トークンは約5割増えました(519→789)。3Dシーン3本の合計でも、推論トークンは約37%増えています(4,183→5,710)。
OpenAI API の max_output_tokens は、推論トークンと回答を合わせた上限です。GPT-5.6 Sol でぎりぎりの値にしていた処理は、GPT-6 Sol では回答の途中で打ち切られる可能性があります。今回の検証では打ち切りは起きませんでしたが、上限は余裕を持たせておくのが安全です。
また、レスポンスの output 配列には、回答(message)の前に推論の要約(reasoning)の項目が入ることがあります。実測では、同じ設定でも入る回と入らない回がありました。output[0] を回答だと決め打ちせず、type で読むか、SDK の output_text を使ってください。
max_output_tokensに、推論の増加分を見込んだ余裕を持たせたresponse.status == "incomplete"(incomplete_details.reason: "max_output_tokens")の発生率を、移行前後で比べられるようにしたoutputを位置ではなくtypeで読んでいる
③ effort は6段階。max でも費用は medium の約2倍
GPT-6 Sol で使える effort の段階は、公式ドキュメント同士で記載が食い違っていました。モデル仕様のページは none / low / medium / high / xhigh / max の6段階、モデル選びのガイドは none / low / medium / high の4段階です。
実測では、6段階すべてがエラーなく使えました。 レスポンスにも指定した effort がそのまま記録されていました。存在しない minimal を送ると、使える値の一覧つきで400が返ります(第4章)。
同じ6タスクを、effort を変えて流した結果です。
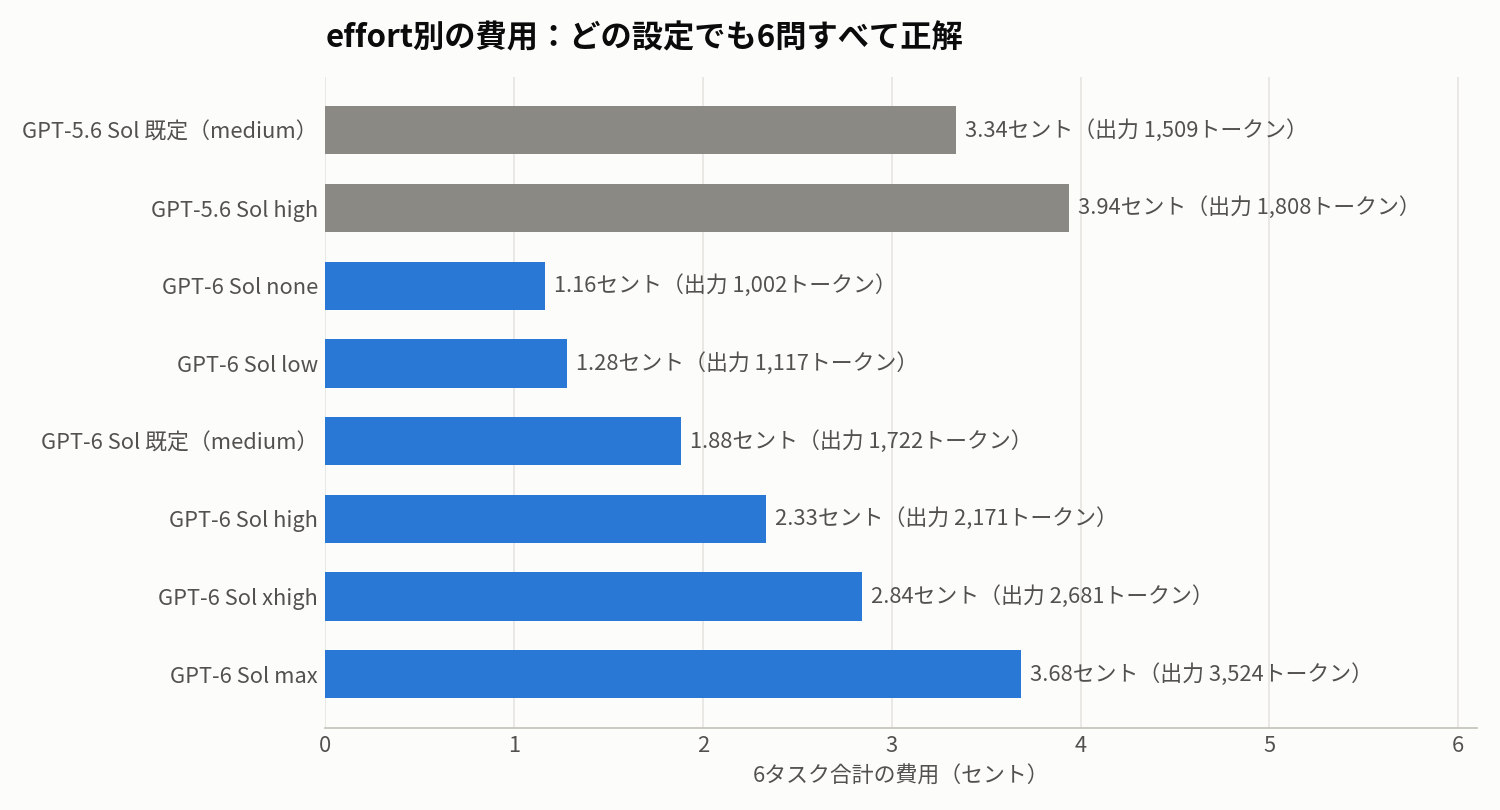
条件 | 正解 | 出力トークン | うち推論 | 費用 | 合計時間 |
|---|---|---|---|---|---|
GPT-5.6 Sol 既定(= medium) | 6/6 | 1,509 | 519 | $0.0334 | 34.3秒 |
GPT-5.6 Sol | 6/6 | 1,808 | 692 | $0.0394 | 30.5秒 |
GPT-6 Sol | 6/6 | 1,002 | 0 | $0.0116 | 18.3秒 |
GPT-6 Sol | 6/6 | 1,117 | 222 | $0.0128 | 25.1秒 |
GPT-6 Sol 既定(指定なし) | 6/6 | 1,722 | 789 | $0.0188 | 34.6秒 |
GPT-6 Sol | 6/6 | 1,669 | 761 | $0.0183 | 32.3秒 |
GPT-6 Sol | 6/6 | 2,171 | 1,303 | $0.0233 | 37.0秒 |
GPT-6 Sol | 6/6 | 2,681 | 1,783 | $0.0284 | 48.1秒 |
GPT-6 Sol | 6/6 | 3,524 | 2,628 | $0.0368 | 52.6秒 |
読み取れることは3つです。
- effort を上げても、費用の増え方はなだらかでした。
maxはmediumの約2倍、xhighの約1.3倍です。同じ日に検証した Claude Opus 5.5 では、maxがxhighの約10倍のトークンを使いました(Claude Opus 5.5 と Opus 5 の実測比較)。同じmaxという名前でも、費用の跳ね方はモデルによって大きく違います - GPT-6 Sol の
maxでも、GPT-5.6 Sol の既定とほぼ同じ費用($0.0368 vs $0.0334)でした。単価が半額になったぶん、一段どころか数段上の effort を同じ予算で使えます none(推論なし)でも全問正解で、時間は既定の約半分でした。今回のタスクが易しかったこともありますが、分類・抽出のような定型処理ではnoneやlowから試す価値があります
- 全呼び出しで effort を明示的に指定した(既定値に頼らない)
- 定型処理は
none/lowで品質が保てるか測った - 品質が必要な処理は、GPT-6 Sol の単価で
high以上に上げる余地がないか検討した
④ ツールを呼ぶ前の「一言」:変わらなかった
エージェント型のアプリでは、ツールを呼ぶ前に「社内FAQを検索します」のような一言を画面に出すことがよくあります。Claude Opus 5.5 ではこの一言が既定で消える変更がありましたが、GPT-6 Sol ではどうかを確かめました(「社内FAQを検索 → 記事を読む → 回答」の2回のツール呼び出し)。
条件 | ツール呼び出し前に一言が出た回数 |
|---|---|
GPT-5.6 Sol:指示なし | 8回中0回 |
GPT-6 Sol:指示なし | 8回中0回 |
GPT-5.6 Sol: | 8回中8回 |
GPT-6 Sol:同じ指示 | 8回中8回 |
両モデルとも、指示しなければ出ず、指示すれば毎回出ました。 挙動は変わっていません。一言のメッセージには phase: "commentary"、最終回答には phase: "final_answer" が付いて返ってきたので、画面側ではこの値で「途中経過」と「回答」を分けて表示できます。
この5つの変化、自社のアプリでどれが効いてくるか分からない場合は。 Mojiでは、既存のAI機能のコードと利用ログを確認し、GPT-6 Sol への移行で影響を受ける箇所の洗い出しと、移行前後の品質・コスト比較をお手伝いしています。この記事の検証も、同じ方法で行いました。 GPT-6 Sol 移行の事前診断を相談する(無料)
6. 新機能:非同期ツールは「結果を待たずに答える」ことがある
GPT-6 系の新機能に、非同期ツール呼び出しがあります。ツール定義に "async": true を付けると、モデルはツールを呼んだあと結果を待たずに作業を続け、結果は後のリクエストで previous_response_id と一緒に渡す、という仕組みです(Responses API のみ)。時間のかかる検索や外部 API を使うAIエージェントで、待ち時間を減らすための機能です。
GPT-5.6 Sol で async: true を送ると、Async tools are not supported with gpt-5.6-sol. という400が返りました。GPT-6 Sol 専用の機能です。
実際に、天気を返すツール(数秒かかる想定)を使って確かめました。3つの質問を、「通常のツール」「非同期ツール」「非同期ツール+指示(結果が届くまで推測や結論を書かない)」の3条件で2回ずつ流しています。
1回目のレスポンス(ツールの結果を渡す前)で何が返ったか
条件 | 最初のレスポンスの中身 | ツール呼び出し回数(6回の合計) |
|---|---|---|
通常のツール | ツール呼び出しだけ(回答はまだ書かない) | 8回 |
非同期ツール | ツール呼び出しに加えて、回答のメッセージまで書いて終わる | 14回 |
非同期ツール+指示 | 同上(ただし「確認中です」系の文面が増えた) | 23回 |
非同期ツールでは、結果が届く前に、モデルが回答のメッセージまで書いてレスポンスを終えました(6回中6回)。問題はその中身です。「東京の天気は?」「大阪と福岡の天気を教えて」の4回のうち、
- 2回は「天気データを取得できませんでした。気象庁の天気予報などでご確認ください」と答えて終わりました。 実際にはツールはまだ実行中で、失敗していません
- 残り2回は「確認しています。取得でき次第お伝えします」でした
「結果が届くまで推測や結論を書かないで」と instructions に入れると、同じ4回で「取得できませんでした」は0回になり、すべて「確認中」の文面になりました。
もう1つ気になったのが、同じツールの呼び直しです。非同期ツールでは、結果を待つ間に同じ引数で同じツールを何度も呼び直す挙動が出ました。「大阪と福岡」の質問では、指示ありの1回で「大阪」「福岡」をそれぞれ4回ずつ、計8回呼んでいます。
なお、結果を後から渡すと、18回すべてで正しい天気を答えました。 2回は「先ほどは取得できないとお伝えしましたが、その後、天気情報が届きました」のように、前の回答を自分で訂正しています。
実務上のポイントは3つです。
- 最初のレスポンスのメッセージを、最終回答としてユーザーに見せない。 表示するなら「確認中」の途中経過として扱う
instructionsで「結果が届くまで結論を書かない」と指示する。 今回の条件では、誤った「取得できませんでした」が出なくなった- 同じ引数の呼び出しは、アプリ側でまとめて1回だけ実行する。 外部 API の課金や、書き込み系のツールでは特に重要
- 非同期ツールを使う場合、最初のレスポンスのメッセージを最終回答として扱っていない
- 「結果が届くまで結論を書かない」を
instructionsに入れた - 同じツール・同じ引数の重複呼び出しをまとめる処理を入れた
- 書き込み系・課金系のツールには
asyncを付けていない(または重複に耐えられる設計にした)
なお、会話の途中で effort を変えてもプロンプトキャッシュを壊さない configuration_update(会話の途中に入れる設定変更の項目)も GPT-6 系の新機能として案内されています。実測では、GPT-5.6 Sol・GPT-6 Sol ともに200で返りました。効果(キャッシュが保たれるか)までは今回は検証していません。
7. 測り直す:キャッシュと自社タスクの評価
プロンプトキャッシュは、単価だけが半分になった
約9,800トークンの規則集を instructions に入れ、質問だけを変えて4回続けて送りました。
GPT-5.6 Sol | GPT-6 Sol | |
|---|---|---|
1回目:キャッシュ書き込み | 9,774トークン | 9,774トークン |
2〜4回目:キャッシュ読み込み | 9,762トークン(毎回) | 9,762トークン(毎回) |
1回目の費用 | $0.0494 | $0.0247 |
2〜4回目の費用(1回あたり) | $0.0045 | $0.0022 |
回答の正確さ(4問) | 4/4 | 4/4 |
キャッシュの効き方は両モデルでまったく同じで、費用だけがきれいに半分になりました。GPT-5.6 以降のモデルでは、キャッシュの書き込みに入力単価の1.25倍、読み込みに0.1倍がかかります。長い前提を毎回読ませる RAG やエージェントでは、2回目以降の読み込みが費用の大半を占めるので、ここが半額になる効果は大きいです。
自社のタスクで測る
この記事の第2章・第5章③は、次の手順を小さく回したものです。
- 本番で実際に処理しているタスクから 20〜50件を抜き出す
- 自動で採点できる形にしておく(コードならテスト、抽出なら正解JSON、文章なら文字数などの条件)
- GPT-5.6 Sol(従来の設定)と GPT-6 Sol の
none/low/medium/highに、同じタスクを通す - 正解率・出力トークン・費用・所要時間を並べる
- 品質が保てる一番低い effort を処理ごとに採用する
GPT-6 Sol では回答の書き方が変わるので、文章の出力は正解率だけでなく「形式」も採点項目に入れてください(見出しの有無、文字数、必要な項目がそろっているか)。採点を自動化できないタスクは、判定基準を決めたうえで LLM as a Judge で一次判定し、人は判定が分かれたものだけを見る方法があります。評価の設計については AIの評価 で詳しく扱っています。
- 実タスクの評価セットを作った(自動採点つき、文章は形式も採点)
- effort ごとの品質・時間・トークン・費用を記録した
- 請求内訳の「入力・キャッシュ・出力」の比率を移行前に記録した
8. 移行の進め方:4ステップ
ステップ1:棚卸し(半日)
次のキーワードでコードを検索すると、影響を受けそうな箇所がおおよそ分かります。
検索するもの | 見る理由 |
|---|---|
| モデルIDの置き換え箇所 |
| effort を明示しているか。していない呼び出しを洗い出す |
| Chat Completions でツールを使っている箇所(第4章) |
| 推論の増加分に余裕があるか(第5章②) |
| レスポンスを位置で読んでいる箇所(第5章②) |
Markdown の見出し・箇条書きを解析している処理 | 回答の形式変化の影響(第5章①) |
| GPT-5.5 以前の書き方が残っていないか(第4章) |
移行作業をAIに任せる場合は、書いたAIとは別のAI(または人)にレビューさせると見落としが減ります。進め方は Claude CodeとCodexの交代勤務 で紹介しています。
ステップ2:開発環境で動かす(半日〜1日)
GPT-5.6 Sol で動いているコードなら、モデルIDを変えるだけでエラーは出ないはずです。ここで見るのはエラーではなく出力です。主要な処理を一通り動かし、回答の長さと形式、ツールの呼ばれ方を目で確認してください。
ステップ3:シャドー実行で比べる(数日〜1週間)
本番のリクエストを GPT-5.6 Sol で処理しつつ、同じ入力を GPT-6 Sol にも流して結果を比べます(ユーザーには GPT-5.6 Sol の結果だけを返す)。見るのは次の4つです。
- 品質の差(第7章の評価セット+本番サンプル)
- 回答の長さと形式
incomplete(打ち切り)の発生率- 1リクエストあたりの費用とレイテンシ
ステップ4:段階的に切り替える(1〜2週間)
5% → 25% → 100% のように、トラフィックの一部から切り替えます。各段階で上の4指標を見て、悪化があれば戻します。モデルIDと effort は設定ファイル1か所で切り替えられる形にしておいてください。
急ぐ必要はありません。2026年9月24日時点で、GPT-5.6 Sol の提供終了日は発表されていません。ただし、GPT-5.6 Sol の現在の価格は11月21日までのキャンペーン価格です。
9. 【コピー用】チェックリスト全項目
切り替え
- モデルIDを
gpt-6-solに変更 - 全呼び出しで
reasoning.effort(Chat Completions はreasoning_effort)を明示 - Chat Completions でツールを使う箇所は、
reasoning_effort: "none"にするか Responses API に移行 - (GPT-5.5 以前から)
prompt_cache_retentionをprompt_cache_options.ttl: "30m"に、minimalをlowに変更
エラーにならない変化
- 回答を表示する画面で、短くなった回答を確認した
- 回答の形式に依存した後段処理を確認し、必要な形式はプロンプトで明示した(
verbosityでは戻らない) max_output_tokensに推論増加分の余裕を持たせたoutputをtypeで読む(output[0]決め打ちをやめる)- 定型処理は
none/lowで品質が保てるか測った - ツール前の一言が必要なら
instructionsで指示し、phaseで表示を分けた
非同期ツールを使う場合
- 最初のレスポンスのメッセージを最終回答として扱わない
- 「結果が届くまで結論を書かない」を
instructionsに入れた - 同じ引数の重複呼び出しをまとめる
- 書き込み系・課金系のツールには付けない
測り直し
- 実タスク20〜50件の評価セットで effort ごとに比較(文章は形式も採点)
- 移行前の請求内訳(入力・キャッシュ・出力の比率)を記録
- シャドー実行で品質・形式・打ち切り率・費用を比較
- 段階的に切り替え、設定1か所で戻せるようにしておく
10. よくある質問
Q. モデルIDを変えるだけで動きますか? GPT-5.6 Sol で動いているコードなら、エラーにはならない可能性が高いです。私たちが試した25パターンでは、GPT-5.6 Sol で通るリクエストはすべて GPT-6 Sol でも通りました。ただし「エラーにならない」と「同じ見え方で動く」は別です。少なくとも回答の長さと形式は、実際の画面で確認してください。
Q. GPT-6 Sol は本当に安くなりますか? 表示価格は半額です。実測では、推論トークンが増えるぶんを差し引いても、既定設定で費用は約4〜5割減りました。回答が短くなったぶん、一般的な質問応答では約8割減った例もあります。ただし、プロンプトで長い回答を求めると、そのぶん費用は増えます。
Q. GPT-6 Sol にすると、出力の質は上がりますか? 易しいコード・抽出・文章タスクでは差が出ませんでした(どちらも全問正解)。3Dシーンの生成では、3お題とも GPT-6 Sol のほうが作り込みが上でした。「同等以上の質を、半分の費用で出す」モデルと考えるのが実態に近いでしょう。
Q. 回答が短くなったのを元に戻せますか? text.verbosity を high にしても、今回の検証では1割ほどしか戻りませんでした。「見出しと箇条書きを使って詳しく」のようにプロンプトで形式を指示すると、GPT-5.6 Sol と同じくらいか、それ以上の長さに戻りました。
Q. effort はどれにすればいいですか? 既定は medium です。今回の実測では、易しいタスクなら none でも全問正解でした。GPT-6 Sol では max にしても費用は medium の約2倍にとどまったので、品質が必要な処理は上げる余地があります。いずれも、自社のタスクで測ってから決めてください。
Q. GPT-5.6 Sol はいつまで使えますか? 2026年9月24日時点で、提供終了日は発表されていません。ただし、現在の GPT-5.6 Sol の価格は11月21日までのキャンペーン価格です。
Q. 非同期ツールは使ったほうがいいですか? 待ち時間の長いツールを複数使うエージェントでは効果が期待できます。ただし実測では、結果を待たずに「取得できませんでした」と答えたり、同じツールを何度も呼び直したりする挙動が出ました。使う場合は第6章の対策を入れてから試してください。
11. まとめ:エラーが出ないからこそ、画面で確かめる
GPT-6 Sol は、GPT-5.6 Sol の半額のモデルです。易しいタスクの正解率は変わらず、3Dシーンのような大きな生成では作り込みが上がり、費用は約4〜5割下がりました。GPT-5.6 Sol で通るリクエストはすべてそのまま通り、移行の手間は小さいモデルです。
ただし、エラーが出ないぶん、変化に気づきにくいモデルでもあります。回答は約6割短くなり、見出しと箇条書きがほぼ消えました。 verbosity では戻らず、戻したければプロンプトで形式を指示する必要があります。新機能の非同期ツールも、そのまま使うと結果を待たずに誤った回答を返すことがありました。
移行の成否は、コードの書き換えではなく、移行前後で何を測って比べたかで決まります。
GPT-6 Sol への移行、まずは事前診断から
「うちのアプリで回答の見え方がどう変わるか確かめたい」「品質が落ちないか確かめてから切り替えたい」「移行ついでに、effort とコスト構造も見直したい」。Mojiでは、既存AI機能のコードと利用状況を確認し、影響箇所の洗い出し、実タスクでの移行前後比較、段階的な切り替えの設計までお手伝いしています。この記事の検証と同じ方法で、御社のワークロードを測ります。
付録:検証方法の詳細
effort 別の比較(第2章・第5章③)で使った6タスク(すべて自動採点。文字数は全角=1、半角=0.5で数えた)
タスク | 採点方法 |
|---|---|
区間をマージする Python 関数 | テストコード |
「1h30m」などを秒数に変換する Python 関数(不正入力は例外) | テストコード(不正入力9種を含む) |
O(1) の LRU キャッシュ(OrderedDict 禁止) | テストコード |
各桁の和が20になる1〜10000の整数の個数 | 正解(633)との一致 |
請求書メールから7項目を JSON で抽出 | 全項目の一致 |
条件つきのビジネスメール作成(250字以内、日付2つ、箇条書き3つ、特定表現の禁止) | 条件の機械チェック |
- 各条件1回ずつ、実行順をランダムに入れ替え、4並列で実行(時間は各リクエストの所要時間の合計)
max_output_tokensはxhigh/maxで128,000、それ以外は64,000- 費用は公式の表示価格(入力・キャッシュ・出力)で計算。GPT-5.6 Sol はキャンペーン価格($4/$20)
パラメータの互換性(第4章):Responses API と Chat Completions に、effort・サンプリング・logprobs・キャッシュ設定・ツール関連の25パターンを、両モデルに1回ずつ送った。
回答の長さ(第5章①):一般的な質問5問を、両モデルに既定設定で2回ずつ。見出しは「#」で始まる行、箇条書きは「- 」「* 」「・」や番号で始まる行を数えた。verbosity の比較は、そのうち3問を各条件1回ずつ(この比較では「・」と番号を数えていない)。
ツール呼び出し前の表示(第5章④):社内FAQエージェント(ツール2種、回答までにツール呼び出し2回)。各条件で medium と high を2回ずつ。
非同期ツール(第6章):天気を返すツール1種。質問3つ×3条件×2回。effort は既定(medium)。1回目のレスポンスのあと、すべての呼び出しに同じ結果(雨・14℃)を返した。札幌の質問(明日の服装)は、ツールが現在の天気しか返さないため、どの条件でも「明日の予報は確認できない」と答えており、「取得できませんでした」の集計からは除いた。
プロンプトキャッシュ(第7章):約9,800トークンの規則集(検証用のダミー)を instructions に入れ、質問だけを変えて4回連続で送信。effort は low。
3Dシーン(第1章):お題ごとに同じプロンプト(お題の説明+技術条件:1ファイルのHTML、外部素材なし、Three.js r160 を importmap で読み込む、開いたらすぐアニメーション)。effort は指定なし(既定値)、max_output_tokens は64,000。ヘッドレスの Chromium(ソフトウェア描画)で開き、6秒後に1280×720で撮影。
出典(2026年9月24日時点)
- OpenAI「Introducing GPT-6 Sol and Luna」 https://openai.com/index/introducing-gpt-6-sol-and-luna/
- OpenAI「GPT-6 Sol」 https://developers.openai.com/api/docs/models/gpt-6-sol
- OpenAI「GPT-5.6 Sol」 https://developers.openai.com/api/docs/models/gpt-5.6-sol
- OpenAI「Model guidance(Using GPT-6)」 https://developers.openai.com/api/docs/guides/latest-model
- OpenAI「Changelog」 https://developers.openai.com/api/docs/changelog
- OpenAI「Prompt caching」 https://developers.openai.com/api/docs/guides/prompt-caching
- OpenAI「Async tool calling」 https://developers.openai.com/api/docs/guides/async-tool-calling
- OpenRouter「GPT-6 Migration Guide」 https://openrouter.ai/docs/cookbook/evaluate-and-optimize/model-migrations/gpt-6
Contact
AI活用の相談、まずは無料で
コラムで取り上げたテーマについて、貴社への適用可能性をお気軽にご相談ください。