Jev(TypeSafe AI)とは?文章を書かない「判断専用AI」の仕組み・料金・LLMとの違い【日本語評価データ150件を無料公開】
AI評価クラウド
そのAI、精度やリスクを正しく計測できていますか?
ハルシネーション検知や満足度計測など、AI品質の可視化をご支援します。

Kohei Uesugi
株式会社Moji ビジネス開発・コンテンツマーケティング担当 鹿児島県出身。大学2年次から複数のスタートアップで長期インターンを経験し、営業・事業開発と0→1の立ち上げに携わる。2026年9月より、生成AI特化の開発会社・株式会社Mojiに参画。AI開発プロジェクトの事業開発と運営体制づくりを担当しながら、自社メディアのコンテンツ運用をリードしている。
一言でいうと:Jevは「文章を書かないAI」。状況を渡すと「緊急か/どの部署か/人が見るべきか」を確率つきで即答する、生成AIの前後に置く判断レイヤーです。
この記事の結論
- Jevは「文章を生成しないAI」。入力した状況に対して、真偽・選択肢・スコアを確率つきで返す判断専用モデル。用途は分類・振り分け・ガードレールなど「次に何をするか」を決める処理。
- 速さと安さの理由は、LLMのようにトークンを1つずつ生成しないこと。公式値は70〜500ms、入力100万トークン0.042ドル・出力無料。
- 「193.6倍高速・444.6倍安い」はベンダー公表値。第三者の実測では5〜25倍程度の高速化が中心で、小規模テストでは見逃しも報告されている。
- 生成AIの代替ではなく、生成AIの前後に置く判断レイヤー。候補が有限な判定なら今すぐPoCする価値があり、説明責任が必要な判断や日本語特有の表現が多い業務は、自社データで測ってから。
1. Jevとは:入れるのは「状況」、返るのは「判断と確率」
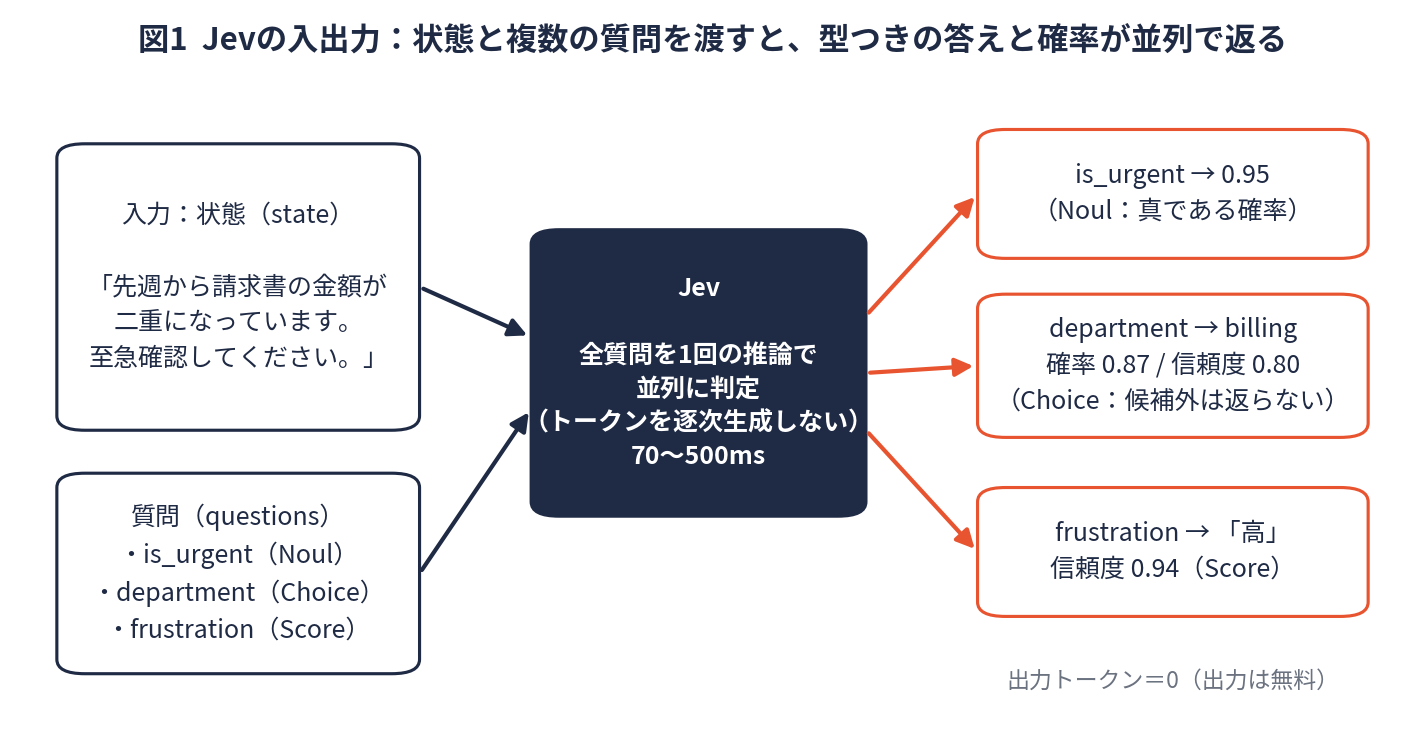
Jev(ジェヴ)は、米TypeSafe AIが2026年9月15日に公開した「System One Model」と呼ばれる新しいクラスのAIモデルです。ChatGPTやClaudeのような大規模言語モデル(LLM)が文章・コード・要約を「生成」するのに対し、Jevは文章を一切書きません。入力された状態(テキスト、JSON、ログなど)に対して、あらかじめ開発者が定義した型の答えを、確率と信頼度つきで返します。
質問の型は3種類だけです。
型 | 問い方 | 返るもの | 例 |
|---|---|---|---|
Noul | この命題は真か? | 0〜1の確率 | 「この問い合わせは緊急か」→ 0.95 |
Choice | 候補のどれか? | 選ばれた候補・各候補の確率・信頼度 | 「担当部署は」→ billing 0.80 / technical 0.12 / sales 0.08 |
Score | 段階のどこか? | スコア・信頼度 | 「顧客の不満度」→ 低・中・高の「高」、信頼度0.94 |
複数の質問を1リクエストにまとめて送れ、すべて並列に評価されます。質問を増やしても応答時間はほとんど変わりません(公式Docs)。
実際のレスポンスはこのような形です(Cloudflare Workers AIの掲載例をもとに簡略化)。
json
{
  "model": "jev-1.13.0",
  "answers": {
    "is_urgent":  { "type": "noul",   "noul": 0.95 },
    "department": { "type": "choice", "choice": "billing",
                    "probabilities": { "billing": 0.80, "technical": 0.12, "sales": 0.08 },
                    "confidence": 0.80 },
    "frustration": { "type": "score", "score": "high", "confidence": 0.94 }
  },
  "usage": { "input_tokens": 412, "output_tokens": 0 }
}ここで押さえておきたいのは、「型安全(TypeSafe)」は判断の正しさを保証する言葉ではないということです。Choiceで定義していない部署名を返さない、という出力形式の保証と、問い合わせを正しい部署に分類できるという業務精度は別物です。前者はJevが数学的に保証し(公式は型エラー率0%と説明)、後者は自社データで測る必要があります。
2. なぜ速くて安いのか:トークンを1つずつ生成しない
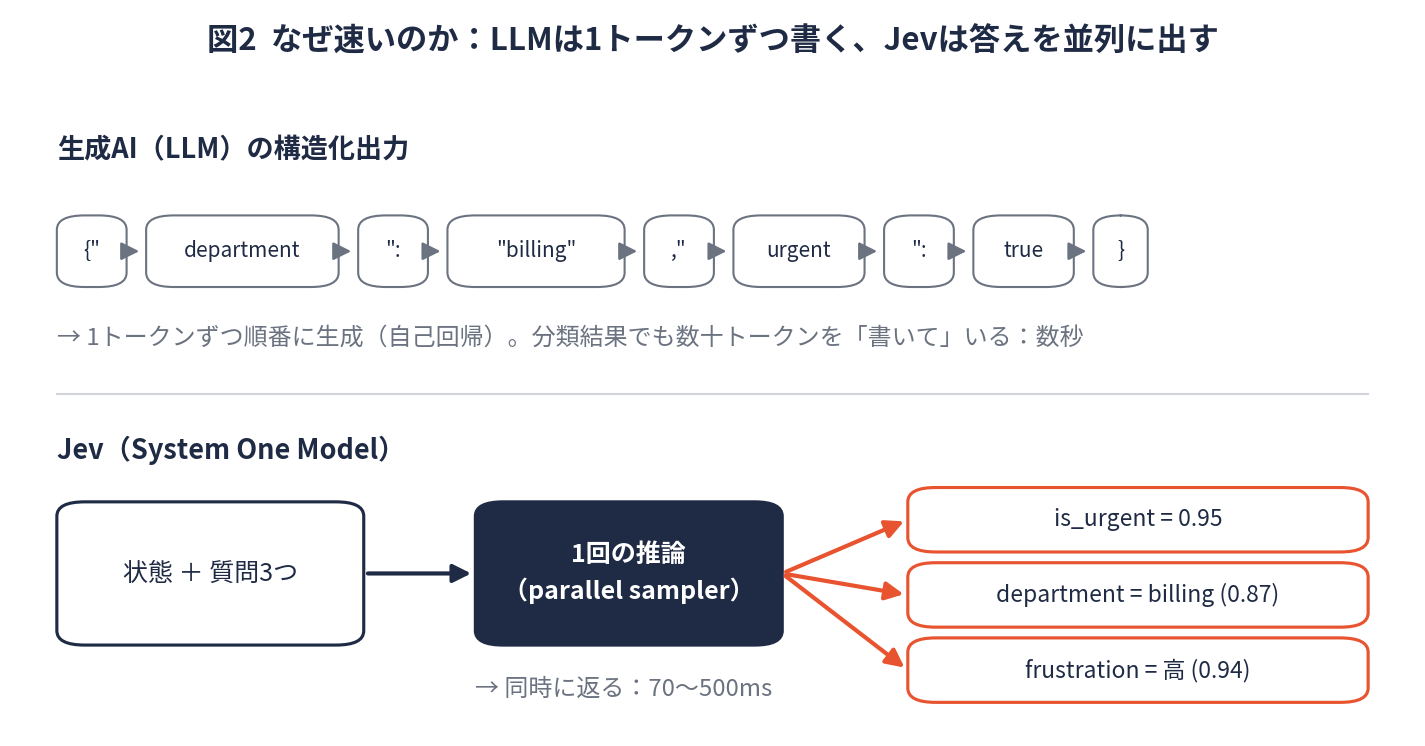
Jevの速さは「小さいモデルだから」ではなく「出力の作り方が違う」からです。「SLMのように小さいモデルだから」ではないことが、この記事でいちばん伝えたい点です。
LLMは文章を1トークンずつ順番に生成します(自己回帰)。JSONで分類結果を返す場合でも、{"department": "billing", ...} という文字列を数十トークンかけて書いています。Jevは答えの候補が事前に決まっているので、全質問の答えを1回の推論で並列に出します。TypeSafeはこれを「parallel sampler」と呼び、公式ブログでは70〜500msのレイテンシ、比較対象LLMに対して40〜200倍の高速化を説明しています。
もうひとつの柱が学習方法です。TypeSafeは RLCD(Reinforcement Learning for Calibrated Decisions) という手法を開発したと説明しています。ChatGPTを生んだRLHF(人間のフィードバックによる強化学習)が「人に好まれる文章」を最適化するのに対し、RLCDは「構造化された判断における、正直な確率」を最適化する、というのが公式の説明です。
この「正直な確率」=キャリブレーションが実務では重要です。信頼度0.9と返した判定の9割が実際に正しい、という性質があって初めて「信頼度0.8未満は人に回す」という閾値運用が成り立ちます。逆に言えば、この性質が自社データで確認できなければ、Jevの確率をそのまま自動処理の閾値に使うべきではありません(後述の反論も参照)。確率の当たり具合をどう測るかは、AIの評価指標と評価方法の考え方がそのまま使えます。
ポイント:速さの正体は「並列判断」、安さの正体は「出力トークンがゼロ」。ただし確率が当てになるか(キャリブレーション)は自社データで確認するまで信じない。
名前の「System One」は、ダニエル・カーネマン『ファスト&スロー』の「速く直感的なシステム1」と「遅く熟慮するシステム2」に由来します。TypeSafeの整理では、LLMはシステム2(考えて書く)、Jevはシステム1(見て決める)です。
3. TypeSafe AIとはどんな会社か
The Registerなどの報道によると、TypeSafe AIの概要は次のとおりです。
- 共同創業者兼CEOはDiogo Almeida氏。OpenAIの元研究員で、RLHFとChatGPTの共同発明者のひとりとされる。
- 約2年のステルス期間を経て2026年9月15日に公開。同時に4,000万ドルの資金調達を発表。
- 公開デモは「構造化されたゲーム状態を入力にDoomをプレイする」もので、1判断あたり0.114秒(比較対象のGPT-5.6 Terraは8.566秒)。約100msのループで秒間10回判断させ、運用コストは1時間あたり約7ドルと説明されている。
「ChatGPTを作った人が、文章を書かないAIを作った」という構図が、発表直後から話題になった理由のひとつです。
4. 生成AIとの違い:答えを「書く」のではなく、次の処理を「選ぶ」
観点 | Jev | 生成AI(GPT / Claude / Gemini) |
|---|---|---|
出力 | 真偽・選択肢・スコア+確率・信頼度 | 文章・コード・要約・ツール呼び出し |
得意な仕事 | 分類、優先順位づけ、ルーティング、ガードレール、エージェントの監視 | 返信文作成、調査、設計、コード生成、対話 |
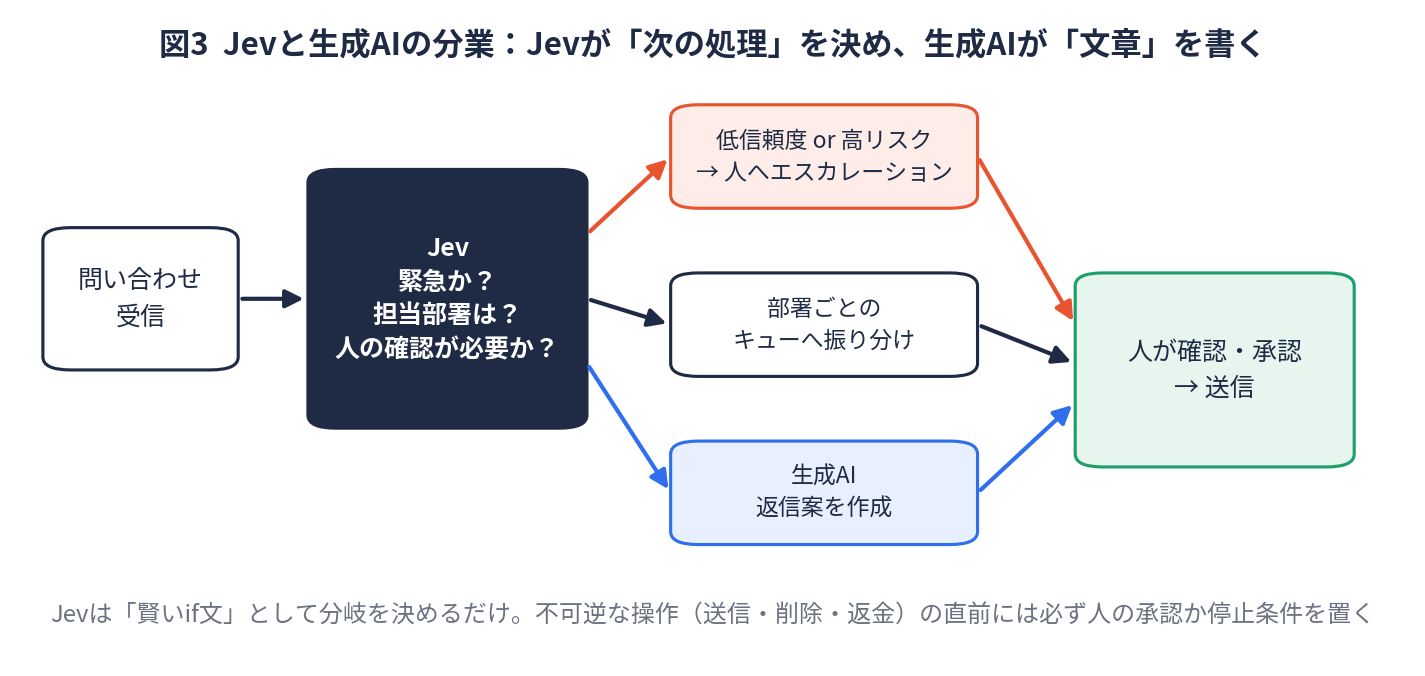
システム内の役割 | 「賢いif文」。分岐を決める | 人や次工程に渡す成果物を作る |
理由の説明 | できない(型つきの答えのみ) | できる |
失敗時 | 低信頼度なら人・上位モデル・既定ルールへ退避しやすい | 生成結果の事実確認・形式検証・承認フローが必要 |
出力の形式保証 | 定義外の値は返らない | Structured Outputsで近いことは可能だが、生成過程は残る |
優劣ではなく役割の違いです。サポート業務なら、Jevが「緊急か」「担当部署は」「人の確認が必要か」を判定し、生成AIが「顧客への返信案」を書く、という分業になります。
5. 料金と使い方
料金(TypeSafe公式)
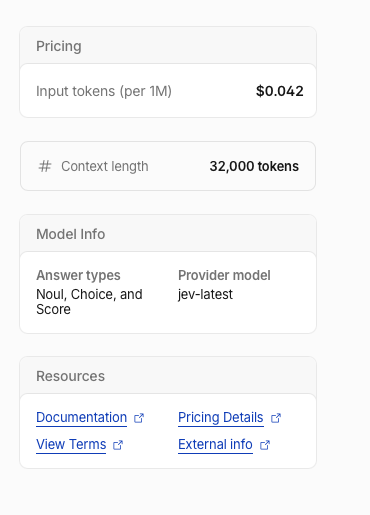
項目 | 公式値 |
|---|---|
入力 | 100万トークンあたり 0.042ドル |
出力 | 無料(出力は文字列を生成しないため) |
レイテンシ | 70〜500ms(公式ブログ) |
コンテキスト上限 | 32,000トークン(Cloudflare Workers AI掲載値。API直結・将来のモデル更新では異なる可能性あり) |
出力無料はJevの構造上の帰結です。ただし入力単価が安いことと、業務1件あたりの総費用が安いことは別です。生成AI本体の呼び出し、リトライ、誤判定の再処理、人の確認、入力データの長さまで含めて比較する必要があります(第7章のYTALの検証がまさにこの点で引っかかっています)。
提供経路
経路 | 状況 |
|---|---|
TypeSafe API直結 |
|
Cloudflare Workers AI |
|
LangChain |
|
最小のコード例
bash
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "先週から請求書の金額が二重になっています。至急確認してください。",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "この問い合わせは当日中の対応が必要か",
        "criteria": { "true": "当日中に対応しないと顧客に実害が出る", "false": "通常の対応期限で問題ない" }
      },
      "department": {
        "type": "choice",
        "instructions": "担当すべき部署",
        "criteria": {
          "billing": "請求・支払い・返金に関する内容",
          "technical": "製品の不具合・使い方",
          "sales": "契約・プラン変更・見積もり"
        }
      }
    }
  }'
LangChain経由なら次のようになります。
python
from langchain_typesafe import Noul, TypeSafeClassifier

classifier = TypeSafeClassifier()
result = classifier.invoke(
    state="デプロイが2回連続で失敗し、本番環境が5分間ダウンしました。",
    questions={"urgent": Noul(instructions="今すぐ人の対応が必要か?")},
)
6. 「193.6倍高速・444.6倍安い」の読み方
TypeSafeのトップページには「193.6倍高速」「444.6倍低コスト」と掲げられています。この数字の出どころは公式の Workflow evals です。読む前に、評価の条件を押さえてください。
- セキュリティインシデント対応、エージェント実行ログの監視、請求書処理、カスタマーサポートの4ワークフローを等しい重みで平均。
- 「正解」は人間が確定したラベルではなく、GPT-6 AstraとClaude Fable 5.1を高推論設定で実行した回答の平均。つまり測っているのは正確性ではなく「2つの上位モデルとの一致度」で、構造としてはLLM as a Judge(LLMによる自動評価)と同じ性質と限界を持ちます。
- 比較対象のLLMは推論モードを使わない標準設定。
- ワークフローはTypeSafe社内の能力チームが設計しており、公式自身がバイアスの可能性を注記。米国西海岸のノートPCからの計測で、実運用より改善幅が高めに出る可能性も注記。
この条件で、4ワークフローの平均精度は Jev 67.8%、GPT-5.6 Terra 67.9%、1件あたりコストは Jev 0.0004ドル、Terra 0.0304ドルと報告されています(DataCampの整理による)。つまり公式の主張を正確に言い直すと、「上位モデルとの一致度がほぼ同じで、コストが約75分の1」です。193.6倍・444.6倍は「4ワークフローの中で最も差が出た条件を含む平均」であり、公式ブログも「現実の上限」と表現しています。
ポイント:193.6倍は「正確性」ではなく「上位2モデルとの一致度」で測った、社内設計ワークフローの平均値。数字より評価条件を読む。
7. 第三者の実測:速いのは本当、倍率は5〜25倍、見逃しもある
発表から数日で、複数の第三者が独自に計測しています。件数・タスク・比較対象が全部違うので、1つの表に並べて読むのが一番早いです。
公開元 | 何を測ったか | 結果 | 読むときの注意 |
|---|---|---|---|
Every(米) | 合成文章12本×4項目の文章チェック。Claude Fable 5.1(高effort)と比較 | Jev中央値0.35秒、Fable 8.83秒(約25倍)。推定コスト約580分の1。意図的に埋めた欠陥7件のうちJevは6件、Fableは7件検出 | 小規模テストで見逃し1件。精度要求が高い工程の単独自動化は不可 |
Every(米) | 37文書×21問=777判定 | 0.7秒未満、推定0.25セント | 「AIっぽい文章か」の検出。業務分類の精度を示すものではない |
Near Here(英) | 実データ50件の分類 | 精度96%、平均0.59秒。Mistral Small 4比で約5倍高速・8.6倍安い | 公表倍率よりずっと小さい |
Good Start Labs(米) | ルーブリック判定6,003件 | Fable 5.1との一致率91.5%。DeepSeek V4.1 Flash比で1.6倍のコスト優位 | 最大規模の第三者評価。コスト差は「桁違い」ではない |
クラスメソッド(日) | 会話要約を4ティアに分類、4パターン×10回 | 中央値0.643〜0.674秒、1コール0.000025〜0.000027ドル。40/40が期待どおり | API単体の直接測定。境界事例なし。「medium」判定の信頼度は0.57〜0.67と低め |
Qiita @skrtk98(日) | 日本語問い合わせ16件+事実確認5件、1件に5問(感情・部署・緊急度・皮肉・攻撃性) | 期待値つき42項目すべて一致、応答201〜289ms。関西弁・タイポ・絵文字・仏語・中国語でも部署判定は概ね正しい | 弱点:計算・件数・日付比較、情報不足の入力(「?」だけ)は確信度で判別できない |
YTAL(日) | 本番ログ525ノードの名寄せ(重複統合)判定を再生 | 本番で統合された44件のうちJevが同じ判定をしたのは20件。別クラスタ同士を統合19件。8通りの設計を試しても改善せず | 単価は96%安いが、「保留」を既存処理に戻すと総費用は約4%増。現設計では採用見送り |
まとめると、実測から言えるのは次の3点です。
- 速いのは事実。 ほぼすべての計測で1秒未満、上位LLMとの比較で5〜25倍。
- 倍率は公表値より小さい。 193.6倍・444.6倍を再現した第三者はいない。
- 精度は「上位モデルとほぼ同等〜やや下」。 6,003件で91.5%一致、小規模テストで7件中1件見逃し。重大判断の単独自動化には足りず、一次チェック+低信頼度は人・上位モデルへが現実的な線。
そしてYTALの検証が示すように、判断できなかったものをどの単位で・どこに戻すかの設計次第で、単価が96%安くても総費用は増えます。これはJevに限らず「安いモデルを前段に置く」設計すべてに共通する落とし穴です。
【中間CTA】 自社の判定処理で「Jev・LLM・ルール」のどれが合うか、同じ指標で測ってみませんか? → [無料で相談する]
8. 反論と論点:Jevは本当に新しいのか
有名になった分、批判もはっきり出ています。導入を検討するなら、賛否両方を知っておくべきです。
論点1:「それ、LLMでもできませんか?」
Zennの記事(nwn氏)は、答えの候補が事前に決まっているなら、LLMにJSONを全部生成させる必要はなく、候補を短いIDに割り当てて最初の1トークンのlogit(確率)を比べるだけで済む、と指摘しています。この方法でJev同等の処理を77倍高速化したと報告しています。同様の発想のオープン実装「OpenJev」も複数登場しており(クラスメソッドが整理)、既存モデルの内部スコアを読み取る流派と、判断用に再学習する流派があります。
ただし、いずれの実装も確率のキャリブレーションは保証していません。Jevの差別化は「速い」ことより「返ってくる確率を閾値運用に使える(とされる)」ことにあり、ここは第三者の大規模検証を待つ必要があります。また、最上位モデルの多くはAPIからlogitを取得できないため、この代替策は使えるモデルが限られます。
論点2:価格は持続するのか
TypeSafe自身が「価格が補助金(赤字覚悟の値付け)でないことを証明はできない」と認めていると報じられています(DataCamp)。早期アクセス段階の価格をそのまま3年のTCOに入れるのは危険です。
論点3:理由が説明できない
Jevは判断と確率だけを返し、根拠を書きません。金融・医療・人事など監査で「なぜその判断か」を求められる領域では、Jev単独では要件を満たせません。LLMに理由を書かせるか、人の承認を挟む設計が必要です(AIのリスク管理、AIのセキュリティ対策も参照)。
論点4:日本語
公式例・第三者評価のほとんどは英語です。Qiitaの検証では関西弁や絵文字混じりでも部署分類は概ね正しく動きましたが、21件です。敬語・省略・固有の部署名・社内用語が多い日本語業務では、英語評価の結果を転用せず、自社の日本語データで誤分類・低信頼度・重大な見逃しを測る必要があります。
論点5:早期アクセス
2026年9月時点でAPI直結はwaitlist制です。本番採用の前提となるSLA、レート制限、データの取り扱い(保存・学習利用)、リージョンは、契約時に確認が必要です。
ポイント:反論は4つ。「LLM+logprobsで代替可能」「価格は持続するか」「理由を説明できない」「日本語は未検証」。導入判断はこの4つに自社の答えを出してから。
9. どちらを使うか:判断基準
業務条件 | 第一候補 | 設計のポイント |
|---|---|---|
候補が有限で、処理先を選べばよい(部署分類、優先度、タグ付け) | Jev | Choiceの候補定義を業務ルールに一致させ、低信頼度時の退避先を決める |
ルール適合・危険性・完了可否を高頻度で確認したい(エージェントのツール実行前チェック、ログ監視) | Jev+人 or 生成AI | Jevを監視・ゲートにし、失敗時は止めるか再レビューへ |
顧客向けの説明・提案文を作りたい | 生成AI | Jevは文章を書けない |
曖昧な依頼を調べて成果物にまとめたい | 生成AI+検索・ツール | Jevは途中の優先順位づけに限定 |
判断理由の説明が監査上必要 | 生成AI or 人 | Jevは根拠を返せない |
誤りが金銭・法務・セキュリティ事故に直結 | 人の承認を必須に | モデルの信頼度を承認の代替にしない。権限・監査ログ・停止条件を設計(AIエージェントはどこまで任せるべきかで詳述) |
10. 導入前の検証手順(Mojiの提案)
- 判定を1つに絞る。 「問い合わせ部署」「人手レビュー要否」「危険操作の停止要否」など、候補が明確な1判定から。
- 候補と既定処理を先に固定する。 各候補の定義、選べないケース、低信頼度時の処理を文書化。
- 実データから評価セットを作る。 通常例だけでなく、境界例・例外・「急ぎではありません」のような否定表現・情報不足を含める。正解ラベルは業務責任者が確認(作り方はRAG評価データセットの作り方の手順が流用できます)。
- Jev・既存ルール・生成AI分類を同じ入力で比べる。 正答率、重大誤り率、低信頼度での検知率、P50/P95レイテンシ、業務1件あたりの総費用(保留分の戻し先込み)。
- 信頼度閾値を決め、退避をテストする。 「閾値未満は人へ」「高リスク候補は信頼度にかかわらず承認必須」。
- 限定公開で監視し、再評価する。 モデルバージョン・提供経路・候補定義を記録し、誤分類を評価セットに追加し続ける。
PoC前のチェックリスト:判定結果を有限の候補か数値で表せるか/候補の定義を担当者間で同じ意味に読めるか/低信頼度・候補外・入力不足の退避先があるか/絶対に見逃せない誤判定を定義したか/API単体でなく前後の処理込みのP95を測るか/入力単価でなく1業務完了あたりの費用を測るか/モデル名・バージョン・経路をログに残すか/個人情報を入れる場合の契約・保存・権限を確認したか/不可逆操作の直前に人の承認か停止条件を置いたか。
11. Mojiの見解:今すぐ試す価値がある業務、待つべき業務
MojiはAI受託開発の現場で、「LLMに判断させているが、遅い・高い・たまに形式が崩れる」という相談を日常的に受けています。その経験から言うと、Jevが刺さるのは「AIに何かを書かせたい」案件ではなく、すでに動いているシステムの中で、LLMが"if文の代わり"として呼ばれている箇所です。そこは往々にして、1回あたり数秒・数円のLLM呼び出しが1日数千回積み上がっていて、しかも返ってくるのは「billing」の一言だけ、という構造になっています。
今すぐPoCする価値がある業務
問い合わせやチケットの一次振り分けは、最初に試す候補として最適です(対象業務の選び方は生成AI導入前の業務棚卸しの考え方と同じです)。候補が有限で、誤っても次の担当者が直せて、件数が多い。Jevの強みが全部乗る領域で、失敗のコストが小さい。すでにLLMで振り分けている会社なら、同じ入力を横に流すだけで比較できます。
AIエージェントのツール実行前ガードも有力です。「この操作は危険か」「この結果は正常か」をエージェントのループの中で毎回LLMに聞いている設計は珍しくなく、そこが全体のレイテンシとコストを支配していることがあります。この判定をJevに置き換えると、エージェント本体のモデルを変えずに応答が体感で変わります。LangChainがこの用途で統合を出したのは偶然ではありません。
ログや生成物の一次スクリーニングも向いています。人が全件を見るのは不可能で、かといって全件を上位LLMに通すのはコストが合わない。Jevで「怪しいものだけ」を拾い、後段で人か上位モデルが確認する二段構えなら、見逃しのリスクを後段で受け止められます。
自社データで測ってから判断すべき業務
名寄せや重複判定のように「どちらとも言えない」が大量に出る処理は、YTALの検証が示したとおり、保留分の戻し先の設計次第で総費用が逆転します。単価だけ見て導入を決めると、運用に入ってから帳尻が合わなくなります。
日本語の敬語・省略・社内用語が判定を左右する業務も、英語中心の公式評価をそのまま信じるべきではありません。Qiitaの21件では関西弁や絵文字でも動いていますが、「御社の部署名」「御社の製品名」で動く保証はどこにもありません。
判断理由の説明が監査上必要な領域は、Jev単独では要件を満たせません。金融・医療・人事のように「なぜその判断か」を後から説明する義務がある業務では、Jevは前段の絞り込みまでにして、最終判断は理由を書けるモデルか人に残す設計になります。
Mojiが見ている本当の論点
Jevの議論は「193.6倍は本当か」に寄りがちですが、実務で効いてくるのは倍率ではなく、低信頼度のときにどこへ戻すかを最初から設計できるかです。ここを決めずにJevを入れると、精度が上がっても運用が回らない。逆にここを決めてあれば、Jevでなくても、より安いLLMでもルールでも、同じ評価軸で比較できます。Jevの登場は、「判断をどこに持たせるか」を設計として考え直すきっかけとして価値がある、というのがMojiの見方です。
Mojiが公開する評価キット:Jevを試す前に「日本語の落とし穴」を揃えておく
ここまで読んで「自社データで測れ」と言われても、評価データを一から作るのは骨が折れます。そこでMojiは、日本語の問い合わせ分類を想定した評価データ150件とスクリプトを公開します(MITライセンス)。
GitHub: uesgugikouhei-oss/jev-ja-eval
このキットが目指しているのは「通常例の正答率」ではなく、判定が崩れやすい入力で何が起きるかを見ることです。150件の内訳は次のとおりです。
種類 | 件数 | 何を試すか | 例 |
|---|---|---|---|
通常例 | 70 | 明確な問い合わせ(緊急案件・長文・業務外を含む) | 「二重に引き落とされているようです。返金をお願いします。」 |
境界例 | 22 | 部署が曖昧(請求⇔営業、技術⇔請求) | 「有料プランに変更したのに機能が使えません。」 |
否定表現 | 12 | 緊急に見えて緊急でない、その逆 | 「急ぎではありませんが、請求書の宛名を変更したいです。」 |
情報不足 | 9 | 「わからない」と言えるか | 「?」「動きません」「先日の件、どうなりましたか。」 |
方言・口語 | 8 | 関西弁・博多弁・くだけた表現 | 「請求書の金額、なんかおかしいねんけど見てもらえへん?」 |
誤字・ひらがな | 6 | 変換されていない入力 | 「せいきゅうしょの金額がちがいます。」 |
絵文字 | 6 | 絵文字混じり | 「請求額が倍になってる😱 確認お願いします🙏」 |
皮肉・怒り | 6 | 要人対応の検出 | 「素晴らしいですね、3回目の二重請求です。」 |
複数部署 | 5 | 1通に2つの依頼 | 「解約手続きと、最終請求書の発行をお願いします。」 |
多言語混在 | 6 | 英語・中国語・仏語 | 「Invoiceの金額が間違っています。Please check.」 |
ラベルは「担当部署(billing / technical / sales / other)」「緊急か」「人が直接対応すべきか」の3つ。指標は正答率に加えて、緊急案件の見逃し数、要人対応案件の見逃し数、種類別の正答率、低信頼度に落ちた件の実際の誤り率(キャリブレーションの目安)、P50/P95レイテンシ、API単価ベースの推定コストを出します。第10章の検証手順をそのままコードにしたものです。
まず超えるべき基準値:ルールベースで73%
このキットには、キーワード一致だけの単純なルールベース分類器も入れてあります。その結果が「モデルを入れる前の基準値」です。
指標 | ルールベース |
|---|---|
部署 正答率 | 73.3% |
緊急度 正答率 | 84.7% |
要人対応 正答率 | 80.0% |
緊急案件の見逃し | 33件中19件 |
要人対応の見逃し | 42件中27件 |
部署正答率(境界例) | 59.1% |
部署正答率(複数部署) | 20.0% |
見てのとおり、通常例だけなら単純なルールでも7割は当たります。差が出るのは緊急案件の見逃し(半分以上落とす)と、境界例・複数部署の依頼です。JevでもLLMでも、導入の価値はここでどれだけ改善するかで決まります。「正答率が73%から90%になった」より「緊急の見逃しが19件から2件になった」のほうが、業務上の意味ははるかに大きい。
同じ入力・同じ指標で、Jev、LLMの構造化出力、ルールベースを横に並べられるようにしてあるので、TypeSafeのAPIキー(またはCloudflare Workers AI)とLLMのAPIキーがあれば、コマンド1行で比較表が出ます。Mojiでの実測結果も、この記事の続報として追記します。
12. よくある質問
Q. JevはChatGPTやClaudeの代わりになりますか? なりません。文章を生成しないので、返信文・要約・コードは書けません。生成AIの前後で「次に何をするか」を決める役割です。
Q. ハルシネーションはしないのですか? 定義外の値を返さない、という意味では「形式的なハルシネーション」は起きません。ただし判断そのものが間違うことはあります(Everyの検証で7件中1件見逃し)。
Q. 日本語は使えますか? 使えます。Qiitaの検証では関西弁・絵文字混じりでも部署分類は概ね正しく動いています。ただし公式評価は英語中心なので、自社の日本語データでの検証は必須です。
Q. 今すぐ使えますか? API直結はwaitlist制です。Cloudflare Workers AI経由なら typesafe/jev として試せます。
Q. 料金はいくらですか? 公式値は入力100万トークン0.042ドル、出力無料。ただし早期アクセス段階の価格です。
Q. 既存のLLMで同じことはできませんか? 候補が決まっていればlogitを比べる方法で近いことはできます(OpenJev等)。違いは速度より「確率が校正されているか」で、ここは検証待ちです。
13. まとめ
Jevは「何でも答えるAI」ではなく、「何を次に実行するかを、候補の中から確率つきで決めるAI」です。速さと安さの根拠はトークンを逐次生成しない構造にあり、これは本物です。一方で公表倍率は評価条件に依存し、第三者の実測は5〜25倍、精度は上位モデルとほぼ同等かやや下、というのが2026年9月時点の実像です。
導入判断は、入力単価や平均レイテンシではなく、対象判定・境界例での精度・低信頼度時の退避・不可逆操作の承認・業務1件あたりの総費用を同一条件で測って決めてください。その検証設計から、Mojiがお手伝いします。
AIの精度・品質評価、まずは無料相談から
「Jevを試すべきか」「LLMのままでいいのか」「ルールで十分か」は、自社データで同じ指標を測れば決まります。Mojiでは、評価データの設計からJev・LLM・ルールの比較検証、低信頼度時の退避設計、本番導入までを一貫して支援しています。まずは現在の判定処理の内容と件数をお聞かせください。
[AI新規事業デザイン開発支援の詳細を見る] / [無料相談する]
関連記事
- AIの評価とは?評価指標や評価方法、その費用について
- LLM as a judge(自動評価)とは?開発方法や費用について
- AIエージェントはどこまで任せるべきか|委任範囲・人の承認・停止条件を設計する実務ガイド
- RAG評価データセットの作り方
- GPT-6 Astraとは?GPT-5.6 Solからの進化とClaude Fable 5.1との違いを実際に検証
- SLMとは?LLMやVLMとの違いや開発方法や費用について
- AIエージェントとは?
- ハルシネーションとは?
出典
- 株式会社Moji「jev-ja-eval」(日本語評価データ150件+スクリプト) https://github.com/uesgugikouhei-oss/jev-ja-eval
- TypeSafe AI 公式ブログ「Introducing System One Models & Jev」 https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI Docs(API Reference / Primitives) https://docs.typesafe.ai/
- Cloudflare Workers AI「Jev (typesafe)」 https://developers.cloudflare.com/ai/models/typesafe/jev/
- LangChain Blog「Building a harness with Jev」 https://www.langchain.com/blog/building-a-harness-with-jev
- The Register(2026/9/16) https://www.theregister.com/ai-and-ml/2026/09/16/typesafe-ai-debuts-model-for-machines-that-plays-doom/5296711
- DataCamp「Jev: TypeSafe's System One Model」 https://www.datacamp.com/blog/system-one-models-jev
- Every「Mini-Vibe Check」 https://every.to/also-true-for-humans/mini-vibe-check-typesafe-s-jev-judged-everything-i-ve-written-in-0-7-seconds
- Cherry Creek News(Near Here / Good Start Labs の独立テストまとめ) https://thecherrycreeknews.com/typesafe-jev-system-one-model-claims-evals-independent-tests-cherry_creek/
- クラスメソッド DevelopersIO「モデルルーティングをTypeSafe(Jev)に置き換えてみた」 https://dev.classmethod.jp/articles/jev-for-llm-model-routing/
- クラスメソッド DevelopersIO「OpenJevを読んで、生成しないAIの別解を考えてみた」 https://dev.classmethod.jp/articles/openjev-non-generative-ai-alternatives/
- Qiita @skrtk98「生成しないAIモデル Jev を試した」 https://qiita.com/skrtk98/items/7c37bab5fffc7510bb2b
- YTAL「TypeSafe AIの『Jev』は本番で使えるか」 https://ytal.io/blog/typesafe-jev-entity-resolution-production-replay/
- Zenn nwn「TypeSafeのJevを正しく驚く、それってLLMでできませんか?」 https://zenn.dev/nwn/articles/824026c76116e0