Qwen4-Maxとは?1Mトークン・ネイティブビジョン・エージェント性能をQwen3.8-Maxと比較
スマートAI管理
社内の生成AI利用、把握・管理できていますか?
利用状況の可視化からリスク評価・承認管理・監査レポートまで、AIガバナンスをご支援します。
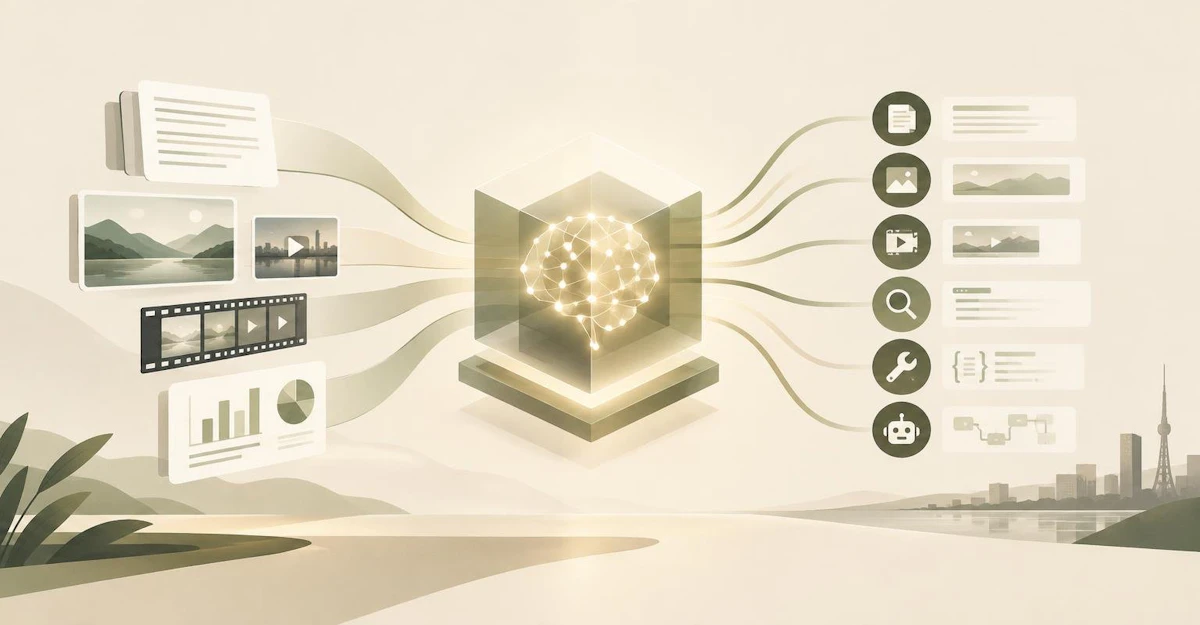
Qwen4-Max(クウェン・フォー・マックス)は、Alibaba Cloudが2026年11月16日に公開した、Qwenシリーズの次世代フラッグシップ・マルチモーダルモデルです。テキスト生成に加え、画像・動画の理解、深い推論、Function Calling、Web検索、JSON Schemaを含む構造化出力を扱えます。モデルIDはqwen4-maxで、Alibaba Cloud Model StudioからAPI利用できます。Alibaba Cloud公式ドキュメント
先に選び方をまとめると、大量の資料・画像・動画を参照しながら、複数のツールを使う難しい作業を評価したい場合はQwen4-Maxが候補です。一方、問い合わせ分類、短い要約、定型抽出など、処理件数や単価を優先する業務では、Qwen3.7-PlusやQwen3.8-Flashも同じ条件で比較してください。Alibaba Cloud自身も、品質優先ではQwen4-Max、性能・速度・コストのバランスではQwen3.7-Plus、コスト優先ではQwen3.8-Flashを案内しています。Alibaba Cloud:テキスト生成・視覚理解モデルの選び方
Qwen4-Maxの要点
- 1Mトークンのコンテキスト:入力最大991,808トークン、通常時の出力最大131,072トークン。Thinkingモードでは、推論と最終出力を合わせて最大262,144トークンです。
- ネイティブビジョン:テキスト、画像、動画を入力し、テキストで応答します。画像は最大16Mピクセル、動画は最長2時間・最大2GB、最大2,048画像・64動画という仕様です。
- エージェント向けの機能:並列ツール呼び出し、Function Calling、Web検索、組み込みツール、JSON Object/JSON Schema、明示・暗黙キャッシュに対応します。
- 既存クライアントから移行しやすいAPI:OpenAI Chat Completions、OpenAI Responses、Anthropic Messages、DashScopeの各形式をサポートします。ただしこれはAPI形式の互換性であり、OpenAIやAnthropicのモデルそのものを呼び出せるという意味ではありません。
上記の対応機能、入出力上限、対応API形式は、Qwen4-Maxの公式仕様で確認できます。
Qwen4-Maxとは:単に「長文対応」のモデルではない
1Mトークンのコンテキストだけを見ると、「大量のPDFを一度に入れられるモデル」と捉えがちです。しかしQwen4-Maxの特徴は、長い入力を保持できることだけではありません。画像・動画を含む資料を読み、必要に応じて検索・ツール利用を行い、構造化された結果を返すための機能が、同じモデルに統合されている点にあります。
たとえば、契約書・議事録・画面キャプチャを横断して確認し、社内APIで最新状態を照会し、確認事項をJSONで返す、といった設計が対象になります。AIエージェントの基本的な役割や、チャットボット・RPAとの使い分けは、AIエージェントとは?生成AI・チャットボット・RPAとの違いと導入判断・実践手順で解説しています。
ただし、長いコンテキストに資料を入れれば正確になるわけではありません。資料の正本、更新日、利用者の閲覧権限、検索・照会すべき現在値を分けて設計する必要があります。特に現在の在庫、残高、契約ステータスのような確定値は、文書に書かれた説明だけで回答せず、必要に応じて業務APIやデータベースを照会する設計が必要です。
Qwen3.8-Max・Qwen3.7-Plus・Qwen3.8-Flashとの違い
以下は、Alibaba Cloudの現行ドキュメントに基づくQwen系モデルの比較です。コンテキスト長やツール対応が同じでも、モデルの位置付け、出力上限、料金、実際の品質は異なります。モデル名だけで一律に優劣を決めず、自社入力・評価指標・許容できない失敗を固定して比較してください。
モデル | 公式上の位置付け | コンテキスト | 画像・動画理解 | 選定の目安 |
|---|---|---|---|---|
Qwen4-Max | 最高品質を優先するフラッグシップ | 1M | 対応 | 複雑な推論、コーディング、長いツール実行、視覚資料を含む高難度業務 |
Qwen3.8-Max | 旧世代のMax系。現行の推奨一覧では「旧モデル」として掲載 | 1M | 対応 | 既存実装の移行候補。Qwen4-Maxとの回帰評価をしてから切り替える |
Qwen3.7-Plus | 性能・速度・コストのバランス型 | 1M | 対応 | 幅広い業務の初期PoC、複雑性が中程度のエージェント補助 |
Qwen3.8-Flash | 速度・コスト優先 | 1M | 対応 | 大量分類、短い抽出、低単価が重要な下流処理 |
Qwen4-Max、Qwen3.7-Plus、Qwen3.8-Flashはいずれも1Mコンテキスト、Thinking、Function Calling、組み込みツール、構造化出力への対応が案内されています。一方、Qwen4-Maxは通常時131,072トークン、Thinking時は推論と最終回答を合わせて262,144トークンまで出力できます。Alibaba Cloud:現行・旧モデルの機能比較
Qwen3.8-Maxとの公式比較では、Alibaba Cloudは自社のWork360評価において、Qwen4-Maxがより高いスコアを示し、High設定で使用トークンが35%少なく、タスク当たり平均コストが約60%低かったと発表しています。ただしWork360は提供元の独自評価であり、他社モデルとの共通ベンチマークではありません。自社業務の性能差や費用削減を保証する数値としては扱わず、PoCで再現性を確認してください。Alibaba CloudのQwen4-Max発表
他社モデルとの比較は、ベンチマーク順位だけで決めない
Qwen4-MaxをOpenAI、Anthropic、Googleなどの上位モデルと比較する場合、各社が公表する評価セット、推論設定、ツール環境、価格単位、地域が異なるため、公開ベンチマークを横並びにして「総合1位」と結論づけることはできません。Qwen4-Maxについても、提供元はCode Arena、Agents’ Last Exam、Vals Index、JobBench、Chartographyなどの結果を紹介していますが、比較条件を揃えないまま業務適性へ読み替えないことが重要です。Alibaba Cloudの公式発表
比較では、モデル名ではなく次の4条件を固定します。
- 入力品質:実際の文書、画像、ツール定義、権限情報を含める。匿名化・架空化する場合も、レイアウトや欠損、例外の比率を実務に寄せる。
- 評価指標:正答率だけでなく、根拠の引用率、JSON妥当率、ツール呼び出し成功率、処理時間、1タスク当たり費用、危険な誤りの件数を測る。
- 許容誤差:たとえば「分類の誤りは人が修正できるが、顧客への送信・金額変更・権限変更は自動実行しない」のように、失敗の影響で判定を分ける。
- 実行条件:推論強度、最大出力、温度、プロンプト、ツール数、再試行回数、キャッシュ有無、リージョンを揃える。
このように比較対象と条件を固定しない限り、価格表や一般ベンチマークだけではモデル選定の結論は変わります。評価ケースの作り方は、LLM評価の進め方|モデル選定を導入判断につなげる比較基準・手順・チェックリストも参照してください。
日本で使える?提供地域・料金・API利用の確認点
2026年11月17日時点で、Qwen4-MaxはAlibaba Cloud Model Studioの東京リージョンで「Global」スコープとして案内されています。東京リージョンでは、テキスト・画像・動画入力、Thinking、Web検索、並列ツール呼び出し、Function Calling、構造化出力、OpenAI/Anthropic形式のAPIが対応機能として掲載されています。したがって、日本からQwen4-MaxをAPIで検証する選択肢はあります。Qwen4-Maxのリージョン別仕様
東京リージョンの従量課金は、入力100万トークン当たり1.413米ドル、出力100万トークン当たり4.24米ドルです。料金はThinking/Non-Thinkingの双方に示されており、1リクエストの入力上限は1Mトークンです。価格、無料枠、プロモーション、利用規約は変わり得るため、予算化・本番化の直前に管理画面と公式料金表を再確認してください。Qwen4-Maxの公式料金・レート制限
なお、Qwen4-Maxは現行仕様でファインチューニングとモデル配備をサポートしていません。独自知識を反映したい場合は、まずRAG、ツール連携、プロンプト、構造化出力、評価データセットで要件を満たせるかを確認し、それでも不足する場合に別モデル・別方式を検討する順が現実的です。Qwen4-Maxの機能対応表
Qwen4-Maxが向く業務・向かない業務
業務条件 | Qwen4-Maxを検討しやすい理由 | 先に比較したい選択肢 |
|---|---|---|
長い規程・契約・設計資料を読み、論点を整理する | 1Mコンテキストと画像・動画理解を同一モデルで扱える | 検索対象が明確ならRAG+中位モデル |
画面キャプチャ、帳票、動画を含む調査・報告 | テキストだけでなく視覚入力を受け取れる | 文字転記が中心ならOCR+抽出処理 |
調査、照会、計算、下書きを複数ツールで進める | Function Calling、並列ツール呼び出し、JSON出力を利用できる | 手順が固定ならワークフロー・RPA |
問い合わせのタグ付け・定型要約を大量処理する | 利用は可能だが能力過多になり得る | Qwen3.8-FlashやQwen3.7-Plus |
現在の残高・在庫・契約状態を確定する | 説明生成には使えるが、モデルの知識だけで確定してはいけない | 業務API・DB照会を正本にする設計 |
ツールをつなぐ際は、AIに判断させる部分と、APIが確定値を返す部分を分けます。API、MCP、A2Aは競合する選択肢ではなく、接続対象と委任範囲が異なります。詳しくはAPI・MCP・A2Aの違いとは?AIエージェントを接続する仕組みやポイントを分かりやすく解説を確認してください。
始め方:本番導入前に行う5ステップ
- 対象業務を1つに絞る
「資料100件から確認事項を抽出する」「画面キャプチャを含む障害報告を分類する」のように、入力・成果物・確認者を明確にします。最初からメール送信、更新、決済など不可逆な操作を含めません。 - Model Studioで東京リージョンと利用条件を確認する
リージョン、データ処理条件、組織の契約、APIキーの発行方法、利用上限を確認します。Qwen4-MaxはOpenAI Chat Completions、Responses、Anthropic Messages、DashScopeの各API形式に対応します。Qwen4-Max APIアクセスの公式案内 - Qwen4-Maxと比較対象を同じ条件で動かす
Qwen4-Maxだけで合否を決めず、Qwen3.7-PlusまたはQwen3.8-Flashを比較対象にします。プロンプト、ツール定義、最大出力、推論強度、再試行回数を固定します。 - モデル出力とツール実行を分けて評価する
回答が正しくても、誤ったツールを呼んだり、必要なツールを呼ばなかったりすれば業務では失敗します。回答品質、JSON妥当率、ツール選択、ツール引数、根拠、処理時間、費用を別々に記録します。 - 人の確認・停止条件を実装する
外部送信、金額、顧客情報、権限変更では人の承認を必須にします。一定回数のツール失敗、根拠不足、想定外の権限要求、予算超過で停止する条件も決めます。
MojiによるPoC評価テンプレート
以下は、Qwen4-Maxを含むモデル比較に使えるMojiによる実務上の提案です。架空の例ではなく、自社で実際に扱う入力を匿名化した評価ケースで埋めてください。
項目 | 記入内容 |
|---|---|
業務の目的 | 誰の、どの判断・作業を、何分短縮または何件処理したいか |
入力 | 文書、画像、動画、検索結果、ツール定義、権限情報の種類と件数 |
期待成果物 | 文章、JSON、比較表、下書き、ツール呼び出し計画など |
正解条件 | 必須項目、根拠の参照、JSON Schema、禁止表現、許容する誤差 |
失敗の重要度 | 軽微:人が修正可能/重大:顧客・金額・権限・法令に影響 |
測定値 | 品質、重大誤り率、ツール成功率、P95処理時間、1件当たり費用、確認時間 |
合否基準 | 例:重大誤り0件、JSON妥当率99%以上、確認時間が現行比で削減、予算内 |
結論は、モデル、入力品質、評価指標、許容誤差で変わります。公開ベンチマークの順位は候補を絞る材料にはなりますが、業務への適合を確定する材料にはなりません。Qwen4-Maxの強みである長文脈・視覚理解・ツール利用が本当に必要かを、このテンプレートで確認してから本番設計へ進めるのが安全です。
まとめ
Qwen4-Maxは、1Mトークン、画像・動画理解、推論、ツール利用、構造化出力を組み合わせ、複数ステップの業務を扱うためのQwen系フラッグシップモデルです。日本では東京リージョンでAPI提供が案内されており、OpenAI・Anthropic形式のAPI互換もあります。
ただし、「最上位モデルだから採用する」のではなく、長い入力、視覚資料、複数ツールのどれが業務要件なのかを先に定めることが重要です。Qwen4-Max、Qwen3.7-Plus、Qwen3.8-Flashを同じ評価ケースで比べ、品質だけでなく、ツール実行の安全性、確認工数、タスク当たり費用まで測定してください。