NVIDIA Vera CPUとは?特徴・用途・導入条件を公式情報で解説
AI脆弱性診断
そのAIシステム、従来の診断だけで十分ですか?
外部・内部の弱点に加え、プロンプトインジェクションや過剰な権限などAI固有の攻撃面も診断します。
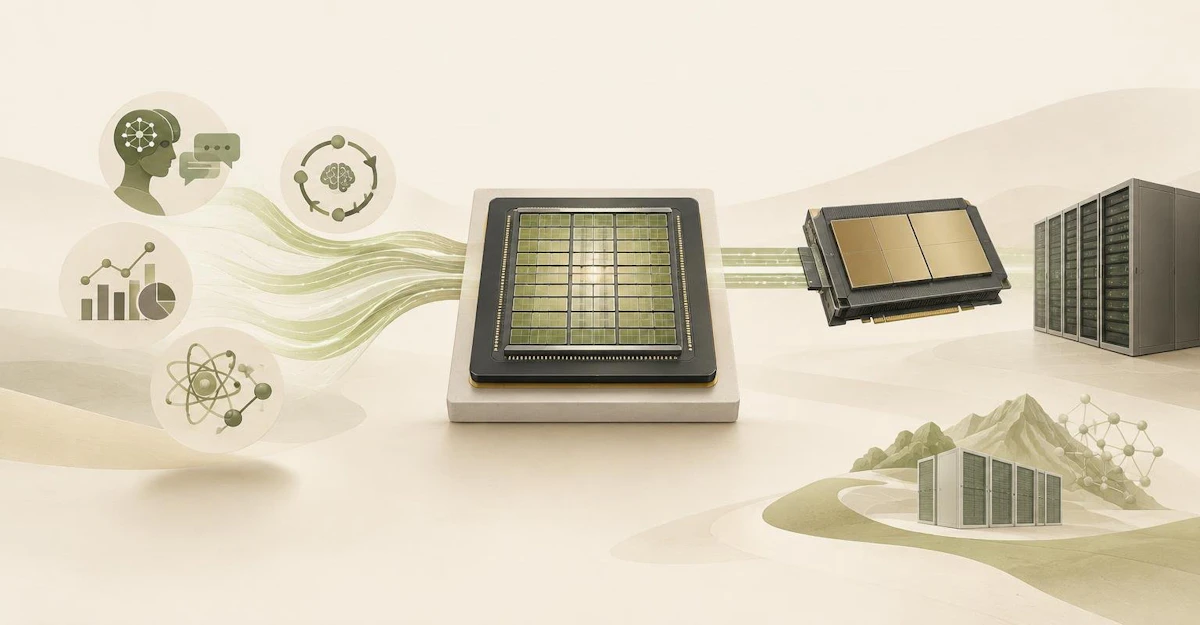
NVIDIA Vera CPUは、NVIDIAが設計したデータセンター向けCPUです。NVIDIAは、エージェント型AI、強化学習(RL)、データ分析、データパイプライン、HPC(高性能計算)を主な対象として案内しています。GPUと組み合わせるホストCPUとしての構成に加え、単体CPUを集積するラックスケール構成も示されています。NVIDIA Vera CPU製品ページ
2026年11月17日時点の導入判断として、Vera CPUは一般的な業務サーバーをCPUだけ置き換えるための製品というより、AI・科学計算基盤をCPU、GPU、ネットワーク、冷却、ソフトウェアを含めて設計する組織が評価しやすいプラットフォームです。特に、GPUへデータを供給するCPU側の処理、多数の実行環境、メモリ帯域、ノード間通信が制約になっているかを確認してから検討します。
NVIDIA Vera CPUとは
Vera CPUは、88基のNVIDIA独自設計Olympusコアを備えるArm互換CPUです。Spatial Multithreadingにより176スレッドを扱い、最大1.2TB/sのLPDDR5Xメモリ帯域幅、最大1.5TBのメモリ容量を案内しています。NVIDIAの技術資料では、OlympusをArm v9.2ベースのカスタムCPUコアとして説明しています。NVIDIA Vera Performance Tuning Guide
NVIDIAは2026年11月16日、科学計算向けのVera CPUラックスケール・プラットフォームを発表しました。この構成は、192基のVera CPUをNVIDIA Quantum-X800 InfiniBandで接続し、約300TBのメモリと1PBのストレージを液冷のNVIDIA MGX設計へ統合するものです。NVIDIAは、気候モデリング、分子動力学、その他のアクセラレータを使わない次世代の科学ワークロードを主な対象として挙げています。NVIDIAの2026年11月16日発表
Vera CPUの主な仕様
項目 | 公式資料で確認できる内容 | 導入時に見るポイント |
|---|---|---|
CPUコア | 88基のNVIDIA独自設計Olympusコア | 並列タスク、データ処理、制御処理の実行数 |
スレッド | Spatial Multithreadingによる176スレッド | 同時実行時のスループットと待ち時間 |
メモリ | LPDDR5X、最大1.2TB/s、最大1.5TB | メモリ容量・帯域が制約となる処理か |
CPU内ファブリック | 第2世代SCF、3.4TB/sのバイセクション帯域幅 | 高並列時のメモリアクセスと通信特性 |
GPUとの接続 | NVLink-C2Cで最大約1.8TB/sのコヒーレント帯域幅 | Rubin GPUを使う構成でCPU・GPU間のデータ移動が課題か |
CPU単体構成 | 1ソケット、2ソケットのVera CPU構成を案内 | GPU統合基盤ではなくCPU中心の更新が必要か |
仕様値はNVIDIAの設計上の最大値・構成値です。実際の処理性能は、アプリケーション、データ配置、メモリアクセス、コンパイラ、ネットワーク、電力設定、同時実行数によって変わります。NVIDIA Vera CPU製品ページ/Vera Performance Tuning Guide
GPUとの違い:Vera CPUが担う位置
Vera CPUはGPUの代替ではありません。NVIDIAは、Veraを、エージェント型AIで必要になるコード実行、ツール使用、サンドボックス、分析、データパイプライン、オーケストレーションなどのCPU処理を支えるものとして説明しています。GPUと組み合わせる構成では、VeraがETL、KVキャッシュ管理、オーケストレーションなどを担いながらGPUへデータを供給する位置付けです。NVIDIA Vera CPU製品ページ
たとえば、NVIDIA Vera Rubin NVL72は72基のRubin GPUと36基のVera CPUを統合するラックスケール構成として案内されています。CPU、GPUだけでなく、SuperNIC、DPU、ネットワーク、電力、冷却を含めて構成されるため、CPU単体のスペックだけで導入効果を判断しないことが重要です。NVIDIA Vera Rubin NVL72製品ページ
どの用途で検討しやすいか
候補になりやすい用途
- エージェント型AIの実行基盤:コード実行、ツール呼び出し、サンドボックス、評価ループを多数並列に扱う構成。
- 強化学習:学習器だけでなく、環境実行、ロールアウト、評価、データ処理の比重が大きい構成。
- 科学計算・HPC:気候・気象、分子動力学、流体解析など、CPUメモリ帯域とノード間通信を重視する構成。
- データ分析・データパイプライン:GPU処理の前後で大規模データの処理、変換、管理を行う構成。
ただし、AIエージェントを導入すべきかという業務上の判断と、Vera CPUのような基盤を採用すべきかというインフラ上の判断は分ける必要があります。AIエージェントの対象業務、固定ワークフローとの使い分け、人の確認地点は、AIエージェントとは?生成AI・チャットボット・RPAとの違いと導入判断・実践手順で整理しています。
先に別の選択肢を比較しやすいケース
- 少数の仮想マシンや一般的な業務アプリケーションが中心で、CPU、メモリ帯域、GPU供給が明確な制約になっていない場合
- 既存のx86向けバイナリ、ネイティブ拡張、商用ソフトウェア、監視製品への依存が強く、Arm対応状況を確認できていない場合
- 液冷、ラック電力、ネットワーク、ストレージ、保守体制を含む導入条件を満たせない場合
- 対象業務、評価データ、品質基準、必要な同時実行数がまだ決まっていない場合
x86環境から移行する前に確認すること
Vera CPUはArm互換です。NVIDIA HPC SDKの26.9リリースノートでは、Vera向けのターゲットプロセッサ指定、Vera向けNVIDIA Performance Libraries対応、Veraを含む高スレッド数ワークロード向けのOpenMPホストランタイム改善が案内されています。NVIDIA HPC SDK 26.9 Release Notes
一方で、既存のx86環境にあるすべてのアプリケーションや運用ツールの互換性を、この情報だけで判断することはできません。以下はMojiによる実務上の確認項目です。
- OS、コンテナイメージ、CI環境はaarch64向けに用意できるか
- Pythonのネイティブ拡張、数値計算ライブラリ、MPI、コンパイラはArm版を利用できるか
- 監視、バックアップ、EDR、ジョブスケジューラ、ライセンス製品は対象構成をサポートするか
- ソースから再ビルドできるか。本番環境で必要なベンダーサポートを受けられるか
- GPUと併用する場合、CUDA、ドライバー、NCCL、ネットワーク、ストレージを含む構成の検証手順を用意できるか
公式ベンチマークの読み方
NVIDIAは、OpenFOAMのmotorBike Large airflow simulationにおいて、Veraがx86システム比で1.9倍の性能、2.4倍の性能/ワットを示したと発表しています。また、Weather Research and Forecasting(WRF)については、x86比で1.6倍の性能向上、2倍のエネルギー効率向上を見込むと案内しています。これらはNVIDIAが示す特定ワークロード・特定構成での結果または見込みであり、自社環境での性能を保証する数値ではありません。NVIDIAの科学計算向け発表
たとえば、科学シミュレーションでは処理完了時間、スケーリング効率、消費電力が重要になる場合があります。一方、エージェント型AIでは、ツール実行の待ち時間、同時実行数、GPU待機時間、エラー率、評価処理の総時間が重要になる場合があります。公開ベンチマークは候補を絞る材料として使い、採用可否は自社に近い処理で判断してください。
提供予定・価格を確認する際の注意点
NVIDIAは、科学計算向けのVera CPUラックについて、Dell Technologies、HPE、Lenovo、Supermicroから2027年初頭より提供予定と発表しています。これはNVIDIA発表時点の予定であり、地域別の出荷時期、実際に選べる構成、保守条件、見積価格を確定する情報ではありません。NVIDIAの2026年11月16日発表
日本語のVera CPU製品ページは公開されていますが、調達を検討する場合は、対象OEMまたはNVIDIAの窓口に対して、国内で選べる構成、納期、冷却・電力条件、対応ネットワーク、保守範囲、ソフトウェアサポート、見積条件を個別に確認してください。
導入前に進める5ステップ
以下はNVIDIAの必須手順ではなく、Mojiによる実務上の提案です。
- 現状の制約を測定する
CPU使用率、GPU使用率、CPU待機、GPU待機、メモリ帯域、ストレージI/O、ネットワーク待機、ジョブのキュー時間を取得し、どこが処理時間を支配しているかを分けます。 - 比較する構成を分ける
Vera単体の1/2ソケット構成、Vera CPUラック、Vera RubinのようなGPU統合基盤を別の候補として扱います。CPU単価だけでなく、ネットワーク、冷却、ソフトウェア移行、保守を含めて比較します。 - Arm移行の互換性を検証する
本番アプリケーション、依存ライブラリ、コンテナ、監視、セキュリティ製品、商用ライセンスの対応可否を確認します。 - 設備条件を確認する
ラック、電力、液冷、ストレージ、ネットワーク、設置、交換部材、障害対応を含む運用条件を見積もります。 - 本番に近い処理で評価する
処理完了時間、p95待ち時間、スループット、GPU待機、エラー率、消費電力、運用工数、総コストを、同じ入力条件で比較します。
PoC評価シートの最小テンプレート
以下もMojiによる提案です。性能比較を印象だけで終わらせないため、検証開始前に評価条件を固定します。
項目 | 記入する内容 |
|---|---|
対象ワークロード | エージェントのコード実行、CFD、分子動力学、ETLなど。本番に近い処理名を明記する |
入力条件 | データ量、同時実行数、モデル、ツール数、ネットワーク条件、試行回数 |
品質条件 | 計算誤差、回答正確性、再現性、許容できない失敗 |
性能指標 | 処理時間、p50/p95待ち時間、スループット、CPU・GPU使用率、メモリ帯域 |
コスト範囲 | ハードウェア、電力、ネットワーク、移行、保守、運用人員のうち何を含めるか |
合否基準 | 現行値、測定期間、許容誤差、達成できない場合の判断をあらかじめ決める |
停止条件 | 互換性不足、設備条件未達、再現不能な差、運用コスト超過など |
AI基盤の選定では、公開ベンチマークの順位だけでなく、自社の入力、失敗例、品質条件、費用、運用条件で比較することが重要です。LLMやエージェントを併せて導入する場合は、LLM評価の進め方|モデル選定を導入判断につなげる比較基準・手順・チェックリストも参照してください。
まとめ
NVIDIA Vera CPUは、エージェント型AI、強化学習、データ分析、科学計算におけるCPU側の処理を対象に、メモリ帯域、並列実行、CPU・GPU間接続を重視して設計されたデータセンターCPUです。
導入を検討する際は、仕様値だけで決めず、CPU側が実際の制約になっているか、Arm移行の互換性を確保できるか、設備・ネットワーク条件を満たせるか、本番に近い処理で性能・電力・運用を含む総コストが見合うかを確認してください。科学計算向けラックは2027年初頭の提供予定とされているため、調達前にはOEMごとの構成、サポート範囲、国内での提供条件を最新情報で確認する必要があります。