生成AIプリンシプル・コードとは?対象企業・3原則・届出方法をわかりやすく解説【10月26日開始】
AI新規事業
AI新規事業のPoC・立ち上げ、何から始めるべきかご相談ください
要件定義からリリースまで、Mojiがワンチームで伴走します。

上杉 洸平事業開発・SEO/AIO担当
株式会社Moji ビジネス開発・コンテンツマーケティング担当 鹿児島県出身。大学2年次から複数のスタートアップで長期インターンを経験し、営業・事業開発と0→1の立ち上げに携わる。2026年9月より、生成AI特化の開発会社・株式会社Mojiに参画。AI開発プロジェクトの事業開発と運営体制づくりを担当しながら、自社メディアのコンテンツ運用をリードしている。
生成AIのプリンシプル・コードとは、生成AIを開発・提供する事業者に「学習データの概要開示」と「権利者・利用者からの照会への回答」を求める政府の基本原則です。
罰則はありませんが、2026年10月26日から内閣府への届出が始まり、届け出た企業の一覧が公表されます。
つまり「守ったかどうか」が取引先から見える状態になりました。AIを売る側は対応の判断を、AIを買う側はベンダー選定の基準づくりを、今から進める必要があります。
この記事のポイント
- 正式名称は「生成AIの適切な利活用等に向けた知的財産の保護及び透明性に関するプリンシプル・コード」。2026年8月25日に知的財産戦略本部が公表した
- 法的拘束力のないソフトロー。原則を実施するか、しないなら理由を説明する「コンプライ・オア・エクスプレイン」方式
- 対象は生成AIを「公衆に提供している」開発者・提供者。社内利用だけの企業や受託で開発工程の一部を担うだけの企業は原則対象外
- 他社のLLMを組み込んだSaaSを外部に提供している企業は、対象になる可能性が高い
- AIを導入する企業は対象外でも、ベンダーが届け出ているかを調達基準に組み込むのが現実的な対応
生成AIのプリンシプル・コードとは?
プリンシプル・コードは、生成AI事業者が自主的に取り組むべき「透明性の確保」と「知的財産権の保護」の原則をまとめた政府文書です。内閣府の知的財産戦略推進事務局が「AI時代の知的財産権検討会」での議論を経て策定し、2026年8月25日に知的財産戦略本部が公表しました。
目的は、生成AI技術の進歩と知的財産権の保護を両立させ、権利者と利用者が安心して生成AIを使える環境をつくることです。
罰則なしの「コンプライ・オア・エクスプレイン」方式
最大の特徴は、守らせるのではなく「守るか、守らない理由を説明するか」を事業者に選ばせる点です。上場企業向けのコーポレートガバナンス・コードやスチュワードシップ・コードと同じ手法で、法的拘束力も罰則もありません。
事業者が取れる選択肢は3つです。
- すべての原則を受け入れて実施し、内容を公表する(コンプライ)
- 一部の原則を実施せず、その理由を説明して公表する(エクスプレイン)
- そもそも受け入れを表明しない
どれを選んでも違反にはなりません。ただし3を選ぶと、内閣府が公表する届出事業者の一覧に名前が載りません。罰則の代わりに、取引先や市場の目で規律をかける設計です。
なぜ今、このルールができたのか
背景にあるのは、生成AIをめぐる知財トラブルの増加です。権利者が「自分の作品が学習に使われたか」を確かめる手段はこれまでほとんどなく、争うための材料すら手に入りませんでした。
プリンシプル・コードは著作権法を改正するものではありません。著作権法30条の4などのルールはそのままで、権利者や利用者が情報を得る経路を用意する補完的な仕組みです。「AI学習が違法になった」という理解は誤りなので注意してください。
公表から届出開始までの経緯
時期 | 出来事 |
|---|---|
2025年12月26日〜2026年1月26日 | 案(仮称)へのパブリックコメント |
2026年8月18日 | AI時代の知的財産権検討会(第13回)で案を了承 |
2026年8月25日 | 知的財産戦略本部が正式に公表 |
2026年9月8日 | 届出開始日と届出様式を公表 |
2026年10月23日 | 届出先と届出事業者一覧のページを公開 |
2026年10月26日 | 内閣府への届出受付を開始 |
知的財産戦略相は届出状況を確認し、必要に応じて原則の内容を見直す考えを示しています。今回の内容が最終形ではない点も押さえておきましょう。
企業のAI活用全体をどう統制するかは「AIガバナンスとは?経営者が導入可否を決める比較基準・7ステップ・チェックリスト」で詳しく解説しています。
プリンシプル・コードが定める3つの原則
3つの原則は「サイトでの概要開示」「権利者への回答」「利用者への回答」です。原則1は誰でも見られる場所での開示、原則2と3は条件を満たした照会に個別に答える仕組みです。
原則 | 求められること | 誰に向けたものか |
|---|---|---|
原則1:概要開示 | 学習データやモデルの概要、知財保護の取り組みをコーポレートサイト等で公開する | 誰でも |
原則2:権利者への回答 | 照会されたURL等が学習データに含まれるかを回答する | 訴訟・調停などの法的手続きを行う、または準備している権利者と代理人弁護士 |
原則3:利用者への回答 | 生成物と同一・類似のコンテンツのURL等が学習データに含まれるかを回答する | そのAIで生成物をつくった利用者本人 |
原則1:コーポレートサイトでの概要開示
開示の対象は大きく「透明性の確保」と「知的財産権の保護」の2つです。
- モデル関係:名称・バージョン、来歴、アーキテクチャ、利用規定、トレーニングの内容
- 学習データ関係:データの種類(RAGで使うものを含む)、ウェブクロールの有無、合成データの利用、クローラの名称と収集期間
- アカウンタビリティ:責任者の明示、意思決定の記録、トレーサビリティの確保
- 知財保護の措置:robots.txtやペイウォールを尊重するクローラの採用、海賊版サイトへのクロール回避、学習ログの一定期間保持、電子透かしやC2PAなどの来歴技術、権利者向け窓口の整備など
求められているのは学習データの全公開ではなく、あくまで「概要」です。営業秘密や安全性・セキュリティに関わる機微な情報の強制開示は求めない、と原則に明記されています。内閣府は項目ごとの記載例として「概要開示対象事項 具体例」も公開しています。
原則2:権利者からの照会への回答
法的手続きを準備している権利者が使うルートです。たとえば自作品が載ったページのURLを示し、「このドメインがクロール対象に含まれるか」を照会できます。
照会には、権利者である理由の提示、利用目的の明示と目的外に使わない誓約、照会するURL等の提示が必要です。提供者が自社で答えられない場合は、搭載しているモデルの開発者名を回答します。
原則3:利用者からの照会への回答
AIで何かを生成した利用者本人が使うルートです。自分の生成物とそっくりな作品を見つけたとき、生成物とプロンプト、そっくりな作品のURLを示して照会できます。
原則2との違いは、得た回答を訴訟や調停に使わないと誓約する点です。「自分の生成物が誰かの権利を侵害していないか」を確かめたい利用者のための仕組みといえます。
なお事業者は、照会の濫用を防ぐために手数料や回数制限を設けることも認められています。ただし照会をためらわせるほど高い設定は避けるよう求められています。
対象になる企業・ならない企業
対象は「生成AI事業者」、つまり生成AIを公衆に提供している開発者と提供者です。自社でモデルを開発していなくても、他社のAIを組み込んだサービスを外部に提供していれば「生成AI提供者」に当たります。
立場 | 定義 | 具体例 |
|---|---|---|
生成AI開発者 | 生成AIシステムを構築し、公衆に提供した者 | 基盤モデルを開発し、APIや一般向けサービスで公開している企業 |
生成AI提供者 | 生成AIをアプリや製品、業務プロセスに組み込んだサービスを公衆に提供した者 | 他社LLMを組み込んだSaaS、文章生成アプリ、画像生成サービス |
日本に拠点がない海外事業者も、日本向けにサービスを提供していれば対象です。一方で、次のフローで「対象外」に当たる企業は、原則として届出の対象になりません。
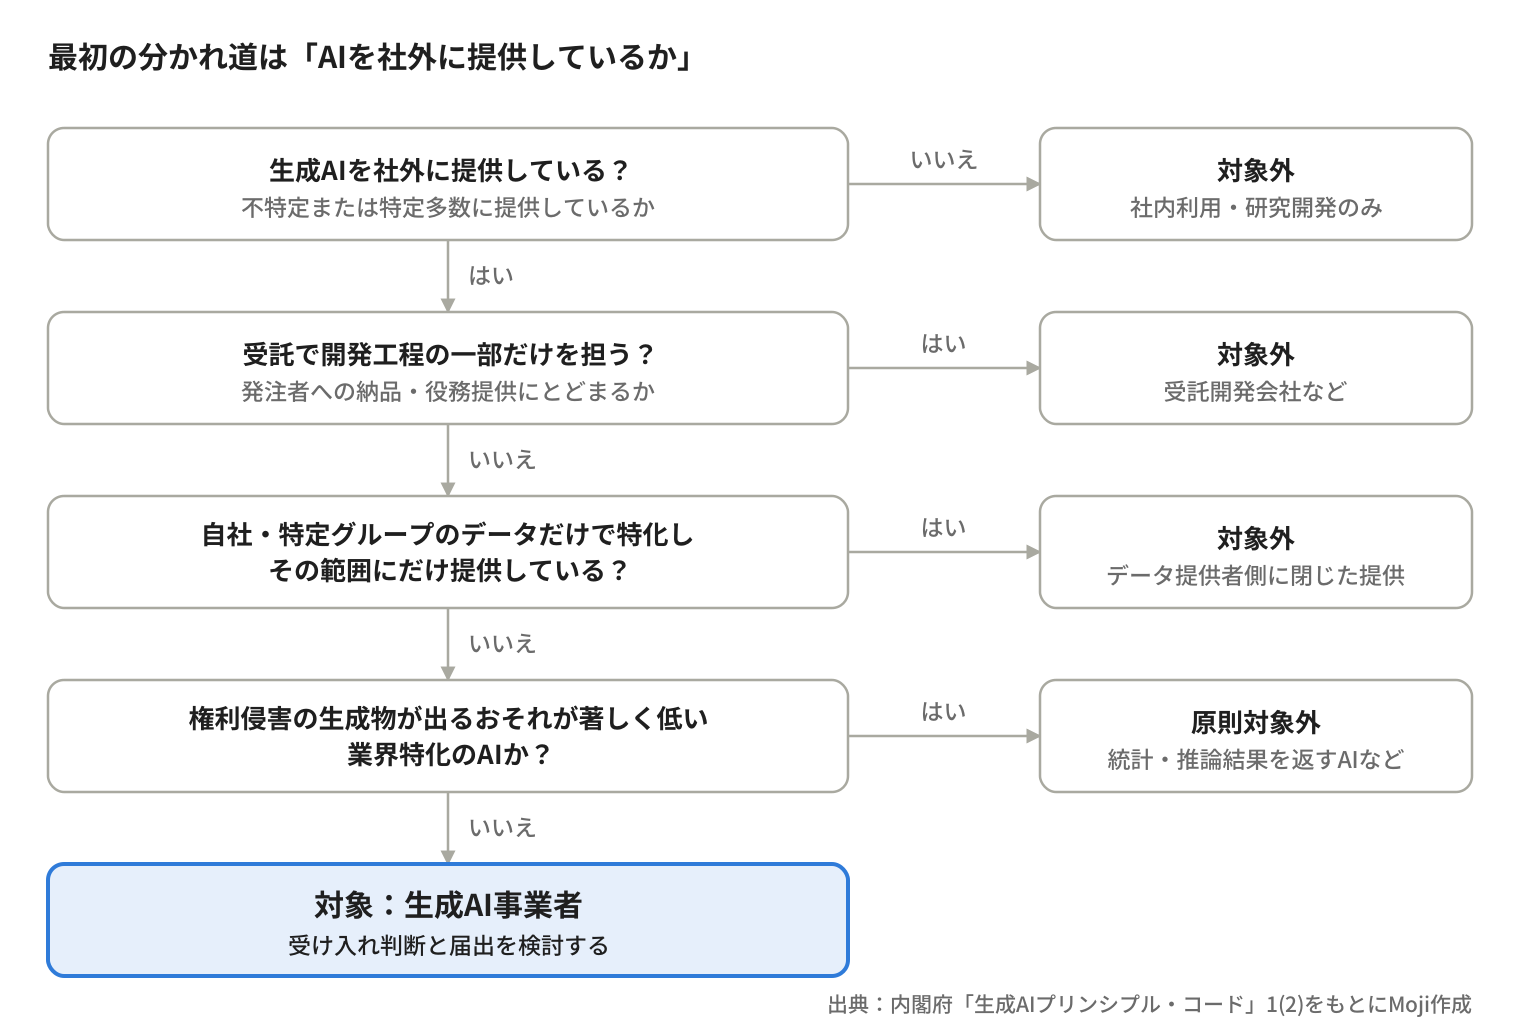
判定の軸は「誰のデータで作り、誰に提供したか」です。データ提供者とその指定範囲に閉じていれば対象外、業界横断で多くの企業に提供すれば対象になります。他社の汎用モデルをベースに業界特化AIをつくって複数社に売る場合は対象ですが、対応が求められるのは自社が付け加えた部分に限られます。
10月26日から始まった届出の流れ
届出は「自社サイトで公表してから、内閣府に様式を出す」の順番です。サイトでの公表が先にないと、届出をしても一覧に載りません。
- 自社のコーポレートサイト等で、各原則の受け入れ表明と実施事項を公表する(実施しない原則があればその理由も書く)
- 内閣府知的財産戦略推進事務局の所定様式で届け出る
- 事務局が事業の実態とサイトでの公表を確認し、届出事業者一覧に掲載する
- 原則として毎年、公表内容を見直して更新する(更新したらその旨も公表)
届出様式に書く項目
届出様式はA4一枚程度のシンプルなものです。
- 事業者名と代表者名
- 受け入れの担当者の氏名・役職と連絡先
- 受け入れ事項を公表したコーポレートサイト等のURL(複数あればすべて)
このうち一覧で公表されるのは事業者名とサイトのURLだけです。担当者の連絡先などは公表されません。
内閣府は内容を審査しない
注意したいのは、事務局が届出の中身を審査しない点です。サイトの公表内容がコードと合っているかの確認や、第三者からの照会への回答も行いません。
つまり「一覧に載った=政府のお墨付き」ではありません。公表した内容を、取引先や権利者が自分の目で評価する仕組みです。
AI事業者(ベンダー・SaaS企業)がやること
AIを提供する側がまず決めるべきは「対象か」「受け入れるか」の2点です。届出は10月26日に始まっただけで期限はないため、慌てて出すより社内で情報を揃えてから判断するほうが安全です。
優先度 | やること | ポイント |
|---|---|---|
高 | 対象かどうかを判定する | 公衆に提供しているか、自社データのみの限定提供か、受託の一部工程かを整理する。他社モデルを組み込んでいる場合は、自社が付加した部分の範囲を確定させる |
高 | 受け入れるかを決める | 見送りも選べる。毎年の見直しが前提なので、今回は見送って後から受け入れる判断もありうる |
高 | 利用規約を点検する | コードの原則を規約で制限する条項(オーバーライド条項)がある場合、その理由まで説明できるか確認する |
中 | 開示ページの骨子をつくる | モデル、学習データ、クローラ、アカウンタビリティ、知財保護の措置の順に、内閣府の「具体例」を参考に書く |
中 | 照会窓口を設ける | 原則2・3の受付窓口と、何を示せば受け付けるかの要件を決め、対応記録を残す運用にする |
中 | クローラと学習ログを棚卸しする | 自社クローラの名称・収集期間、robots.txtの尊重状況、ログの保持期間を洗い出す |
低 | 年1回の見直しを社内カレンダーに入れる | 責任者を決め、更新時の公表手順まで決めておく |
最も時間がかかるのはクローラと学習ログの棚卸しです。過去のログが残っていないと、照会に事実として答えられません。その場合は「いつまでに体制を整えるか」を含めて説明することになります。
受託開発で納品したAIはどう扱われるか
発注者から委託を受けて、開発工程の一部だけを担う会社は原則対象外です。一方で、納品したAIを発注者が外部に提供すれば、発注者側が「生成AI提供者」に当たる可能性があります。
受託開発会社は対象外でも、発注者から「開示に必要な情報を出してほしい」と求められる場面が増えるはずです。契約の段階で、学習データやモデルの情報を誰がどこまで管理するかを決めておくと後で困りません。
AIを導入する企業(情シス・法務)がやること
社内でAIを使うだけの企業は届出の対象外です。ただし「使っているAIの中身を説明できるか」は、ベンダーの対応次第で大きく変わります。調達する側として、次の4つを進めておきましょう。
- 利用中のAIツールを洗い出し、ベンダーが届出事業者一覧に載っているか照合する
- AIツールの稟議・調達チェック項目に「学習データの概要開示」「知財の照会窓口」「入力データの学習利用の有無」を追加する
- 社外に出す生成物について、既存作品との類似を確認するフローを決める
- 自社サイトのrobots.txtが、AIクローラに対して意図どおりに機能しているか点検する
出発点になるのは、社内で使っているAIを一覧にしておくことです。ツール名、ベンダー、用途、扱うデータを台帳にしておけば、一覧との照合も調達基準の運用もすぐにできます。台帳のつくり方は「AI利用台帳とは?導入判断・記載項目・運用手順を実務テンプレートで解説」で解説しています。
自社がAIを社外に出したら対象になる
注意したいのは、社内向けにつくったAIを他社にも販売・公開すると、自社が「生成AI提供者」になりうる点です。一方、自社のデータだけで特化させたチャットボットを自社の顧客にだけ提供するケースは、原則対象外の例として示されています。外部公開を決めた段階で、改めて対象かどうかを判定してください。
よくある失敗パターン
コードには「この説明では不十分」とされる例が具体的に書かれています。受け入れを表明するなら、次の3つは避けてください。
失敗パターン | なぜダメか | どうするか |
|---|---|---|
「体制が整っていない」とだけ書く | 説明として不十分とされる | 事業規模に応じて、体制構築の完了時期まで書く |
受け入れを表明しつつ、利用規約で開示範囲を絞る | 実質的に原則を実施していないとみなされる | 実施していない部分を別途エクスプレインする |
規約にオーバーライド条項があることを示すだけ | 条項の存在は理由にならない | なぜその条項を設けているかを説明する |
反対に、技術的に不可能な理由を根拠とともに示せば、エクスプレインとして認められます。またコードは、一部を開示しないことだけを理由に事業者を批判すべきではない、とも明記しています。
もう一つの失敗は「API経由で他社モデルを使っているだけだから対象外」という思い込みです。他社のLLMを組み込んだサービスを外部に提供していれば、自社で開発していなくても対象になりえます。
よくある質問
Q. 罰則がないなら、無視しても問題ありませんか?
法的には違反になりません。ただし届出事業者の一覧が公表されるため、名前がないことが取引先や権利者から見えます。企業向けにAIを販売している会社ほど、商談や調達審査で影響が出やすいと考えられます。
Q. 届出に期限はありますか?
期限はありません。10月26日は受付の開始日です。毎年の見直しが前提なので、まず見送り、準備が整ってから受け入れる判断も考えられます。
Q. 学習データをすべて公開しなければいけませんか?
いいえ。求められるのは種類や取得手段、クローラの名称といった概要です。営業秘密やセキュリティに関わる情報の強制開示は求めないと明記されています。
Q. 海外のAIベンダーも対象ですか?
日本向けにサービスを提供していれば、海外事業者も対象とされています。ただし拘束力はないため、実際に届け出るかは各社の判断です。一覧の掲載状況で確認するのが確実です。
Q. EUのAI規制法とは何が違いますか?
EUのAI Actは学習データの要約公開などを法的義務とし、制裁金もあります。日本のプリンシプル・コードは、開示するか、しない理由を説明するかを選ばせる仕組みです。EU向けの開示資料を整えている企業は、日本のコードにも流用しやすいでしょう。EU側の動きは「EN 18286とは?EU AI法の品質マネジメント規格をわかりやすく解説」も参考にしてください。
まとめ:まずは「対象か」の判定と社内の棚卸しから
生成AIのプリンシプル・コードは、罰則のないソフトローでありながら、学習データの開示と照会対応の「型」を政府が初めて示したルールです。10月26日の届出開始で、各社の対応が一覧として見えるようになりました。
- AI事業者は、自社が対象かを判定し、受け入れるかを決める
- 受け入れるなら、開示ページと照会窓口の設計、利用規約の点検から始める
- AIを導入する企業は、利用中のAIを台帳にまとめ、ベンダーの届出状況を調達基準に組み込む
届出に期限はありません。ただしクローラの運用記録や学習ログは、後からさかのぼって用意できない情報です。届け出るかどうかにかかわらず、社内の棚卸しだけは今日から始められます。
開示まで見据えたAI開発を相談したい方へ
Mojiでは、AIの受託開発を通じて、PoCから本番運用までを支援しています。学習データやモデル構成の記録など、プリンシプル・コードへの対応を見据えた設計についてもご相談いただけます。社内のAI利用を台帳化・可視化したい企業向けには「AI利用評価クラウド」も提供しています。
関連記事
- AIガバナンスとは?経営者が導入可否を決める比較基準・7ステップ・チェックリスト
- AI利用台帳とは?導入判断・記載項目・運用手順を実務テンプレートで解説
- AI監査とは?導入判断・評価との違い・実務手順とチェックリスト
- EN 18286とは?EU AI法の品質マネジメント規格をわかりやすく解説
出典
- 生成AIの適切な利活用等に向けた知的財産の保護及び透明性に関するプリンシプル・コード(内閣官房)
- プリンシプル・コードの受入れに係る届出様式(内閣府知的財産戦略推進事務局)
- AI学習方法の開示、26日から知財保護原則を適用(日本経済新聞)
- 生成AIプリンシプル・コードへの実務対応(森・濱田松本法律事務所)
- 生成AIプリンシプル・コードを踏まえ、生成AI事業者はいつまでに何を決めなければならないか(三浦法律事務所)