【Claude Haiku最新アップデート】Claude Haiku 5.5とHaiku 4.5を比較(2026年10月版)
AI新規事業
AI新規事業のPoC・立ち上げ、何から始めるべきかご相談ください
要件定義からリリースまで、Mojiがワンチームで伴走します。

上杉 洸平 事業開発・SEO/AIO担当
株式会社Moji ビジネス開発・コンテンツマーケティング担当 鹿児島県出身。大学2年次から複数のスタートアップで長期インターンを経験し、営業・事業開発と0→1の立ち上げに携わる。2026年9月より、生成AI特化の開発会社・株式会社Mojiに参画。AI開発プロジェクトの事業開発と運営体制づくりを担当しながら、自社メディアのコンテンツ運用をリードしている。
Claude Haiku 5.5は、Anthropicが2026年10月7日に公開した最新の小型モデルです。Haiku 4.5と同じ条件で36回測定した結果、正解の精度に差はなく、出力のクセと安定性に差が出ました。
この記事の結論
- 正解の精度は同じ:問い合わせ分類と議事録タスク抽出は、各モデル12件(合計24件)がすべて正解でした。
- 出力トークン数はタスクで逆転:要約は5.5が少なく(平均121対142)、分類は5.5が約1.8倍(122対67)です。
- 応答時間は要約・議事録で5.5が速い:要約は1.18秒対1.89秒、議事録は1.18秒対1.43秒です。
- 出力のクセが違う:5.5は見出しを付けず原文に忠実で、4.5は毎回見出しを付けて形式が安定しています。
Claudeシリーズの最新アップデートは、こちらでも解説しています。
Claude Haiku 5.5とは?
Claude Haiku 5.5は、要約・分類・データベース照会など、高頻度で大量に発生する処理向けの小型モデルです。
- 公開日:2026年10月7日
- API名:
claude-haiku-5-5 - 提供先:Claude Platform、Amazon Web Services、Google Cloud、Microsoft Azure
- 新機能:Haiku系で初めて、effort(コスト寄りか知能寄りかを選ぶ設定)を調整できる
- 入出力:入力はテキストと画像、出力はテキストのみ
- 位置づけ:能力はClaude Opus 5.5より低い。Anthropicの社内指数ではHaiku 5.5が167.11、Opus 5.5が174.56
SDKも更新され、コンピュータ操作とブラウザ操作のベータ対応が加わりました。上位モデルとの違いは、Opus 5.5の記事とSonnet 5.5の記事で解説しています。
出典:Unite.AI、LLM Stats(2026年10月9日確認)
Haiku 4.5からの変更点(公式情報)
Haiku 5.5の最大の変更は、入力のコンテキスト長が約5倍の100万トークンになり、effortを調整できるようになった点です。
項目 | Haiku 5.5 | Haiku 4.5 |
|---|---|---|
公開日 | 2026年10月7日 | 2025年10月15日 |
API名 |
|
|
入力のコンテキスト長 | 100万トークン | 約20万トークン |
最大出力 | 12.8万トークン | 6.4万トークン |
effortの調整 | 対応(Haiku系で初) | なし |
入力形式 | テキスト、画像 | テキスト、画像 |
知識のカットオフ | 2026年6月 | 2025年2月(信頼できる知識) |
コンテキスト長と最大出力のうち、5.5の値はLLM Stats、Haiku 4.5のコンテキスト長は複数の比較サイトの掲載値です。Anthropicのモデル一覧ページには、この項目の記載がありませんでした。料金は改定されています。最新の料金は公式の料金ページで確認してください。
出典:Anthropicモデル一覧、Unite.AI、LLM Stats、SD Times(Haiku 4.5公開日)
【実測】検証の条件
同じ入力・同じプロンプトで、Haiku 5.5とHaiku 4.5を各モデル18回、合計36回測定しました。
項目 | 内容 |
|---|---|
実施日 | 2026年10月9日 |
対象 | Haiku 5.5( |
呼び出し | Anthropic API(Messages API)をPythonスクリプトから実行 |
設定 | effortは指定せず、APIの既定。最大出力トークンは2,000 |
タスク | 記事要約、問い合わせ分類、議事録タスク抽出の3種 |
回数 | 各タスク2入力×3回。モデルごとに6回、合計36回 |
入力の長さ | 約100〜140トークンの日本語短文(検証用のダミーデータ) |
記録 | 入力・出力トークン数(APIが返した使用量)、応答時間、出力テキスト |
使ったプロンプトは次の3つです。
- 記事要約:「次の文章を3点の箇条書きで要約してください。」
- 問い合わせ分類:「次の問い合わせを「見積依頼 / 技術相談 / 採用 / 営業メール / その他」のいずれかに分類し、理由を1文で書いてください。JSONで {"category":..., "reason":...} の形式で返してください。」
- 議事録タスク抽出:「次の議事録から、担当者・期限・内容が分かるタスクを表形式で抽出してください。」
この検証の限界も、先に書いておきます。
- サンプルは小さく、統計的な結論ではなく「傾向」です。
- 入力は実業務のデータではなく、短いダミー文です。
- 応答時間はAPIの往復時間で、通信環境によって変わります。
- 出力の品質は、36件すべてを読んで判定しました。判定にはClaudeを使っています。
【実測】出力トークン数の違い
出力トークン数は、タスクによってHaiku 5.5とHaiku 4.5の大小が逆転しました。
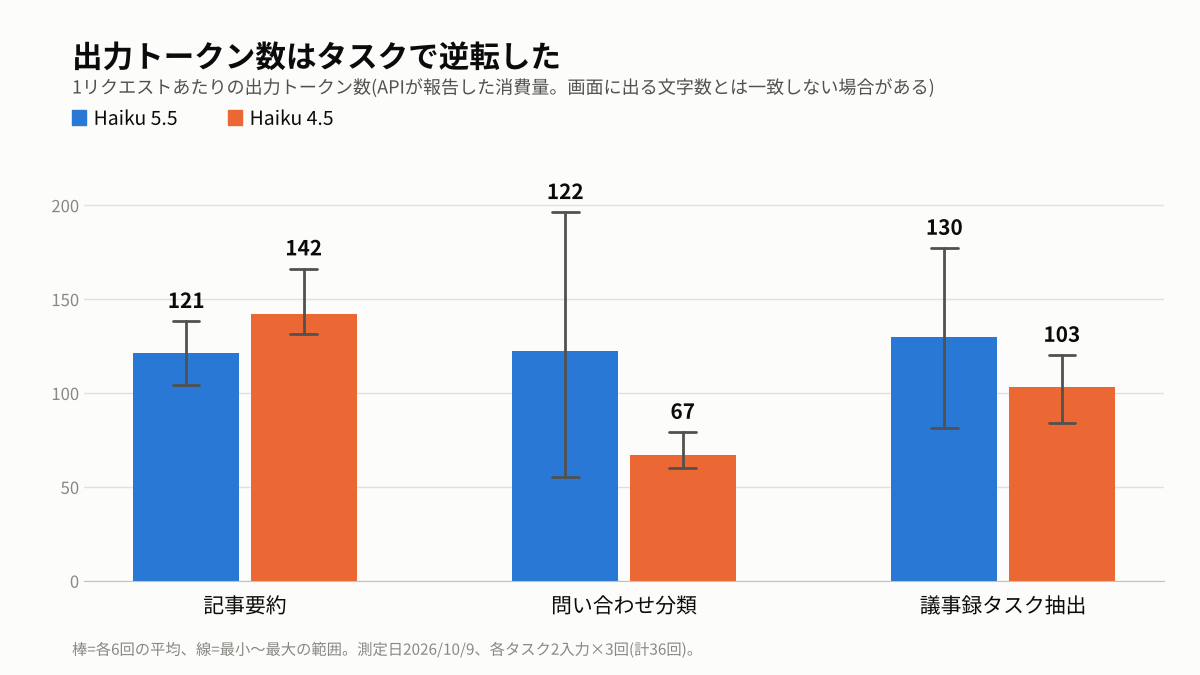
- 記事要約:5.5が平均121トークン、4.5が142トークン。5.5の方が約15%少ない。
- 問い合わせ分類:5.5が122トークン、4.5が67トークン。5.5が約1.8倍。
- 議事録タスク抽出:5.5が130トークン、4.5が103トークン。5.5が約1.3倍。
分類の差は、入力2件のうち片方に集中しています。入力1では、5.5が約60トークン、4.5が約71トークンで、ほぼ同じです。入力2では、5.5が約185トークン、4.5が約63トークンと、約3倍の差が出ました。
画面に出る文字数と、消費トークンが合わない
分類の入力2では、Haiku 5.5の出力が平均93字で、消費トークンは平均185でした。他のケースでは、文字数とトークン数がほぼ同じです(比で0.7〜1.0)。
- Haiku 5.5(分類・入力2):93字、185トークン
- Haiku 4.5(分類・入力2):94字、63トークン
画面に出ない処理のトークンが含まれている可能性があります。今回は出力の内訳を記録していないため、原因は特定できていません。
大量処理では、出力トークンが課金の対象になります。モデルを選ぶ前に、自社のタスクで消費トークンを測ることをおすすめします。
【実測】応答時間の違い
応答時間は、要約と議事録でHaiku 5.5が速く、分類ではほぼ同じでした。
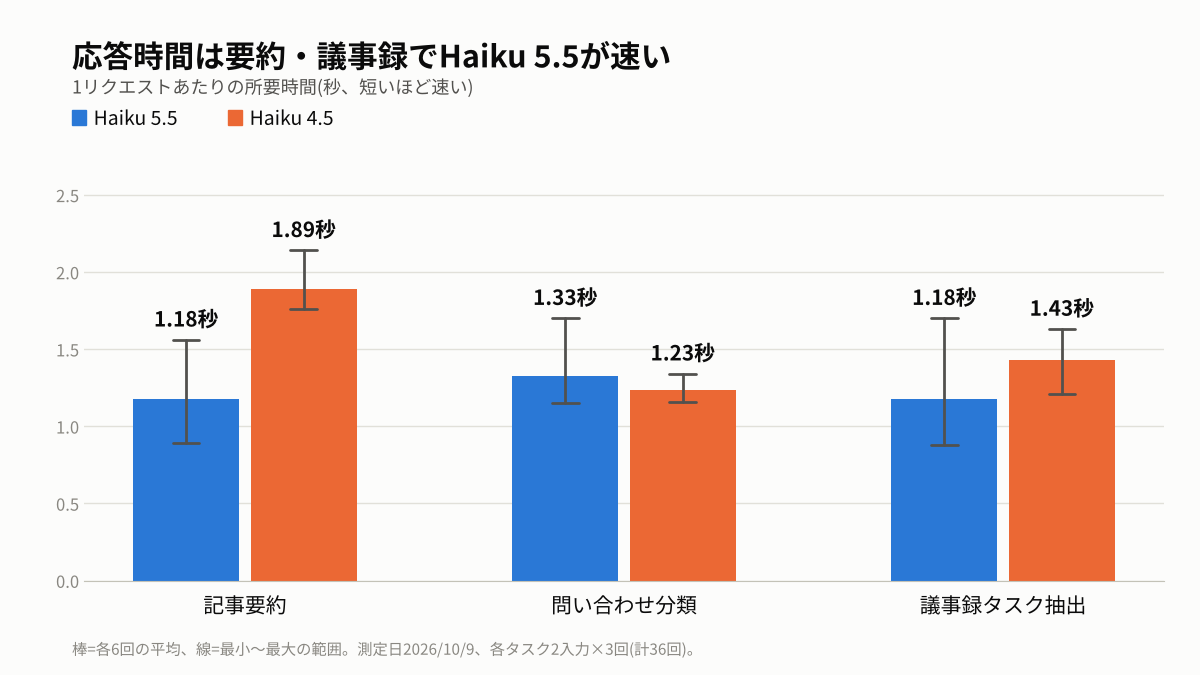
- 記事要約:5.5が1.18秒、4.5が1.89秒。5.5の方が約4割(38%)短い。
- 問い合わせ分類:5.5が1.33秒、4.5が1.23秒。こちらは4.5がやや速い。
- 議事録タスク抽出:5.5が1.18秒、4.5が1.43秒。5.5の方が約18%短い。
全体の平均は、5.5が1.23秒、4.5が1.52秒です。
分類の入力2では、出力トークンが約3倍になっても、所要時間は1.15〜1.35秒でした。このタスクの他の入力(1.21〜1.70秒)と変わりません。トークン数が増えても、時間が比例して伸びるとは限りません。
Anthropicが掲載した顧客コメントでは、Boxが初期テストでHaiku 4.5よりレイテンシが約半分と報告しています(Unite.AI)。今回の検証では、最大で約4割の短縮でした。応答時間はAPIの往復時間で、通信状況で変わります。各タスク6回の平均で、差は目安として見てください。
【実測】出力の品質の違い
正解の精度に差はありませんでした。差が出たのは、書式・注記・原文への忠実さという、出力のクセです。
観点 | Haiku 5.5 | Haiku 4.5 |
|---|---|---|
分類の正解(各モデル6件) | 6/6 | 6/6 |
議事録の担当者・期限の抽出(各モデル6件) | 6/6 | 6/6 |
要約の見出し付与 | 0/6 | 6/6 |
議事録の見出し付与 | 0/6 | 6/6 |
議事録の前置きの一文 | 4/6 | 0/6 |
議事録の補足・注記 | 2/6 | 0/6 |
分類のJSONのコードブロック | 5/6 | 6/6 |
要約に、原文にない補足が混じる | 略語の注釈のみ(PoC→概念実証) | あり(6件中2件を確認) |
要約:5.5は原文に忠実、4.5は整えて補う
Haiku 5.5は、見出しなしで3点の箇条書きを返しました。6件すべて、原文にない主張は加えていません。PoCの略語に「概念実証」と注釈を付けた程度です。入力2では、3回中2回が同一の文面でした。
Haiku 4.5は、毎回「# 要約」「# 文章の要約」など、違う見出しを付けました。太字のラベルを付けて整えていますが、原文にない補足も混じりました。
- 「小さな業務から始めることで、リスクを低減しながら実装を進めている」(原文に「リスク」の記述はない)
- 「上位モデルは複雑な推論が得意だが、小型モデルより処理コストと時間がかかる」(原文にはコストと時間の記述はない)
分類:どちらも全問正解、差はコードブロック
「見積依頼」「技術相談」の分類と理由は、どちらも妥当でした。差は、返す形式です。Haiku 4.5は6件すべて、JSONをコードブロックで囲んだ、改行入りの形で返しました。Haiku 5.5は6件中5件がコードブロック付きで、1件は素のJSONでした。
プログラムでそのまま読み込む場合は、どちらのモデルでもコードブロックの除去が必要です。
議事録:5.5は注記が付くことがあり、ブレる
担当者・期限・内容の抽出は、どちらも全件正確でした。ここで、差が最もはっきり出ました。
Haiku 5.5は、入力2の3回中2回で、表の後に注記を付けました。この注記は実務で役立ちます。
- 「議事録の「リーダー」は指示を出した立場で、具体的な担当者は明示されていません。期限は「金曜」「土曜」と曜日のみの記載のため、具体的な日付は議事録からは特定できません。」(5.5の出力より)
一方で、同じ入力で3回目は注記なしの表だけでした。この入力での出力トークンは177、172、81と、最大約2倍の差が出ています。
Haiku 4.5は6件すべて、見出しと表だけでした。トークン数も入力2では84〜92と安定しています。
品質の判定は、各タスク2入力×3回の小さなサンプルです。傾向として読んでください。
どちらを選ぶべきか(用途別の判断軸)
要約を大量に回すならHaiku 5.5、出力形式の安定を最優先するならHaiku 4.5が合います。分類や抽出は精度が同じなので、消費トークンと出力のクセで選びます。
用途 | おすすめ | 根拠 |
|---|---|---|
記事・文書の要約を大量に回す | Haiku 5.5 | 実測で、出力が約15%少なく、応答が約4割速い |
問い合わせの分類(JSONで返す) | どちらでも(トークン重視なら4.5) | 実測で、精度は同じ。5.5は入力によって消費が約3倍になる例があった |
議事録などの抽出を自動処理する | 形式の安定重視なら4.5 | 実測で、4.5は見出しと表だけ。5.5は前置きや注記が付くことがあった |
曖昧さの指摘(日付が曜日だけ、担当不明など)がほしい | Haiku 5.5 | 実測で、5.5は注記で指摘した(6件中2件) |
長い文書を一度に処理する | Haiku 5.5 | 公式スペックで、入力のコンテキスト長が100万対約20万トークン(未検証) |
コスト寄り・知能寄りを切り替えたい | Haiku 5.5 | 公式スペックで、effortを調整できる(今回は未検証) |
「未検証」と書いた行は、今回の測定で確かめていません。公式スペックからの判断です。
選ぶ前の注意
- Anthropicのシステムカードでは、Haiku 5.5はテスト対象のモデルの中で過剰拒否が最も多いと開示されています(Unite.AIの報道より)。拒否が大量処理に影響する用途では、自社データで確認してから切り替えます。
- 今回の検証は、短いダミー文の小さなサンプルです。自社のタスクで同じ検証をすると、判断の精度が上がります。
上位モデルを含めた選び方は、Opus 5.5とOpus 5の比較とSonnet 5.5とSonnet 5の比較で解説しています。GPT-6 Sol・Lunaとの比較は、Claude Opus 5.5とGPT-6 Sol・Lunaはどっちを使う?をご覧ください。
よくある失敗パターン
モデルを切り替えるときの失敗は、精度ではなく、出力の形と量の違いから起きます。今回の実測で起きたことから、四つを挙げます。
失敗 | 実測で起きたこと | 対策 |
|---|---|---|
JSONをそのまま読み込んでエラーになる | 分類で、5.5は5/6、4.5は6/6がコードブロック付きで返した | コードブロックを除去する処理を入れる |
単価だけで選び、消費トークンを測らない | 分類の入力2で、5.5の消費が4.5の約3倍(185対63)になった | 自社のタスクで、消費トークンを先に測る |
同じ入力なら同じ出力になると思う | 議事録の入力2で、5.5の出力が177、172、81トークンとぶれた(注記の有無) | 「表のみ返す」と指示を固定する(今回は未検証) |
要約をそのまま使う | 4.5の要約に、原文にない補足が混じった(6件中2件) | 「原文にない内容は加えない」と指示し、重要な要約は人が確認する |
対策のうち「未検証」と書いたものは、今回の測定で効果を確かめていません。自社のデータで試してから採用してください。
まとめ
Claude Haiku 5.5は、正解の精度がHaiku 4.5と同じで、出力のクセと安定性が違うモデルです。
- 要約を大量に回す:Haiku 5.5。出力が約15%少なく、応答が約4割速い。
- 出力形式の安定を最優先する:Haiku 4.5。見出しと表だけで、トークン数も安定している。
- どちらでも迷う分類・抽出:自社のデータで、消費トークンと出力の形を先に測る。
モデル選定は、公式スペックではなく、自社タスクでの実測で決めます。今回の36回の測定は、その考え方の一例です。
他のClaudeの記事はこちら!
- Claude Opus 5.5とOpus 5を比較(2026年9月版)
- Claude Sonnet 5.5とSonnet 5を比較(2026年9月版)
- Claude Opus 5.5とGPT-6 Sol・Lunaはどっちを使う?料金・ベンチマーク・用途別の選び方
AIモデルの選定・検証のご相談
Mojiは、生成AIの導入・開発を支援しています。モデル選定や、自社タスクでの検証のご相談は、Mojiのサイトからお問い合わせください。
参考情報
- Anthropic Releases Claude Haiku 5.5 (Unite.AI)
- Claude Haiku 5.5: Benchmarks, Pricing & Context Window (LLM Stats)
- Models overview (Anthropic)
- Anthropic releases Claude Haiku 4.5 (SD Times)
この記事の情報は2026年10月9日時点です。